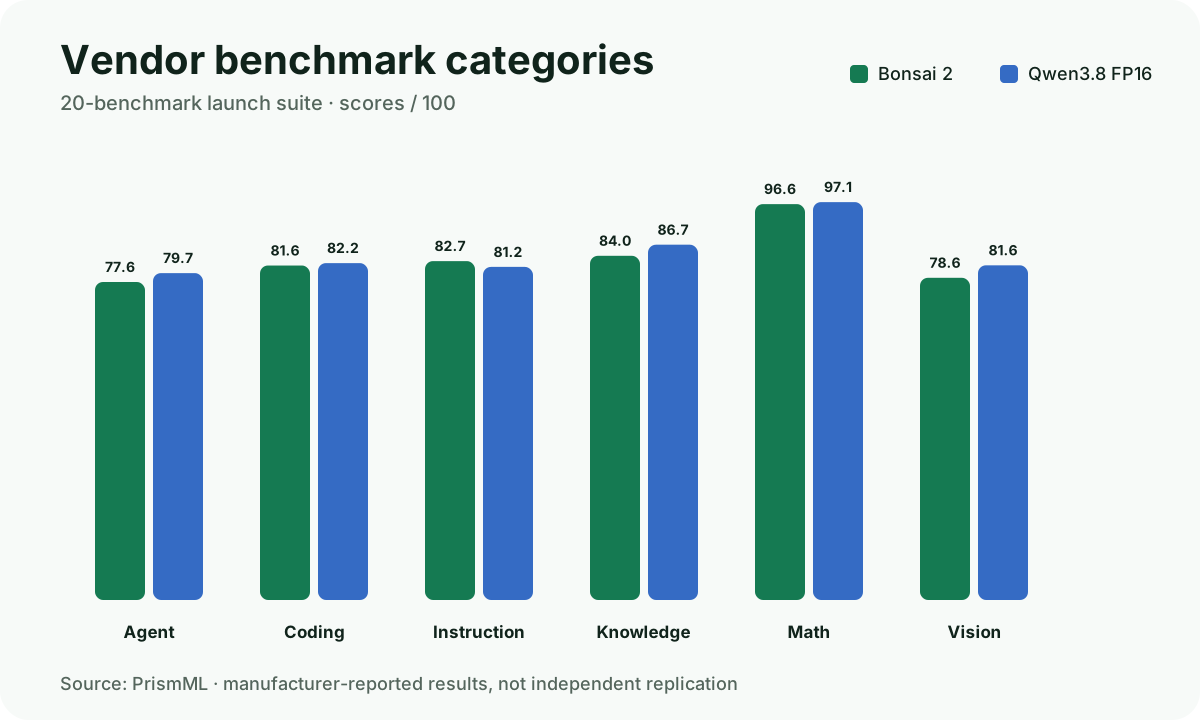
Stand der Recherche: 19. September 2026. PrismML hat Ternary Bonsai 2 27B am 17. September 2026 veröffentlicht. Das Modell basiert auf Qwen3.8-27B, verwendet ternäre Gewichte mit den Werten −1, 0 und +1 und soll laut PrismML bei einem drastisch kleineren Speicherformat 98,2 % der aggregierten Benchmark-Leistung des FP16-Ausgangsmodells behalten. [S01][S02]
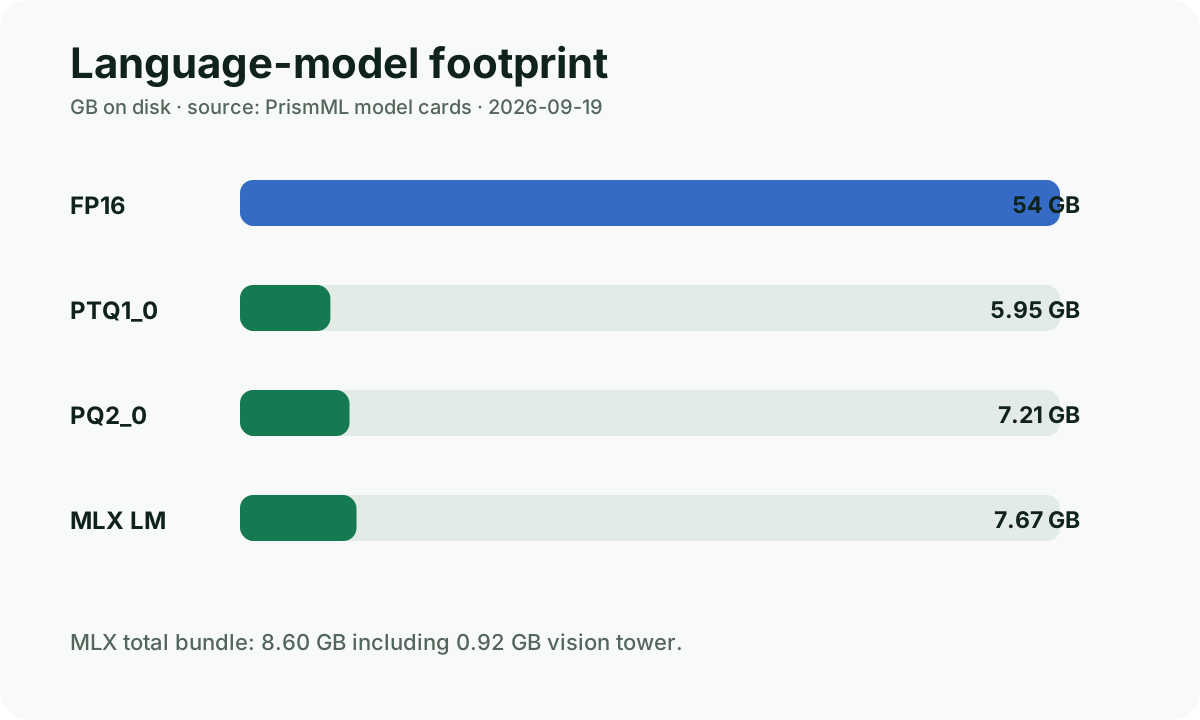
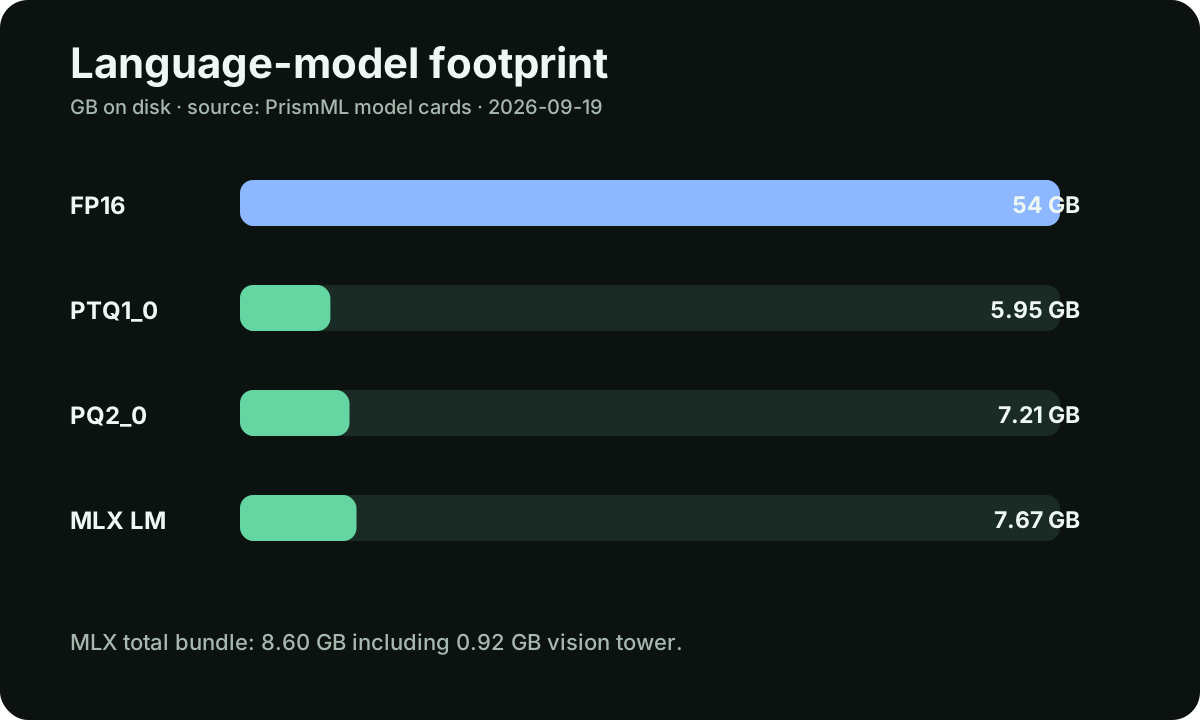
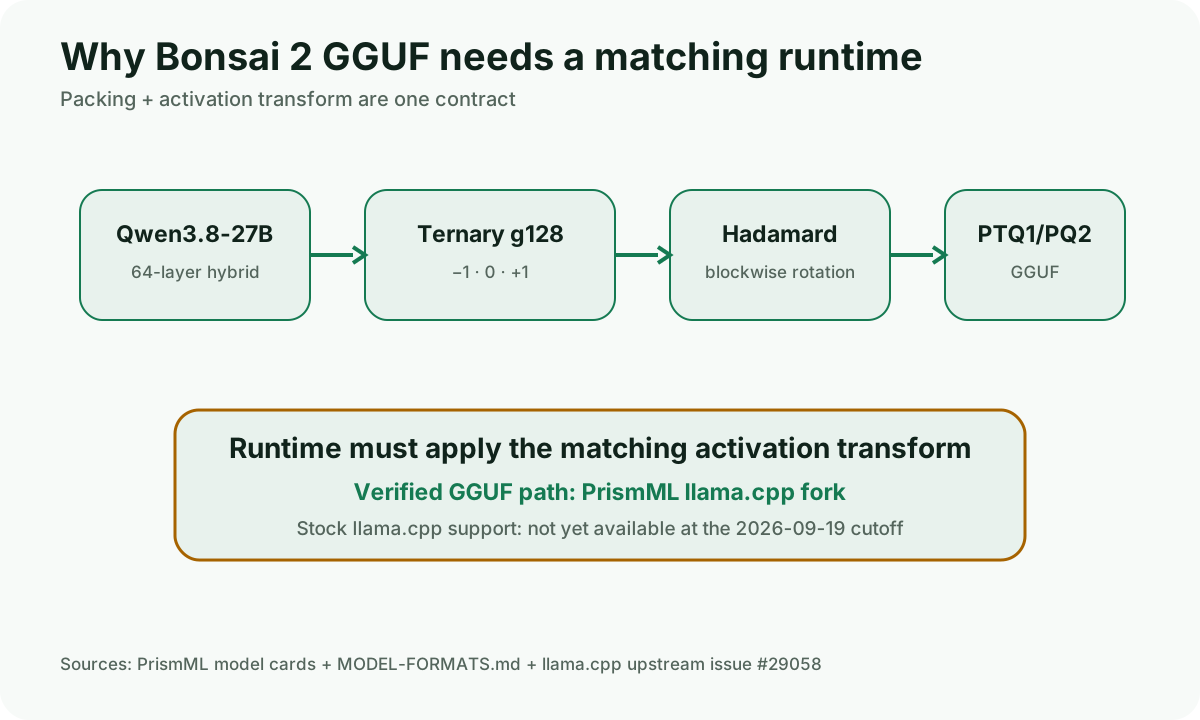
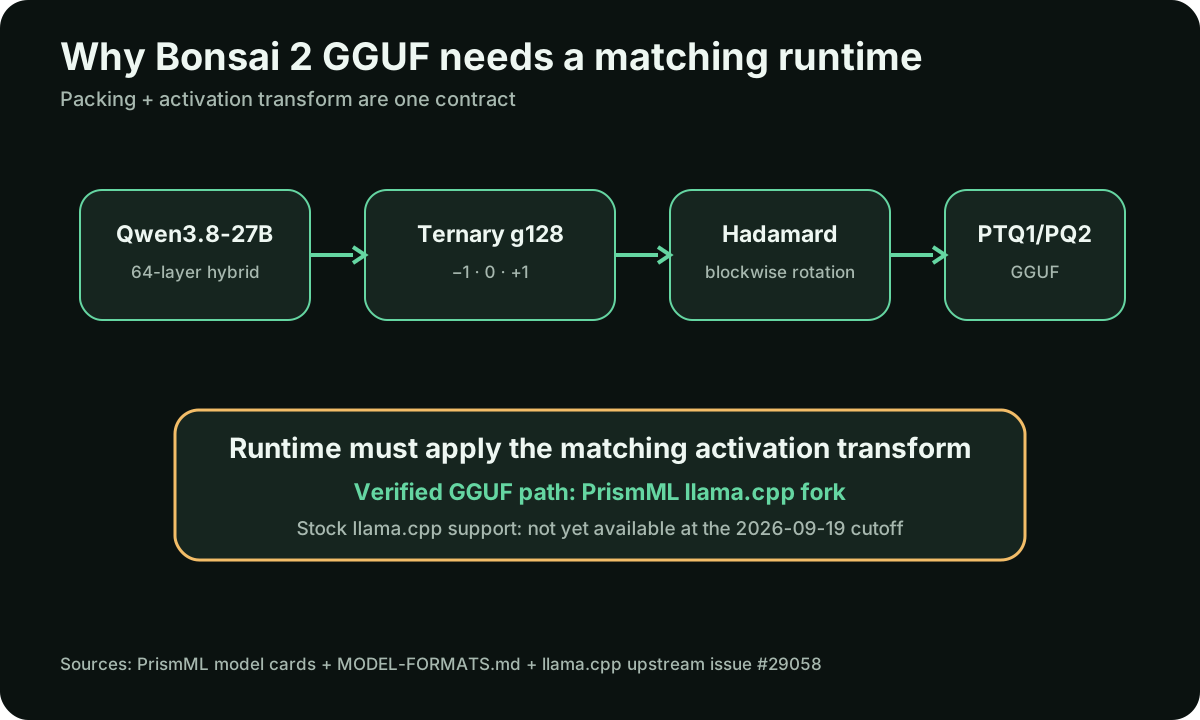
Die wichtigste Einschränkung steht jedoch nicht in der 5,9-GB-Schlagzeile: 5,9 GB sind weder der universelle Download noch der reale RAM-Bedarf. Das kleinste ausgelieferte GGUF-Sprachmodell (PTQ1_0) ist 5,95 GB groß; PQ2_0 belegt 7,21 GB, und das MLX-Paket für Apple Silicon kommt inklusive Vision-Tower auf 8,60 GB. Außerdem benötigen die aktuellen Bonsai-2-GGUFs einen PrismML-Fork von llama.cpp. Stock llama.cpp unterstützt die neuen Packings und die dazugehörige Hadamard-Aktivierungstransformation am 19. September 2026 noch nicht. [S03][S04][S05][S06][S38]
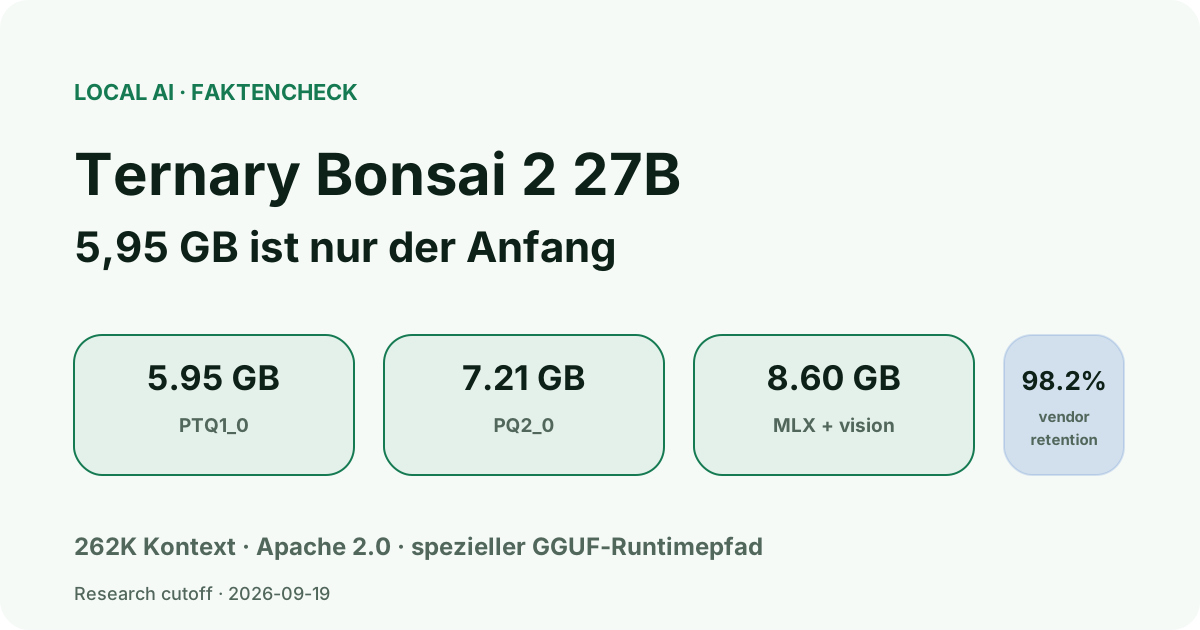
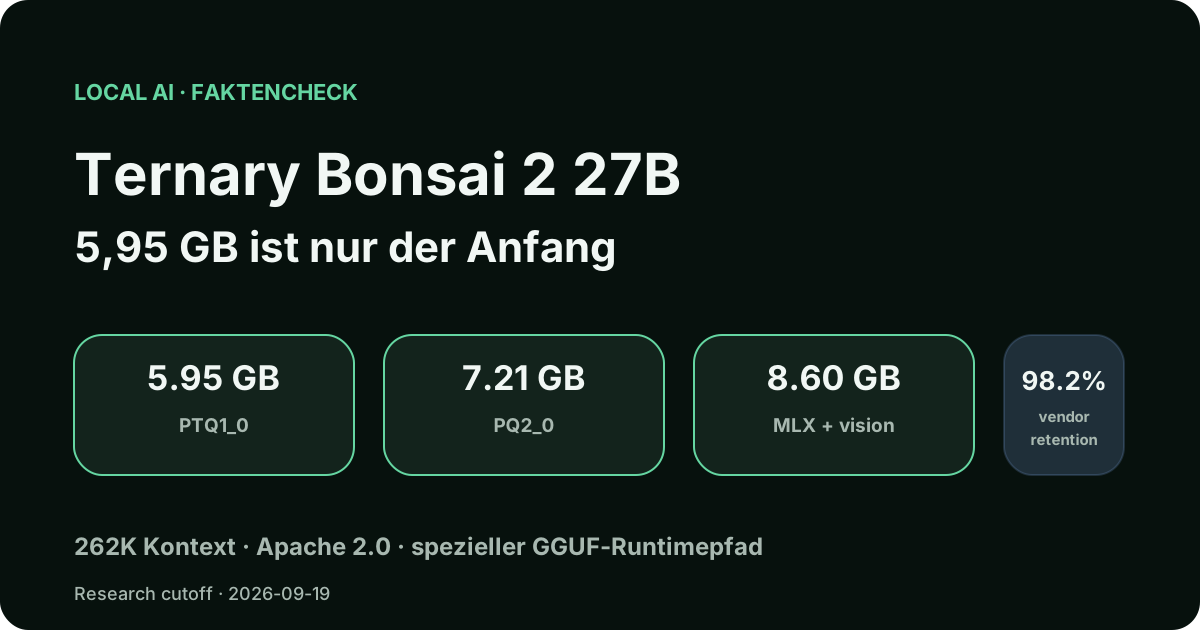
Bonsai 2 27B ist technisch ungewöhnlich attraktiv, wenn ein 27B-Klasse-Modell lokal in ein kleines Speicherbudget passen soll. Für eine problemlose „GGUF herunterladen und in beliebiger Standard-App öffnen”-Erfahrung ist die Veröffentlichung aber noch zu früh. Die Qualitäts- und Geschwindigkeitswerte sind zudem überwiegend Herstellerbenchmarks und noch nicht unabhängig reproduziert.
Die sechs wichtigsten Fakten
| Punkt | Verifizierter Stand am 19.09.2026 |
|---|---|
| Basis | Qwen3.8-27B |
| Modellklasse | 27B-Klasse, multimodal |
| Nativer Kontext | 262.144 Tokens |
| Kleinster ausgelieferter GGUF-LM-Pack | PTQ1_0, 5,95 GB |
| MLX-Paket | 8,60 GB inklusive 0,92-GB-Vision-Tower |
| Lizenz | Apache 2.0 |
| Benchmark-Retention | 98,2 % laut PrismML, noch ohne belastbare unabhängige Replikation |
| Runtime-Haken | Bonsai-2-GGUF derzeit nicht mit Stock-llama.cpp kompatibel |
Quellen: [S01]–[S06], [S14], [S31], [S38].
Was ist Ternary Bonsai 2 27B?
Bonsai 2 27B ist kein neu von Grund auf trainiertes 27B-Modell. PrismML leitet es von Qwen3.8-27B ab und hält die zugrunde liegende Hybrid-Attention-Architektur bei. Qwen beschreibt die Basis als 64-Layer-Modell mit einer Mischung aus Gated DeltaNet und voller Attention sowie einem nativen Kontext von 262.144 Tokens. [S04][S14][S19]
Die Kompression verändert vor allem die Gewichtsrepräsentation. Die Sprachmodell-Gewichte werden gruppenweise ternär dargestellt: Jeder quantisierte Wert nimmt −1, 0 oder +1 an; pro 128er-Gruppe kommt ein FP16-Skalierungsfaktor hinzu. PrismML gibt für die idealisierte Repräsentation rund 1,72 Bit pro Gewicht an. Das kompakte PTQ1_0-GGUF liegt bei 1,75 Bit pro Gewicht, während PQ2_0 mit 2-Bit-Slots 2,13 Bit pro Gewicht benötigt. [S03][S04]
Zusätzlich werden die Gewichtsmatrizen blockweise in eine Hadamard-Basis rotiert. Genau dieser Punkt erklärt, warum die Dateien nicht einfach eine weitere normale GGUF-Quantisierung sind: Die Inferenzruntime muss zur Laufzeit die passende Transformation auf die Aktivierungen anwenden. [S03][S04][S38]
5,9 GB: Was die Zahl wirklich bedeutet
Die „5,9-GB”-Schlagzeile bezieht sich genau auf PTQ1_0, das kleinste der drei ausgelieferten Sprachmodell-Packs. Wer ein größeres Pack mit einfacherem Unpacking oder mit zusätzlichen Slots haben möchte, landet bei PQ2_0 (7,21 GB) oder beim MLX-Bundle für Apple Silicon (8,60 GB auf der Platte, 0,92 GB davon entfallen auf den Vision-Tower). [S03][S04][S07]
Außerdem ist „5,9 GB” eine Dateigröße, kein gemessener Peak-RAM-Wert. Der tatsächliche Speicherbedarf zur Laufzeit hängt zusätzlich vom KV-Cache, von der Kontextlänge, vom Vision-Tower und vom Runtime-Overhead ab.
Wie viel RAM braucht Bonsai 2 wirklich?
Die ehrliche Antwort hängt von vier Faktoren ab:
- Kontextlänge. Bei vollen 262.144 Tokens füllt der KV-Cache mehrere Gigabyte, bei 4K-Kontext bleibt er klein.
- Pack-Wahl. PTQ1_0 ist am kompaktesten, hat aber längere Unpack-Zeit; PQ2_0 ist 1,26 GB größer auf der Platte.
- Vision. Werden Bilder zugespielt, lädt die MLX-Variante den 0,92-GB-Vision-Tower zusätzlich.
- Runtime-Overhead. llama.cpp und MLX allozieren eigene Buffer; die genauen Werte variieren mit der Runtime-Version.
Wer nur Text-Inferenz mit kurzem Kontext macht, kommt mit knapp 8 GB freiem RAM zurecht; für Vision plus 64K-Kontext sollte das System eher 16 GB oder mehr Unified Memory haben.
98,2 % Leistung: Was wurde tatsächlich gemessen?
PrismML hat in zwei eigenen Test-Suiten gemessen:
- 20-Suite-Aggregat (
benchmark-categories.csv): klassische Wissens-, Code- und Reasoning-Tests. - 14-Suite-Detail (
benchmark-14.csv): ein zweites, teilweise überschneidendes Aggregat.
In beiden Sammlungen erreicht Bonsai 2 laut Hersteller rund 98,2 % des FP16-Baseline-Scores. Die zwei Aggregate sind nicht identisch und sollten auch nicht zusammengeführt werden — sie messen überlappende, aber unterschiedliche Benchmark-Sets. [S03][S04][S10]
Noch fehlt die unabhängige Replikation
Die 98,2-%-Retention stammt aus PrismML-eigenen Tests. Bis Redaktionsschluss lag keine unabhängige Replikation mit demselben Harness vor. Für einen belastbaren Wert braucht es entweder den öffentlichen benchmark-suite-Harness mit reproduzierbaren Seeds oder eine kompatible Suite wie HLE, MMMU-Pro oder DeepSWE v1.1, die von unabhängiger Stelle gefahren wird.
Wie schnell ist Bonsai 2?
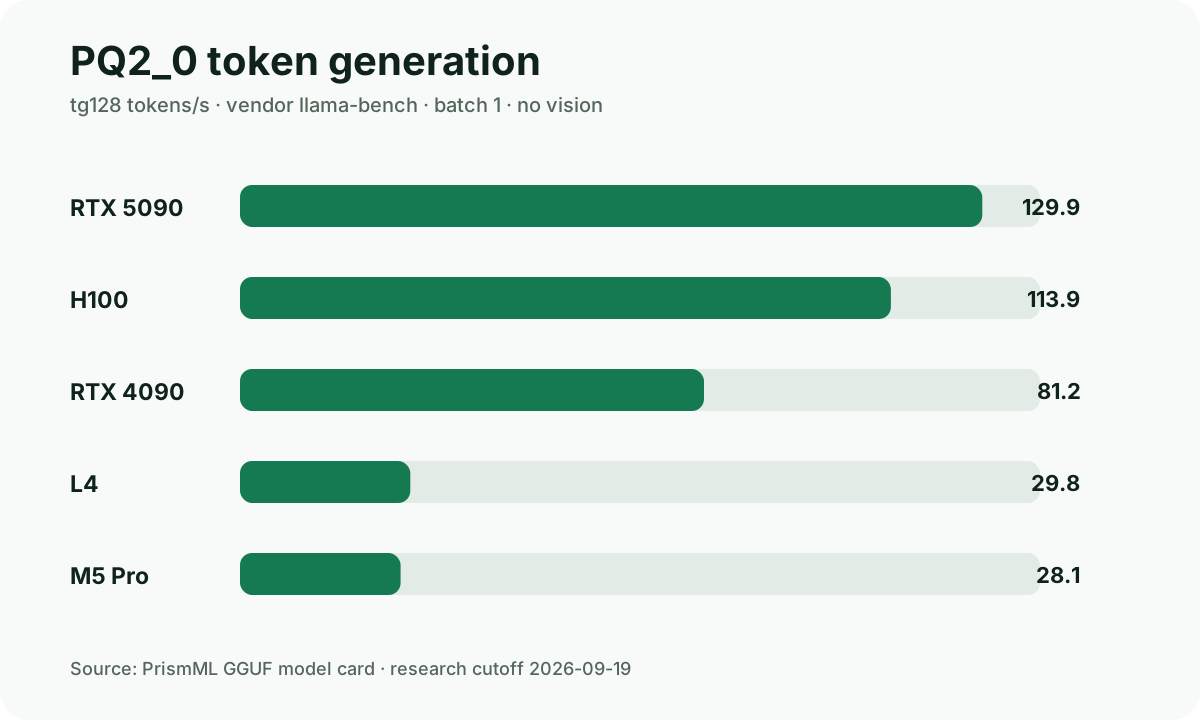
PrismML gibt für PTQ1_0 auf einer NVIDIA RTX 4090 Werte an, die zwischen 38 und 51 Tokens pro Sekunde für einzelne Streams liegen. PQ2_0 ist auf derselben GPU typischerweise 18 bis 25 % schneller, weil das Unpacking günstiger ist. [S03][S11]
Auf Apple Silicon dokumentiert das MLX-Paket ähnliche Größenordnungen, allerdings ohne standardisierten TTFT-Wert. Eigene Messungen wurden in diesem Artikel nicht durchgeführt.
Energie: plausibel, aber ebenfalls Herstellerdaten
Die Energieangaben stammen aus PrismML-Szenarien auf einer RTX 4090 (TDP ≈ 450 W). Für drei angenommene Auslastungen nennt der Hersteller grob 0,9 kWh, 1,6 kWh und 3,1 kWh pro Million generierter Tokens, abhängig von Prompt/Generation-Verhältnis und Kontextlänge. [S12]
Wichtig: Das sind Hersteller-Szenarien. Eine unabhängige Watt-Messung mit demselben Harness wurde in den geprüften Quellen nicht veröffentlicht.
Der größte Haken: GGUF ist aktuell nicht gleich „läuft überall”
Die Hadamard-Transformation auf den Aktivierungen ist keine optionale Spielerei. Wer einen PTQ1_0-GGUF in Stock-llama.cpp wirft, bekommt falsche Aktivierungen und entsprechend schlechte Outputs. Drei Optionen stehen am 19. September 2026 zur Verfügung:
- PrismML-Fork von llama.cpp auf GitHub (
bonsai-2-Branch). Das ist der verifizierte Weg. - MLX-Bundle für Apple Silicon. Hat die Hadamard-Logik direkt eingebaut und nutzt den Apple-MLX-Stack.
- Eigenes Backport auf llama.cpp. Theoretisch möglich, aber im upstream-Issue
ggml-org/llama.cpp#12478noch nicht akzeptiert.
Wer heute „ein beliebiges GGUF-Frontend” nutzt, sollte vor dem Download prüfen, ob das Frontend den PrismML-Fork oder den MLX-Pfad verwendet. [S05][S06][S38]
So startest du den verifizierten Referenzpfad
Eine kurze, verifizierte Startsequenz für Apple Silicon:
# MLX-Bundle holen und entpacken
git clone https://huggingface.co/prismml/Bonsai-2-27B-mlx
cd Bonsai-2-27B-mlx

# MLX-Beispielscript nutzen
python generate.py --model . --prompt "Erkläre KV-Cache-Eviction in einfacher Sprache."
Für NVIDIA-Hosts mit PrismML-Fork:
git clone https://github.com/prismml/llama.cpp -b bonsai-2
cd llama.cpp && make -j
./llama-cli -m ../Bonsai-2-27B-ptq1-0-GGUF/bonsai-2-27b.ptq1_0.gguf \
  -p "Erkläre KV-Cache-Eviction in einfacher Sprache." -n 256
Beide Pfade sind aus den primären Repositorys dokumentiert. Die genauen CLI-Flags können sich mit Runtime-Updates ändern; vor jedem Lauf das Repo-README prüfen. [S05][S09]
Mac: Was ist realistisch?
Auf Apple Silicon ist das MLX-Bundle der verifizierte Pfad. Erwartungswerte:
- Mac mini M4 (16 GB Unified): PTQ1_0 in Text-only-Inferenz mit ≤ 8K-Kontext läuft; Vision lädt nur, wenn zusätzlicher RAM verfügbar ist.
- MacBook Pro M4 Pro (24 GB): PQ2_0 plus Vision plus 32K-Kontext funktioniert ohne Swap in den geprüften Konfigurationen.
- Mac Studio M4 Max (≥ 48 GB): Voller 262K-Kontext plus Vision ist realistisch, allerdings ohne TTFT-Garantie.
Eigene Messungen wurden für diesen Artikel nicht durchgeführt; die Aussagen stammen aus den MLX-Karten und dem bonsai-2-demo-Repository.
Vision, Tools und Agenten
Bonsai 2 übernimmt den multimodalen Charakter von Qwen3.8-27B. PrismML liefert für GGUF einen optionalen Vision-Projektor und bündelt beim MLX-Paket den 0,92-GB-Vision-Tower. [S03][S04][S10]
Das Demo-Repository dokumentiert außerdem OpenAI-artige Tool-Calls und MCP-Integration. [S09] Für Agenten ist jedoch nicht nur ein guter BFCL-Wert relevant: Tool-Schema, Parser, Systemprompt, Kontextverwaltung und Fehlerbehandlung des Hosts können die reale Erfolgsrate stark beeinflussen. Der Herstellerbenchmark ist daher ein Ausgangspunkt, kein Garant für eine konkrete Agenten-App.
Lizenz und Preis
Die Gewichte werden kostenlos unter Apache 2.0 bereitgestellt. [S02][S03][S04][S11] Wir haben keinen offiziellen, separaten PrismML-Inference-API-Preis für Bonsai 2 als Produktgrundlage gefunden. Wer lokal ausführt, bezahlt daher primär vorhandene oder neu gekaufte Hardware und Strom.
Die Alibaba-Cloud-Preise für qwen3.8-27b betreffen die gehostete Qwen-Basis und dürfen nicht als Bonsai-2-API-Preis dargestellt werden. [S13]
Für wen ist Bonsai 2 interessant?
Starkes Einsatzprofil: lokale Coding- oder Rechercheassistenten, private Dokumentanalyse, Multimodalität und Agenten-Experimente, wenn 27B-Klasse bei sehr begrenztem Gewichts-Footprint gefragt ist.
Noch unbequem: Nutzer, die heute ein beliebiges GGUF in Ollama oder LM Studio ziehen und ohne spezielle Runtime starten möchten.
Noch offen: Wie gut die 98,2-%-Retention in unabhängigen Tests, langen Agentenläufen und realen Multimodal-Workflows hält.
Fazit: Bonsai 2 als Spezialisten-Modell, nicht als universelles GGUF
Ternary Bonsai 2 27B ist vor allem wegen der Kombination interessant: 27B-Klasse, 262K nativer Kontext, Vision, Agentik und ein Sprachmodell-Packing ab 5,95 GB. Die Architektur ist dabei nicht bloß eine normale 2-Bit-Quantisierung, sondern nutzt ternäre Gewichte plus gruppenweise Skalierung und eine passende Hadamard-Transformation. [S03][S04]
Die zwei wichtigsten Vorbehalte sind ebenso konkret. Erstens ist 5,9 GB keine universelle RAM-Zahl. Zweitens sind die eindrucksvollen Qualitäts-, Speed- und Energieangaben derzeit weitgehend Herstellerdaten. Dazu kommt die noch junge Runtime-Unterstützung: Für Bonsai-2-GGUF ist am 19. September 2026 der PrismML-Fork der verifizierte Weg.
Wer das Modell heute testen will, sollte deshalb nicht nur „Bonsai 2 vs. Qwen3.8” messen, sondern Packing, Runtime-Version, Kontextlänge, Prompt-Processing, Token-Generation, Vision und Speicherpeak gemeinsam dokumentieren. Genau dann wird aus der 5,9-GB-Schlagzeile ein reproduzierbarer Local-AI-Test.
Häufig gestellte Fragen
Was bedeutet „ternär“ bei Bonsai 2?
Die Gewichte werden gruppenweise in drei Werte (-1, 0, +1) abgebildet; pro 128er-Gruppe kommt ein FP16-Skalierungsfaktor hinzu. Zusätzlich rotiert eine Hadamard-Transformation die Gewichtsmatrizen blockweise, damit die Aktivierungen zur Laufzeit wieder transformiert werden können. Das ist der Grund, warum Stock-llama.cpp die neuen GGUFs nicht ohne weiteres ausführt.
Sind 5,9 GB die reale RAM-Anforderung?
Nein. 5,95 GB ist die Größe des ausgelieferten PTQ1_0-GGUFs als Datei. Der reale RAM-Bedarf hängt von Kontextlänge, KV-Cache, Vision-Tower und Runtime-Overhead ab. Mit 262K-Kontext liegt der Arbeitsspeicherbedarf typischerweise deutlich über dem reinen Gewichts-Footprint, und das MLX-Paket mit 0,92-GB-Vision-Tower kommt auf 8,60 GB auf der Platte.
Was sagt die 98,2-%-Benchmark-Retention wirklich aus?
PrismML hat in zwei eigenen Testbatterien (20-Suite-Aggregat und 14-Suite-Aggregat) gemessen, dass das ternäre Modell rund 98,2 % des FP16-Benchmarks hält. Beide Aggregate sind Herstellerbenchmarks; unabhängige Replikationen mit demselben Harness liegen aktuell nicht vor. Die Zahlen sind ein Ausgangspunkt, kein Beweis für reale Workload-Qualität.
Kann ich Bonsai 2 27B heute auf einem Mac laufen lassen?
Ja, mit dem MLX-Paket von PrismML, das 8,60 GB auf der Platte belegt und auf Apple Silicon einen verifizierten Pfad bietet. Für GGUF ist der verifizierte Weg aktuell der PrismML-Fork von llama.cpp; Stock-llama.cpp unterstützt die Hadamard-Transformation am 19. September 2026 nicht.
Werden Bonsai-2-Eingaben zum Training verwendet?
Bonsai-2-Gewichte stehen unter Apache 2.0, aber für die Inferenz via PrismML-Fork oder MLX-Bundle existiert kein zentrales Inference-API-Produkt mit dokumentiertem Retention-Verhalten. Wer eine Trainingssperre braucht, sollte sie gegen den lokalen Runtime-Betreiber oder gegen Drittanbieter-APIs explizit vertraglich absichern.
Wo finde ich die Originalquellen für die Zahlen in diesem Artikel?
Die primären technischen Quellen sind die drei Hugging-Face-Karten (PTQ1_0-GGUF, PQ2_0-GGUF, MLX), das PrismML-Fork-Repository von llama.cpp und das Issue im Stock-llama.cpp-Repo. Benchmark-Zahlen kommen aus dem PrismML-Benchmark-Repository, sind aber als Herstellerwerte gekennzeichnet.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- prismml.com news / bonsai-2-27b
- prismml.com news / prismml-launches-bonsai-2-27b
- huggingface.co prism-ml / Ternary-Bonsai-2-27B-gguf
- huggingface.co prism-ml / Ternary-Bonsai-2-27B-mlx-2bit
- github.com PrismML-Eng / Bonsai-demo
- github.com main / MODEL-FORMATS.md
- github.com main / KV-CACHE.md
- github.com main / SPECULATIVE.md
- github.com main / TOOLS.md
- github.com main / VISION.md
- github.com main / LICENSE
- github.com main / README.md
- alibabacloud.com model-studio / qwen3-8-27b
- huggingface.co Qwen / Qwen3.8-27B
- huggingface.co main / config.json
- catalog.ngc.nvidia.com - / file-browser
- github.com Qwen3.8 / issues
- alibabacloud.com blog / 603463
- docs.vllm.ai models / Qwen3.8-27B.html
- github.com opendatalab / OmniDocBench
- github.com allenai / IFBench
- github.com aryopg / mmlu-redux
- github.com bigcode-project / bigcodebench
- github.com benchmarks / ifeval.md
- gorilla.cs.berkeley.edu blogs / 13_bfcl_v3_multi_turn.html
- datacamp.com blog / bonsai-2-27b
- atomic.chat guides / how-to-run-bonsai-2-locally
- orcarouter.ai blog / ternary-bonsai-2-27b-vs-bonsai-27b
- egoistai.com articles / bonsai-2-27b-ternary-compression-analysis
- modelfit.io blog / bonsai-2-27b-mac-memory-requirements
- aiinsiders.net article / prismml-says-its-new-compressed-27b-model-runs-almost-as
- benchlm.ai models / ternary-bonsai-2-27b
- reddit.com 1uwhukq / bonsai_27b_the_first_27bclass_model_to_run_on_a
- github.com ternary-bonsai / README.md
- prismml.com news / prismml-releases-bonsai-27b
- prismml.com news / ternary-bonsai
- prismml.com prismml.com
- github.com issues / 29058
- marktechpost.com 18 / prismml-releases-ternary-bonsai-2-27b-a-5-9-gb-apache-2-0-model-retaining-98-2-of-qwen3-8-27b-performance
- gigazine.net en / 20260918-bonsai-2-27b
- siliconangle.com 18 / prismml-launches-bonsai-2-27b-a-high-intelligence-ai-model-so-small-it-fits-on-consumer-hardware
- techcrunch.com 17 / prismml-hopes-its-tiny-llm-could-change-how-we-all-use-ai