Stand: 18. September 2026. Technische Recherche mit Quellenangaben; Herstellerbenchmarks und eigene Berechnungen sind jeweils gekennzeichnet.
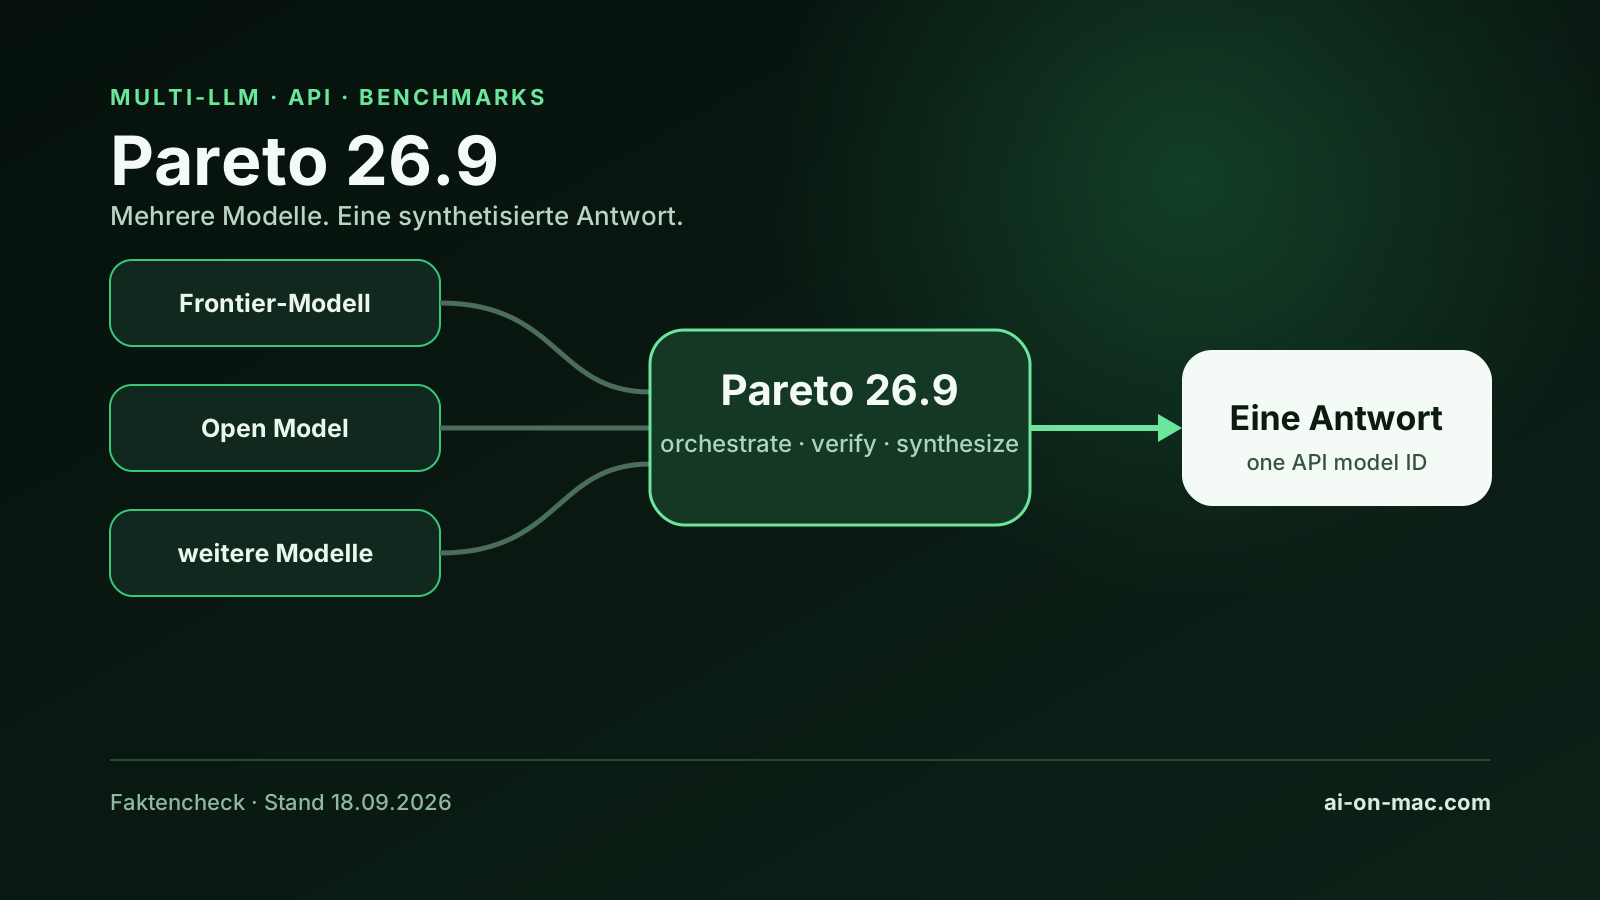
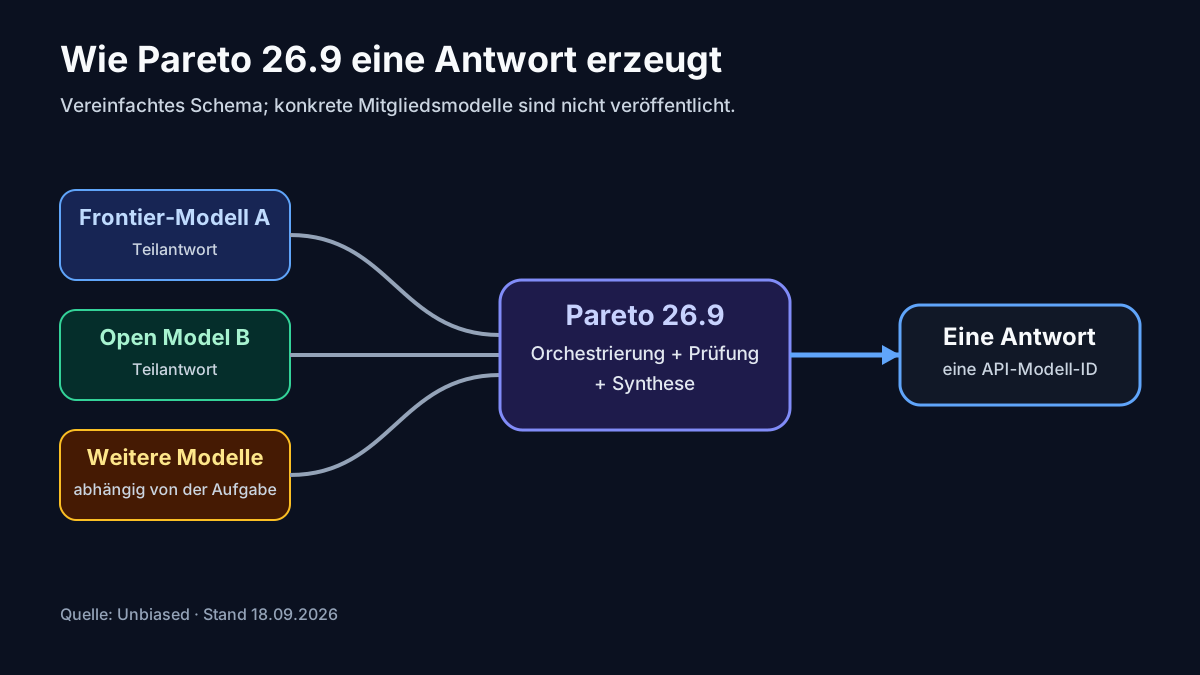
unbiased/pareto sieht nach außen wie ein einzelnes KI-Modell aus. Technisch ist Pareto 26.9 jedoch kein gewöhnliches Foundation Model mit einem festen Satz Modellgewichte. Unbiased beschreibt Pareto als proprietäres „blended AI model“: Mehrere zugrunde liegende LLMs bearbeiten eine Anfrage, anschließend werden ihre Ergebnisse zu einer einzigen Antwort synthetisiert. Diese Beschreibung steht nicht nur im Marketing, sondern auch in den Nutzungsbedingungen des Anbieters. (Unbiased)
Die aktuelle Version Pareto 26.9 wurde am 17. September 2026 mit einer neuen Preis- und Benchmarkkarte veröffentlicht. Der direkte Unbiased-Tarif beträgt 2,50 US-Dollar pro Million Input-Tokens, 0,25 Dollar pro Million gecachter Input-Tokens und 7,50 Dollar pro Million Output-Tokens. (Circuit & Chisel)
Die wichtigsten Einschränkungen vorweg: Die fünf öffentlich beworbenen Pareto-Werte stammen derzeit von Unbiased selbst. Der Benchmark-Harness ist zwar öffentlich und reproduzierbar, doch für 26.9 liegt noch keine vollständige unabhängige Reproduktion vor. Auch gemessene Kosten pro Benchmark-Aufgabe und ein Composite Score wurden für 26.9 ausdrücklich noch nicht veröffentlicht. (GitHub)
Die wichtigsten Fakten
| Merkmal | Pareto 26.9 |
|---|---|
| Anbieter | Unbiased / Circuit & Chisel |
| Typ | proprietäres Multi-LLM-/Blended-System |
| Direkte Modell-ID | pareto |
| OpenRouter-ID | unbiased/pareto |
| Input | Text, Bilder |
| Output | Text laut OpenRouter |
| Preis Input | $2,50 / 1 Mio. Tokens |
| Cached Input | $0,25 / 1 Mio. Tokens |
| Output | $7,50 / 1 Mio. Tokens |
| Kontext | 262.144 Tokens laut OpenRouter; derzeit nicht von Unbiased auf der Model Card spezifiziert |
| Self-hosting | keine veröffentlichten Pareto-Gewichte |
| Benchmarkwerte | fünf Werte von Unbiased veröffentlicht |
| Prüfstand | 18. September 2026 |
Unbiased bestätigt Text- und Bildeingabe sowie pareto als direkte Modellkennung. OpenRouter dokumentiert für das zuvor als Union Alpha geführte System ein 262.144-Token-Kontextfenster und Textausgabe. Wichtig ist die Quellenhierarchie: 262K ist derzeit eine OpenRouter-Angabe und keine auf der aktuellen Unbiased-Model-Card veröffentlichte Kernspec. (Unbiased)
Von Union Alpha zu Pareto 26.9
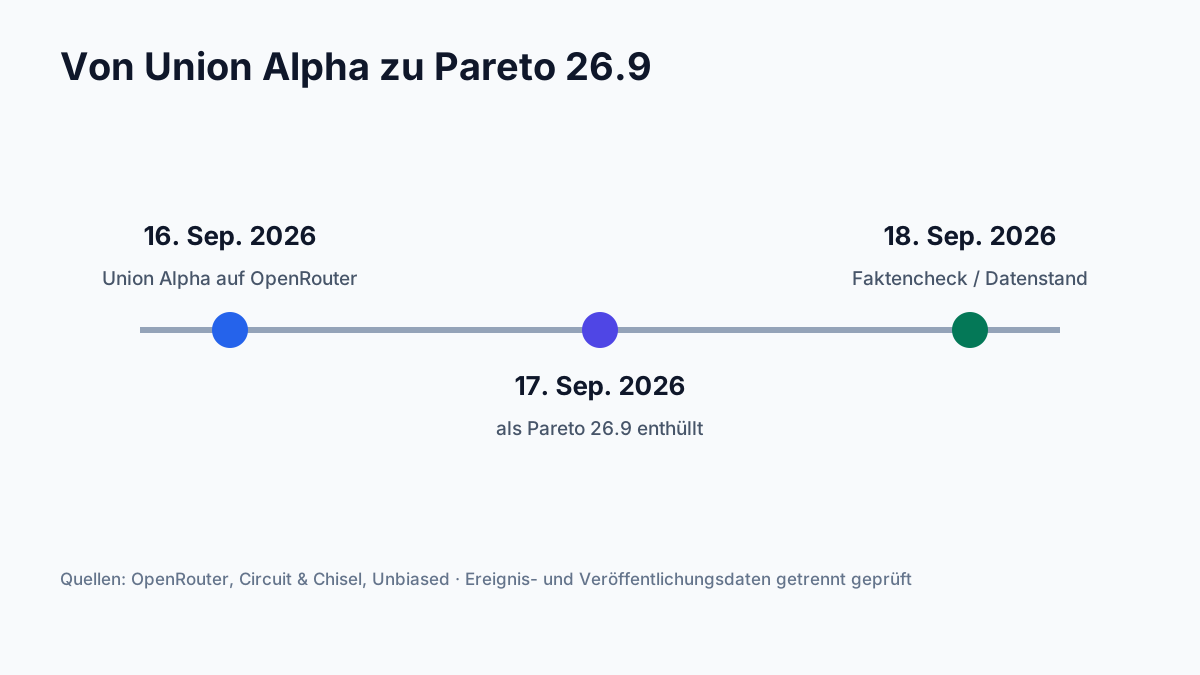
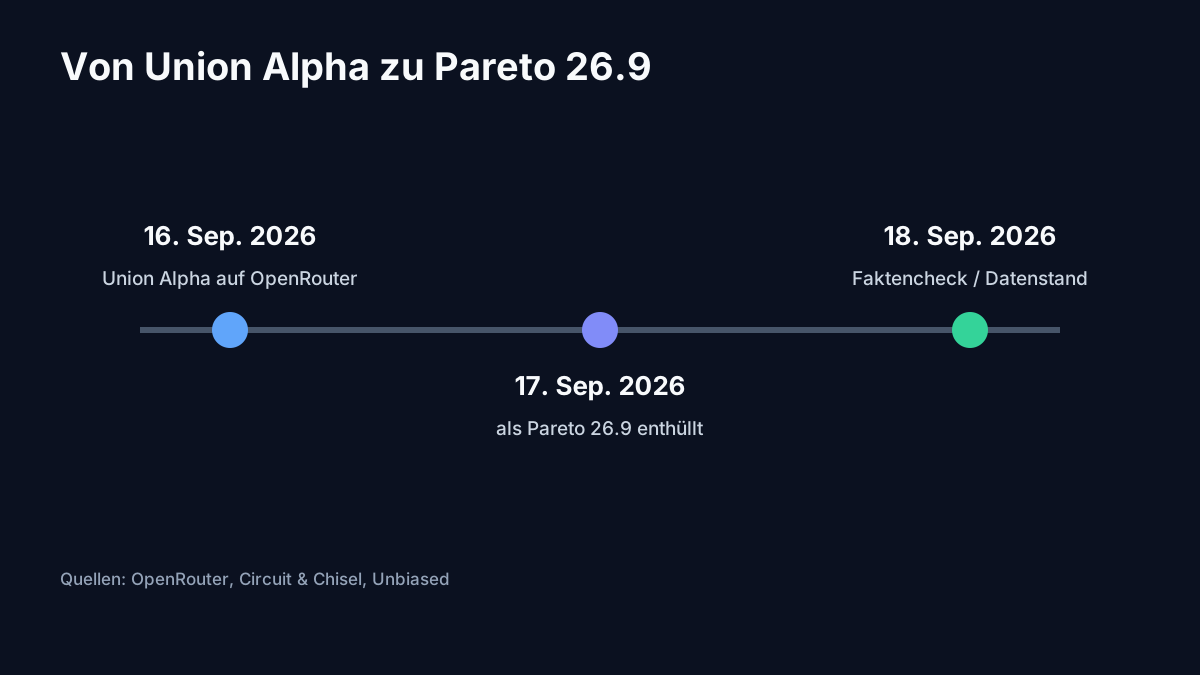
Am 16. September 2026 erschien bei OpenRouter das anonyme beziehungsweise „stealth“ geführte Union Alpha. Einen Tag später wurde seine Identität offengelegt: Union Alpha war Pareto von Unbiased. OpenRouter führt die Verbindung inzwischen selbst in seiner FAQ auf. (OpenRouter)
Der ungewöhnliche Launch erklärt, warum in den ersten Stunden widersprüchliche Informationen kursierten. Ein Teil der Community versuchte über Tokenizer-Verhalten, Completion-IDs und Infrastruktur-Fingerprints herauszufinden, welcher Anbieter hinter Union Alpha stand. Diese Beobachtungen sind interessante Sekundärevidenz, aber seit der offiziellen Enthüllung für die Identitätsfrage nicht mehr notwendig. (YFarmX)
Für eine langfristige Referenzseite ist deshalb Pareto 26.9 das Hauptthema; „Union Alpha“ gehört in die Release-Chronologie und in die Synonyme für die Suche.
Was Pareto technisch anders macht
Bei einem klassischen Modellrouter wird zunächst versucht, eine Anfrage zu klassifizieren. Anschließend landet sie beispielsweise bei einem günstigen Modell für einfache Aufgaben oder bei einem teuren Frontier-Modell für schwierige Aufgaben.
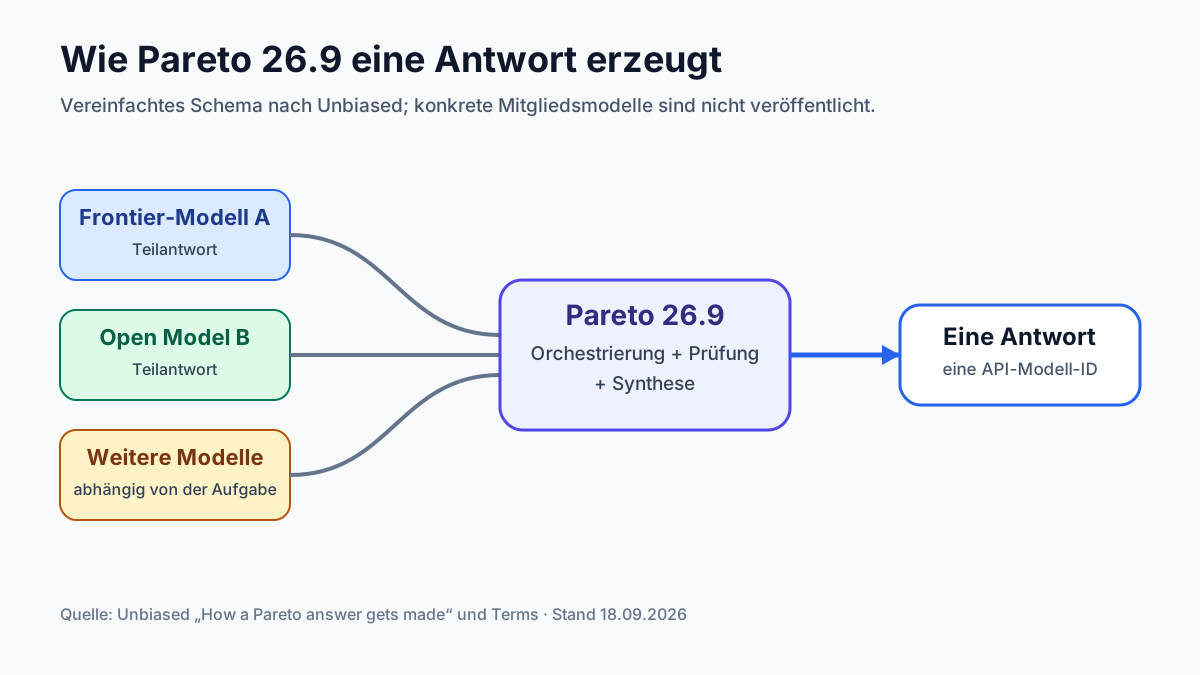
Unbiased beschreibt Pareto anders: Mehrere LLMs werden bei jeder Anfrage beteiligt, und ihre Ergebnisse werden abhängig von der Aufgabe synthetisiert. Die Mischung enthält laut Anbieter sowohl Frontier- als auch Open-Modelle. Der Anwender sieht davon nur einen Request und eine Antwort. (Unbiased)
Die Terms formulieren es etwas juristischer: Pareto kombiniert Outputs mehrerer zugrunde liegender Large Language Models, die Unbiased über eigene Vereinbarungen mit den jeweiligen Modellanbietern bezieht, und synthetisiert daraus eine einzelne Antwort. (Unbiased)
Die Aussage „Pareto ist kein Router“ sollte trotzdem nicht zu wörtlich verstanden werden. Das ist vor allem die Produktabgrenzung von Unbiased gegenüber Routern, die nur ein Zielmodell auswählen. Technisch ist Pareto sinnvoller als Inference-Ensemble beziehungsweise Orchestrierungssystem zu beschreiben. Es versteckt die Auswahl, Parallelisierung, Überprüfung und Synthese hinter einer Modell-ID.
Welche konkreten Modelle Pareto 26.9 bei welchem Prompt verwendet, veröffentlicht Unbiased nicht. Damit lassen sich die Fähigkeiten nicht auf ein einzelnes Basis-LMM zurückführen.
Pareto 26.9 ist deutlich teurer als 26.8
Hier entsteht derzeit besonders viel Verwirrung. Die ältere 26.8-Dokumentation nannte:
- $1,25 pro Million Input-Tokens
- $0,15 Cached Input
- $6,25 Output
Die aktuelle 26.9-Karte nennt $2,50 / $0,25 / $7,50. (Unbiased)
Das entspricht – eigene Berechnung – gegenüber 26.8:
| Tokenart | 26.8 | 26.9 | Veränderung |
|---|---|---|---|
| Input | $1,25 | $2,50 | +100 % |
| Cached Input | $0,15 | $0,25 | +66,7 % |
| Output | $6,25 | $7,50 | +20 % |
Wer ältere Artikel, Screenshots oder Cache-Einträge findet, sollte deshalb auf die Versionsnummer achten. Umgekehrt dürfen die attraktiven gemessenen Cost-per-Task-Werte aus der 26.8-Evaluation nicht einfach auf 26.9 übertragen werden. Unbiased schreibt ausdrücklich, dass gemessene Task-Kosten und ein Composite Score für die neue Version noch nicht veröffentlicht sind. (Unbiased)
Was kostet Pareto in der Praxis?
Die Rechnung ist unkompliziert:
Kosten = nicht gecachte Input-MTokens × $2,50 + gecachte Input-MTokens × $0,25 + Output-MTokens × $7,50
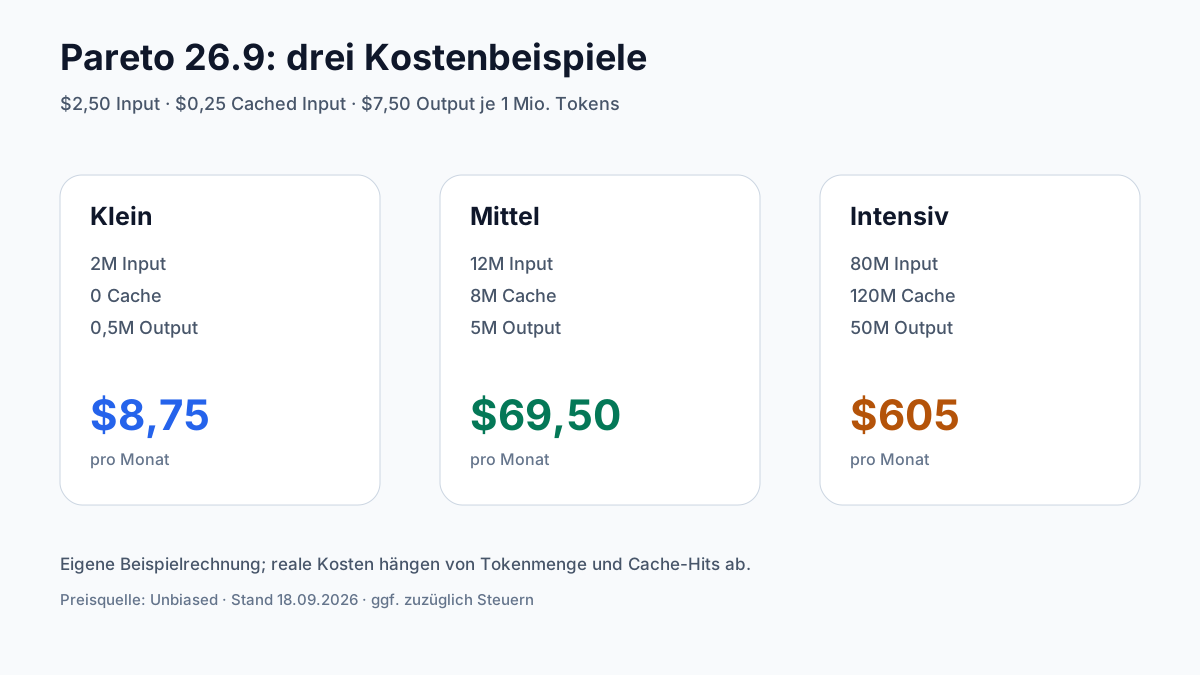
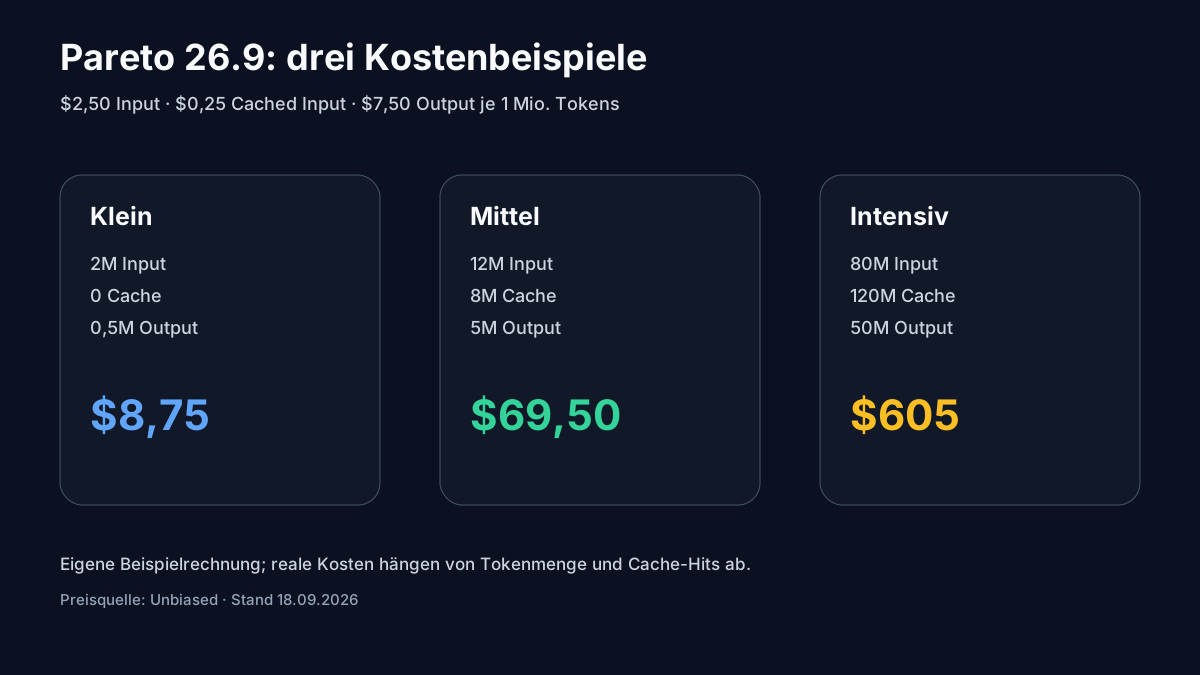
Drei illustrative Monatsprofile, ausschließlich als eigene Berechnung:
| Szenario | Nicht gecachter Input | Cached Input | Output | Monatspreis |
|---|---|---|---|---|
| Kleine Nutzung | 2 Mio. | 0 | 0,5 Mio. | $8,75 |
| Mittlere Nutzung | 12 Mio. | 8 Mio. | 5 Mio. | $69,50 |
| Intensive Nutzung | 80 Mio. | 120 Mio. | 50 Mio. | $605,00 |
Im mittleren Beispiel entstehen $30 Input + $2 Cache + $37,50 Output. Ohne Cache-Hits würden dieselben 20 Millionen Input-Tokens $50 kosten; der Gesamtpreis läge dann bei $87,50.
Beim intensiven Szenario ergeben sich $200 + $30 + $375 = $605. Ohne die angenommenen 120 Millionen gecachten Tokens wären es $875.
Diese Beispiele sind keine Rechnungsprognose. Ob Input tatsächlich als Cache-Hit berechnet werden kann, hängt vom konkreten Promptverlauf und der API-Nutzung ab. Die Terms stellen außerdem klar, dass veröffentlichte Gebühren grundsätzlich exklusive gegebenenfalls geschuldeter Steuern sind, sofern die Rechnung nichts anderes angibt. (Unbiased)
Unbiased verkauft den API-Zugriff derzeit über Prepaid-Credits. Neue Accounts werden nach Anbieterangabe vor Freischaltung manuell geprüft; Credits sind grundsätzlich nicht erstattbar oder übertragbar und laufen ohne abweichendes Order Form nicht ab. (Unbiased)
Wie gut sind die Benchmarks wirklich?
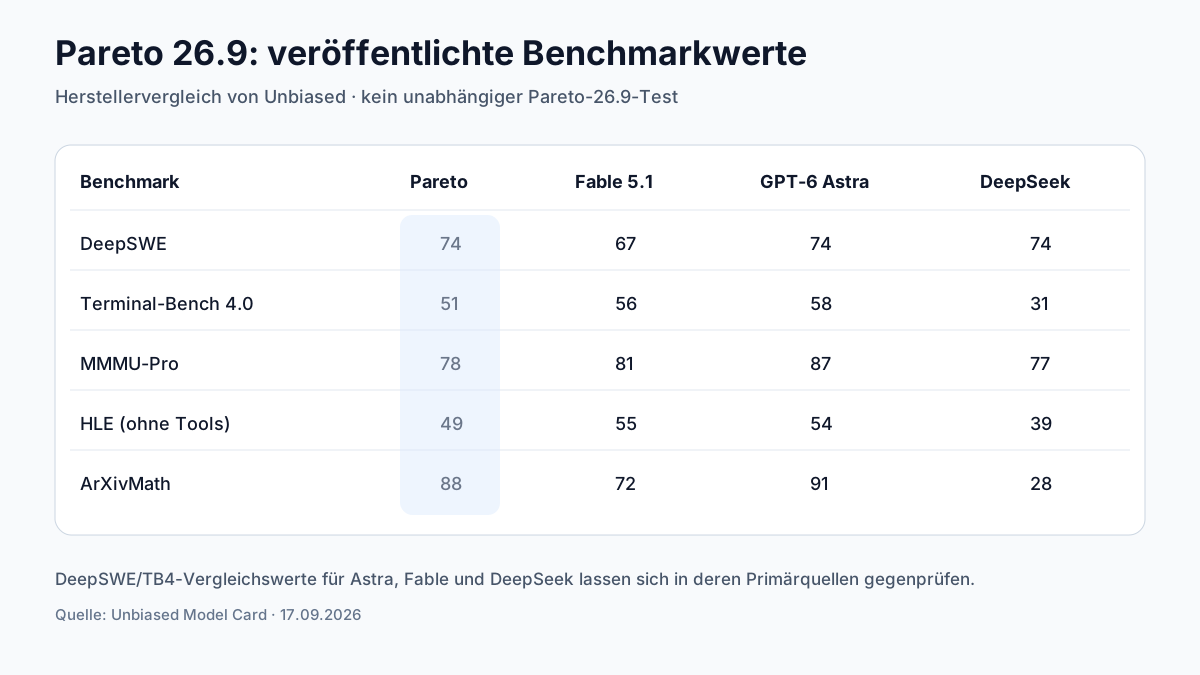
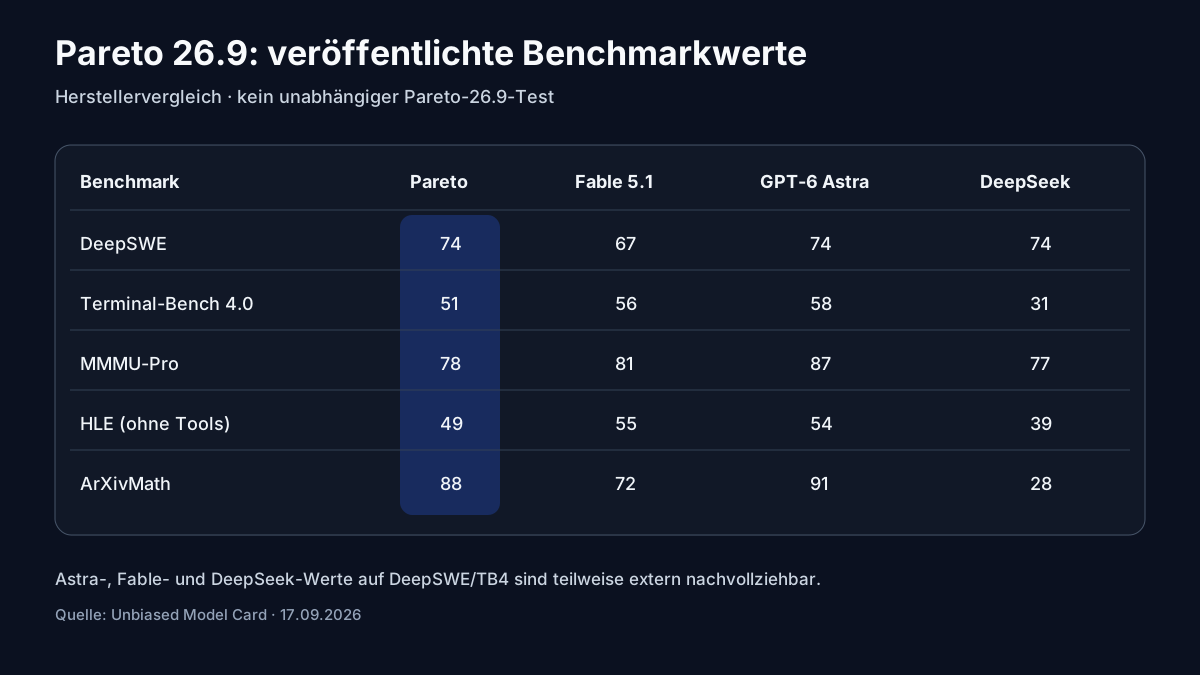
Die aktuelle Model Card nennt diese Werte:
| Benchmark | Pareto 26.9 | Fable 5.1 | GPT-6 Astra | DeepSeek 4.1 Flash |
|---|---|---|---|---|
| DeepSWE | 74 | 67 | 74 | 74 |
| Terminal-Bench 4.0 | 51 | 56 | 58 | 31 |
| MMMU-Pro | 78 | 81 | 87 | 77 |
| HLE, keine Tools | 49 | 55 | 54 | 39 |
| ArXivMath | 88 | 72 | 91 | 28 |
Quelle dieser Tabelle ist Unbiased, nicht ein unabhängiges Testlabor. (Unbiased)
Für die drei Vergleichsmodelle gibt es auf ai-on-mac.com eigene Quellenchecks zu GPT-6 Astra, Claude Fable 5.1 und DeepSeek V4.1 Flash.
Ein Teil der Vergleichswerte lässt sich trotzdem sehr gut gegenprüfen. OpenAI veröffentlicht für GPT-6 Astra 57,9 % auf Terminal-Bench 4.0 und 74,1 % auf DeepSWE v1.1; in derselben OpenAI-Tabelle stehen für Fable 5.1 55,8 und 67,4 %. Genau daraus ergeben sich nach Rundung die 58/74 beziehungsweise 56/67 der Unbiased-Tabelle. DeepSeek veröffentlicht seinerseits 31,2 auf Terminal-Bench 4.0 und 74,2 auf DeepSWE v1.1, ebenfalls konsistent mit den gerundeten Unbiased-Werten. (OpenAI)
Das stärkt die Glaubwürdigkeit der Vergleichsspalten – es validiert aber noch nicht Pareto selbst. Dafür müsste ein unabhängiger Tester denselben Harness mit Pareto 26.9 reproduzieren.
Warum HLE zeigt, wie vorsichtig man sein muss
Unbiased führt Fable 5.1 auf HLE ohne Tools mit 55. Anthropic selbst veröffentlicht für Fable 5.1 unter seiner Konfiguration dagegen 60,9 %. (Unbiased)
Das muss kein Fehler sein. Unterschiedliche Prompting-, Effort-, Judge- oder Dataset-Konfigurationen können verschiedene Resultate erzeugen. Es zeigt aber, warum Benchmarkzahlen nur dann direkt vergleichbar sind, wenn der Testaufbau übereinstimmt.
Die Benchmarksets selbst sind nicht statisch
MMMU-Pro hat beispielsweise noch am 10. Juli 2026 fehlerhafte Ground-Truth-Labels korrigiert; zuvor wurde Ende Mai ein Problem bei der Option-Augmentation behoben. (Hugging Face)
DeepSWE v1.1 umfasst im Pareto-Harness 113 Aufgaben. Ein unabhängiger Audit vom Juli fand, dass inzwischen 112 der 113 Gold-Referenzlösungen ihren eigenen Verifier bestehen; eine blieb problematisch. (GitHub)
Humanity’s Last Exam wiederum umfasst 2.500 Fragen über zahlreiche Fachgebiete und verwendet einen Canary, damit zukünftige Modellanbieter das Dataset aus Trainingsdaten filtern können. (GitHub)
Der richtige Schluss aus Pareto 26.9 ist deshalb nicht „Benchmark gewonnen“ oder „Benchmark verloren“. Interessanter ist, dass das System in mehreren sehr unterschiedlichen Tests in Reichweite aktueller Frontier-Modelle liegt – nach Messungen des Anbieters. Ob dieses Profil auf realen Workloads hält, muss noch unabhängig getestet werden.
Der öffentliche Eval-Harness ist ein echter Pluspunkt
Circuit & Chisel veröffentlicht pareto-evals unter MIT-Lizenz. Das Repository unterstützt reproduzierbare Head-to-Head-Messungen gegen OpenAI-kompatible Endpoints und dokumentiert ausdrücklich, wie Kosten berechnet werden. Latenz wird dort allerdings nicht gemessen. (GitHub)
Der aktuelle Agentic-Bereich umfasst unter anderem DeepSWE v1.1 mit 113 Aufgaben und Terminal-Bench 4.0 mit 66 Aufgaben. Für die API-basierte Benchmark-Suite ist keine eigene GPU erforderlich. (GitHub)
Das ermöglicht einen sinnvolleren Test als ein paar Chat-Prompts: Wer Pareto evaluieren möchte, sollte eine repräsentative interne Suite und mindestens einen reproduzierbaren öffentlichen Benchmark laufen lassen und dabei Qualität, Kosten und Latenz getrennt auswerten.
Geschwindigkeit: derzeit die größte praktische Unbekannte
Unbiased veröffentlicht für 26.9 noch keinen sauberen Vergleich der Laufzeit mit Astra, Fable oder anderen Modellen.
Das eigene Changelog liefert aber einen interessanten Betriebswert. Am 16. September wurde das Timeout für nicht-streamende Pareto-Anfragen von 120 auf 300 Sekunden erhöht. Laut Unbiased lagen lange Completions typischerweise bei 60 bis 110 Sekunden, und etwa 13 % der entsprechenden nicht-streamenden Requests liefen zuvor in das 120-Sekunden-Limit. Streaming war davon nicht betroffen. (Unbiased)
Das ist kein Median-TTFT und kein standardisierter Benchmark. Es zeigt aber, dass die zusätzliche Orchestrierung bei langen beziehungsweise schwierigen Antworten relevant sein kann. Für interaktive Anwendungen sollte Latenz deshalb genauso getestet werden wie Qualität.
API, Tools und Kompatibilität
Unbiased beschreibt den Zugang als OpenAI-kompatibel. Die aktuelle Model Card nennt pareto als Modell-ID. Die Plattform stellt API-Schlüssel bereit; die konkrete Base-URL kann bei der Integration aus dem Unbiased-Onboarding übernommen werden. (Unbiased)
Im Changelog vom 4. September dokumentiert Unbiased außerdem serverseitige Tools für Responses- und Messages-kompatiblen Traffic, darunter Websuche, Bildgenerierung, Patch-Anwendung und Tool Discovery. Diese Angaben beschreiben die Plattformoberfläche und sollten nicht mit modellinternen Fähigkeiten verwechselt werden. (Unbiased)
Ein minimales Python-Beispiel kann deshalb ohne erfundene URL so aussehen:
import os
from openai import OpenAI

client = OpenAI(
    base_url=os.environ["PARETO_BASE_URL"],
    api_key=os.environ["PARETO_API_KEY"],
)

response = client.chat.completions.create(
    model="pareto",
    messages=[
        {"role": "user", "content": "Explain KV-cache eviction in plain English."}
    ],
)

print(response.choices[0].message.content)
Wer OpenRouter nutzt, verwendet dort entsprechend die Modell-ID unbiased/pareto.
Datenschutz: besser als viele Launch-Slogans – aber nicht „magisch zero retention“
Die aktuell gültigen Unbiased Terms sind an dieser Stelle aussagekräftiger als Social-Media-Posts. Sie erklären:
- Customer Content soll nur so lange gespeichert werden, wie es für Verarbeitung und Ausgabe erforderlich ist;
- für Missbrauchsprävention und Sicherheitsmonitoring ist eine Ausnahme von höchstens 30 Tagen vorgesehen;
- Customer Content wird nicht zum Trainieren, Fine-Tunen oder Verbessern eines Modells verwendet, sofern der Kunde nicht ausdrücklich schriftlich zustimmt;
- der Kunde behält Rechte an seinen Inputs und soll die Rechte an den Outputs besitzen. (Unbiased)
Damit ist „Unbiased trainiert ohne Opt-in nicht auf deinen Prompts“ durch die Terms gut gestützt. „Alle Daten werden immer sofort gelöscht“ wäre dagegen zu stark formuliert.
Bei BYOK-Verbindungen zu Drittanbietern gelten für die dort verarbeiteten Daten zusätzlich deren jeweilige Bedingungen. Darauf weist Unbiased ausdrücklich hin. (Unbiased)
Kann Pareto lokal auf einem Mac laufen?
Pareto 26.9 selbst derzeit nicht in der Form eines herunterladbaren lokalen Modells.
Es gibt keine veröffentlichten Pareto-Gewichte und keinen dokumentierten MLX-, llama.cpp- oder Ollama-Download. Dass die interne Mischung laut Unbiased auch Open Models enthält, ändert daran nichts: Das Produkt Pareto besteht gerade aus der proprietären Orchestrierung mehrerer Modelle. (Unbiased)
Für einen Mac ist Pareto deshalb aktuell vor allem ein Cloud-API-Modell. Ein MacBook Air oder Mac mini benötigt für die Inferenz selbst keine große Unified-Memory-Ausstattung; Python, Node, curl oder ein kompatibler Agent-Client reichen als Frontend.
Das unterscheidet Pareto deutlich von Open-Weight-Modellen, bei denen Quantisierung, Unified Memory, Speicherbandbreite, KV-Cache und Metal/MLX direkt über die lokale Geschwindigkeit entscheiden.
Wenn du stattdessen ein Modell wirklich lokal betreiben willst, zeigt der Unified-Memory-Guide, wie Modellgewichte, Quantisierung und KV-Cache den RAM-Bedarf auf Apple Silicon bestimmen.
Ist Pareto also wirklich ein „Modell“?
Aus API-Sicht: ja. Man wählt eine Modell-ID, sendet einen Prompt und erhält eine Antwort.
Aus Machine-Learning-Sicht ist die Bezeichnung unkonventioneller. Es gibt nicht den einen bekannten Pareto-Checkpoint, dessen Parameterzahl, Quantisierung oder Architektur man angeben könnte. Die stabilere Ebene ist das Systemverhalten: mehrere Modelle, Orchestrierung, Synthese und eine einheitliche API.
Das hat Vor- und Nachteile. Unbiased kann neue Modelle in den Blend aufnehmen, ohne dass Anwender ihre Integration ändern müssen. Gleichzeitig wird die exakte Reproduzierbarkeit schwieriger: Wenn sich der interne Blend ändert, kann sich das Verhalten des „gleichen“ API-Modells verändern.
Für produktive Systeme sollte deshalb nicht nur der String pareto versioniert werden. Sinnvoll sind zusätzlich eigene Regressionstests, gespeicherte Promptversionen und regelmäßige Canary-Evals.
Häufig gestellte Fragen
Ist Pareto 26.9 ein eigenes LLM?
Nicht im üblichen Sinn eines einzelnen veröffentlichten Checkpoints. Unbiased beschreibt Pareto als proprietäres Blended-System, das mehrere LLMs pro Anfrage beteiligt und deren Ergebnisse zu einer Antwort synthetisiert.
Welche Modelle stecken in Pareto 26.9?
Unbiased nennt keine vollständige Liste der Mitgliedsmodelle. Der Anbieter sagt lediglich, dass der Blend Frontier- und Open-Modelle enthält und sich die Zusammensetzung ändern kann.
Was kostet unbiased/pareto?
Direkt bei Unbiased kostet Pareto 26.9 derzeit 2,50 US-Dollar pro Million Input-Tokens, 0,25 Dollar pro Million gecachter Input-Tokens und 7,50 Dollar pro Million Output-Tokens. Provider können eigene Gebühren oder Bedingungen ergänzen.
Hat Pareto 26.9 ein 262K-Kontextfenster?
OpenRouter nennt für Union Alpha/Pareto 262.144 Tokens. Die aktuelle Unbiased Model Card veröffentlicht selbst keine Kontextgröße; deshalb sollte 262K als OpenRouter-Angabe gekennzeichnet werden.
Kann Pareto lokal auf einem Mac laufen?
Nicht als veröffentlichter Pareto-26.9-Checkpoint. Es gibt keine offiziellen Pareto-Gewichte für MLX, Ollama oder llama.cpp; auf dem Mac wird Pareto derzeit als Cloud-API genutzt.
Werden Prompts zum Training verwendet?
Laut den aktuellen Unbiased Terms wird Customer Content nicht ohne ausdrückliche schriftliche Zustimmung zum Trainieren, Fine-Tunen oder Verbessern von Modellen verwendet. Für Missbrauchsprävention und Sicherheitsmonitoring erlauben die Terms jedoch eine Aufbewahrung von bis zu 30 Tagen.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- unbiased.ai model-card
- unbiased.ai pricing
- unbiased.ai how
- unbiased.ai terms
- unbiased.ai changelog
- openrouter.ai stealth / union-alpha
- openrouter.ai unbiased / pareto
- github.com circuitandchisel / pareto-evals
- openai.com index / gpt-6-astra
- deepseek.com news / deepseek-v4-1-flash
- github.com centerforaisafety / hle
- huggingface.co MMMU / MMMU_Pro
- tbench.ai run