title: “GPT-6 Sol vs. Luna: Preise, Pro, Batch und alle Unterschiede” description: “GPT-6 Sol und Luna im Vergleich: API-Preise, 1,05-Millionen-Kontext, Pro-Reasoning, Batch-Rabatt, Cache-Kosten, Benchmarks und die acht sichtbaren Varianten.” date: “2026-09-22” updated: “2026-09-22” lang: “de” slug: “gpt-6-sol-luna-pro-batch-vergleich” translationKey: “gpt-6-sol-luna-pro-batch” image: “/assets/gpt-6-sol-luna/hero-de-og.png” imageAlt: “GPT-6 Sol und Luna mit Standard-, Pro- und Batch-Modi sowie API-Preisen” keywords:
- GPT-6 Sol
- GPT-6 Luna
- GPT-6 Sol Pro
- GPT-6 Luna Pro
- GPT-6 Batch
- GPT-6 Preise
- OpenAI API
- Reasoning Mode
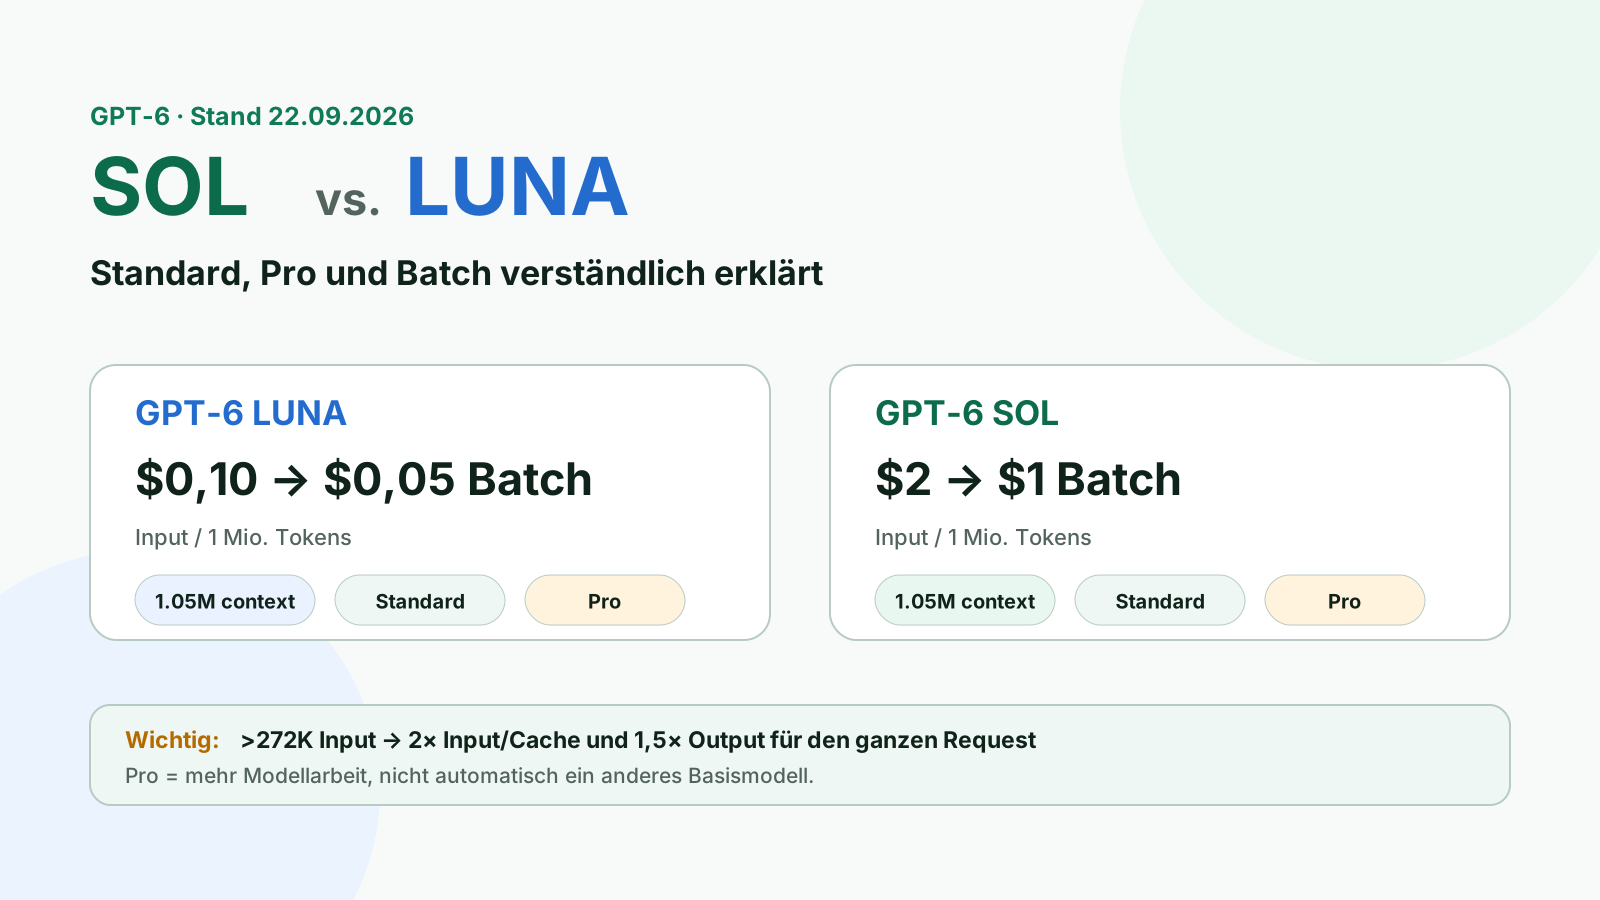
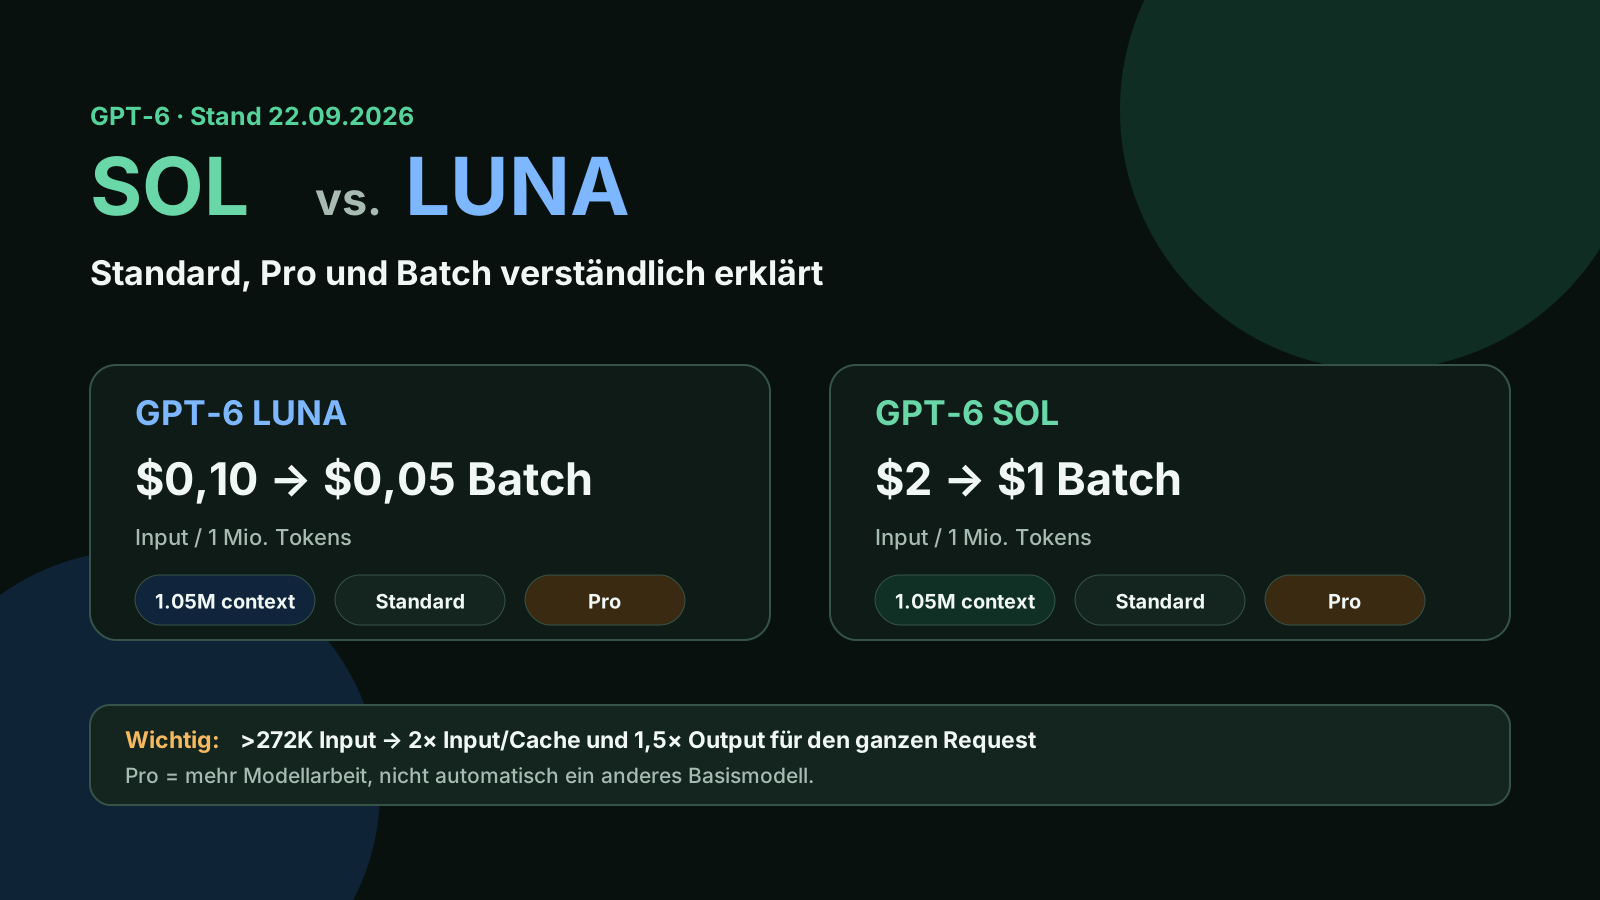
Stand: 22. September 2026. OpenAI hat GPT-6 Sol und GPT-6 Luna veröffentlicht. Sol ist für komplexe Coding- und Agenten-Workflows positioniert, Luna für fokussierte Aufgaben mit hohem Volumen und sehr niedrigen Kosten. Beide Modelle unterstützen ein Kontextfenster von 1.050.000 Tokens und bis zu 128.000 Output-Tokens. Die offiziellen API-Preise starten bei 0,10 US-Dollar pro 1 Mio. Input-Tokens für Luna und 2 US-Dollar für Sol. OpenAI: Launch · Sol-Dokumentation · Luna-Dokumentation
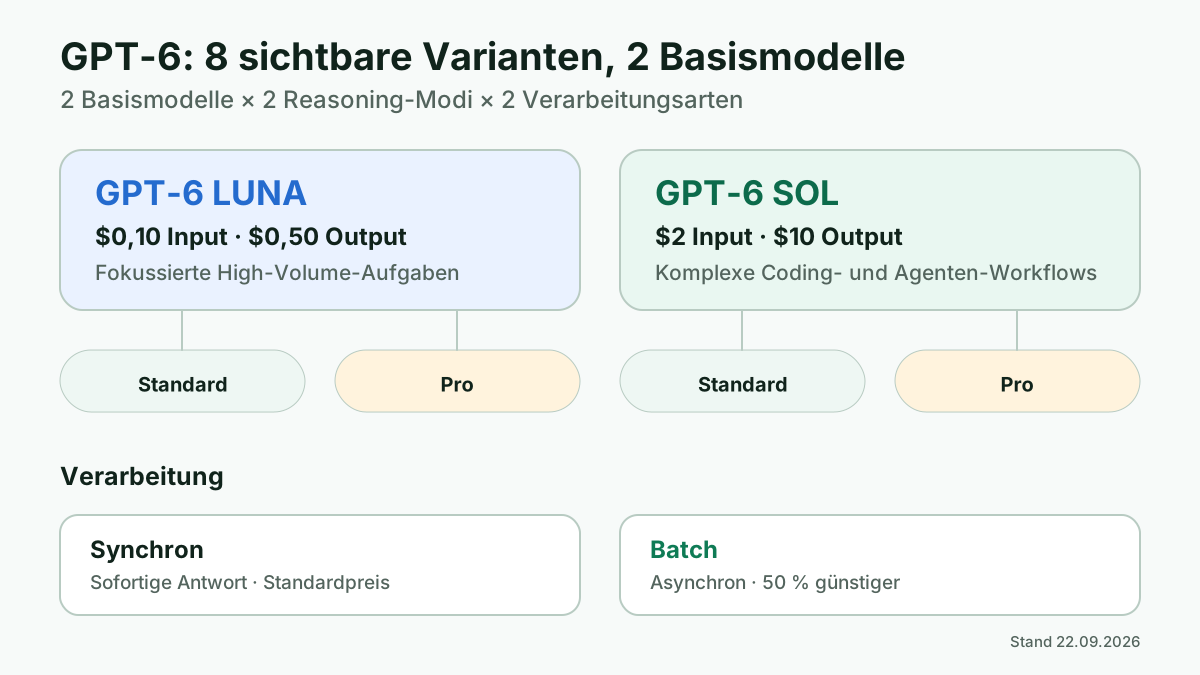
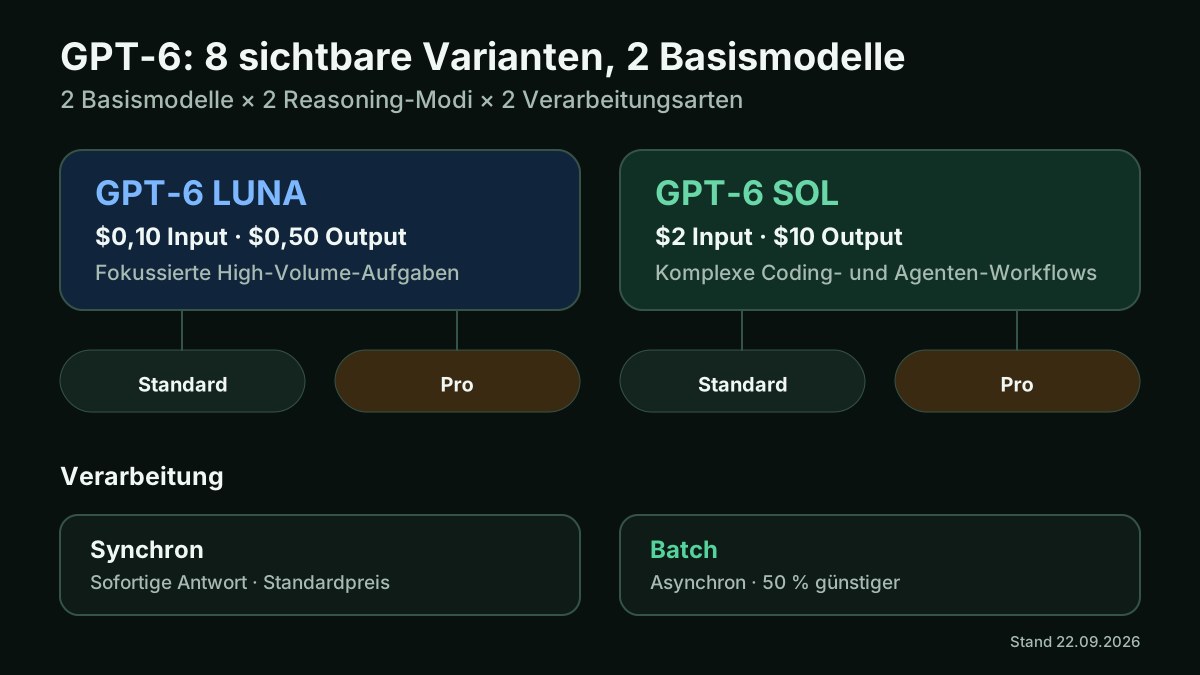
Wer Sol und Luna in einer Provider-Oberfläche auswählt, kann mehr als zwei Einträge sehen: Standard, Pro, Batch und Kombinationen daraus. Das sind nicht acht verschiedene Basismodelle. Sinnvoller ist diese Denkweise:
2 Basismodelle × 2 Reasoning-Modi × 2 Verarbeitungsarten.
Dieser Artikel erklärt genau diese Ebenen, zeigt die tatsächlichen Tokenpreise und markiert die zwei Kostenfallen, die in einer einfachen Modellliste leicht übersehen werden: mehr Tokens im Pro-Modus und der Long-Context-Aufschlag oberhalb von 272.000 Input-Tokens.
Die acht GPT-6-Auswahlen im Preisvergleich
| Auswahl | Basismodell | Reasoning | Verarbeitung | Input / 1 Mio. Tokens | Output / 1 Mio. Tokens |
|---|---|---|---|---|---|
| GPT-6 Luna | Luna | Standard | synchron | $0,10 | $0,50 |
| GPT-6 Luna Pro | Luna | Pro | synchron | $0,10* | $0,50* |
| GPT-6 Luna Batch | Luna | Standard | asynchron | $0,05 | $0,25 |
| GPT-6 Luna Pro Batch | Luna | Pro | asynchron | $0,05* | $0,25* |
| GPT-6 Sol | Sol | Standard | synchron | $2,00 | $10,00 |
| GPT-6 Sol Pro | Sol | Pro | synchron | $2,00* | $10,00* |
| GPT-6 Sol Batch | Sol | Standard | asynchron | $1,00 | $5,00 |
| GPT-6 Sol Pro Batch | Sol | Pro | asynchron | $1,00* | $5,00* |
* Pro hat keinen separaten höheren Token-Tarif. OpenAI rechnet die erzeugte Modellarbeit zum normalen Tarif des gewählten Modells ab. Pro kann jedoch mehr Reasoning-Tokens erzeugen und dadurch pro Aufgabe mehr kosten. OpenAI: Reasoning modes
| GPT-6 Luna: 20-mal günstiger pro Token als Sol |
GPT-6 Luna kostet laut OpenAI $0,10 pro 1 Mio. Input-Tokens und $0,50 pro 1 Mio. Output-Tokens. Cached Input kostet $0,01, Cache Writes $0,125 pro 1 Mio. Tokens. Luna besitzt ein Kontextfenster von 1.050.000 Tokens, maximal 128.000 Output-Tokens und einen Knowledge Cutoff vom 18. Mai 2026. OpenAI: GPT-6 Luna
Luna ist damit besonders attraktiv für Aufgaben, die oft ausgeführt werden und bei denen der Preis pro erfolgreichem Durchlauf entscheidend ist: Extraktion, Klassifikation, Zusammenfassungen, strukturierte Ausgaben, Routine-Code, parallele Sub-Agenten und große Mengen relativ klar abgegrenzter Aufgaben.
Der reine Tokenpreis von Sol ist bei Input und Output jeweils 20-mal so hoch. Das bedeutet aber nicht automatisch, dass eine erfolgreich abgeschlossene Sol-Aufgabe 20-mal so teuer ist. Wenn Luna bei einem schwierigen Workflow häufiger scheitert, mehrere Versuche benötigt oder deutlich mehr Tokens erzeugt, kann die Differenz pro erfolgreichem Ergebnis kleiner ausfallen.
GPT-6 Sol: für komplexe Coding- und Agenten-Workflows
GPT-6 Sol kostet $2 pro 1 Mio. Input-Tokens und $10 pro 1 Mio. Output-Tokens. Cached Input kostet $0,20, Cache Writes $2,50. Das Kontextfenster beträgt ebenfalls 1.050.000 Tokens, die maximale Ausgabe 128.000 Tokens. Der Knowledge Cutoff ist der 20. April 2026. OpenAI: GPT-6 Sol
OpenAI beschreibt Sol ausdrücklich als Modell für komplexe Coding- und agentische Workflows. GPT-6 Astra bleibt laut OpenAI das leistungsfähigste Modell der GPT-6-Familie; Sol soll anspruchsvolle Arbeit mit deutlich niedrigeren Kosten abdecken. OpenAI: GPT-6 Sol and Luna
Was bedeutet „Pro“ bei GPT-6 Sol und Luna?
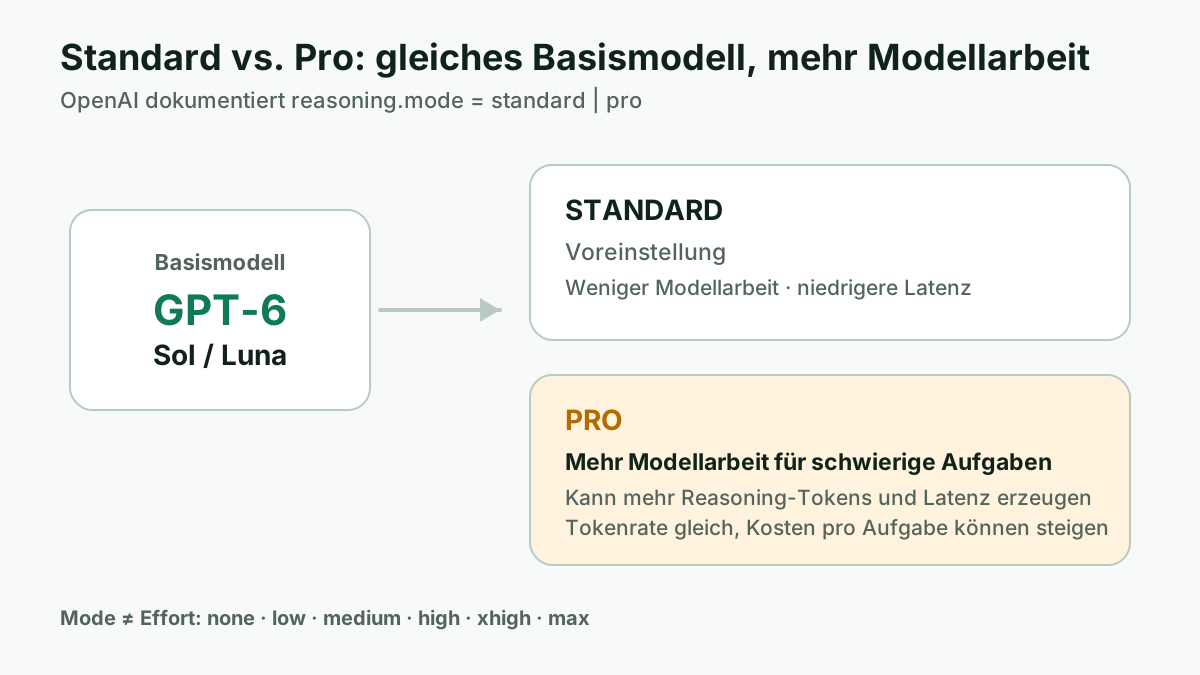
OpenAI unterstützt für GPT-5.6- und GPT-6-Modelle zwei Reasoning-Modi in der Responses API: standard und pro. standard ist die Voreinstellung. pro ist für schwierige Aufgaben gedacht, bei denen zusätzliche Modellarbeit akzeptabel ist. OpenAI weist ausdrücklich auf höhere Latenz und höheren Tokenverbrauch hin. OpenAI: Reasoning modes
Wichtig: reasoning.mode und reasoning.effort sind unterschiedliche Einstellungen. Bei GPT-6 Sol und Luna kann der Effort von none über low, medium, high und xhigh bis max reichen. Der Reasoning-Modus bestimmt Standard oder Pro; der Effort bestimmt, wie viel Reasoning innerhalb dieses Modus angewendet wird.
Pro ist kein neues Basismodell
„GPT-6 Sol Pro“ sollte deshalb nicht wie ein drittes Modell neben Sol und Luna behandelt werden. Technisch ist der entscheidende Unterschied die Ausführungsweise, nicht ein eigener Satz Modellgewichte.
OpenAI schreibt außerdem, dass Pro die Modellarbeit aggregiert und die dabei entstehenden Tokens zum normalen Tokenpreis des gewählten Modells abrechnet. Das erklärt, warum in einer Oberfläche derselbe Preis pro Token stehen kann, der reale Preis pro Aufgabe aber trotzdem steigt.
Was bedeutet „Batch“?
Batch verändert nicht die Modellintelligenz, sondern die Art der Verarbeitung. OpenAIs Batch API verarbeitet Gruppen von Requests asynchron, bietet einen separaten Rate-Limit-Pool und kostet 50 % weniger als synchrone Standard-Requests. OpenAI gibt eine maximale Bearbeitungszeit von 24 Stunden an; viele Batches können früher fertig sein. OpenAI: Batch API
Damit ergeben sich rechnerisch folgende Batch-Tarife:
- GPT-6 Luna: $0,05 Input / $0,25 Output
- GPT-6 Sol: $1,00 Input / $5,00 Output
Batch eignet sich für Evaluierungen, große Klassifikationsjobs, Dataset-Verarbeitung, nächtliche Agentenläufe und andere Aufgaben, deren Ergebnis nicht sofort benötigt wird. Für interaktive Chats oder Echtzeit-Agenten ist Batch dagegen nicht der passende Verarbeitungsmodus.
Was bedeutet „Pro + Batch“?
Beide Optionen lassen sich konzeptionell kombinieren: Das Modell darf im Pro-Modus mehr Arbeit investieren, während die Requests über den asynchronen Batch-Pfad verarbeitet werden.
Die sichtbare Tokenrate entspricht dann dem halbierten Batch-Tarif. Die tatsächlichen Kosten pro Aufgabe bleiben dennoch variabel, weil Pro mehr Reasoning-Tokens erzeugen kann.
Die versteckte Kostenkante bei 272.000 Input-Tokens
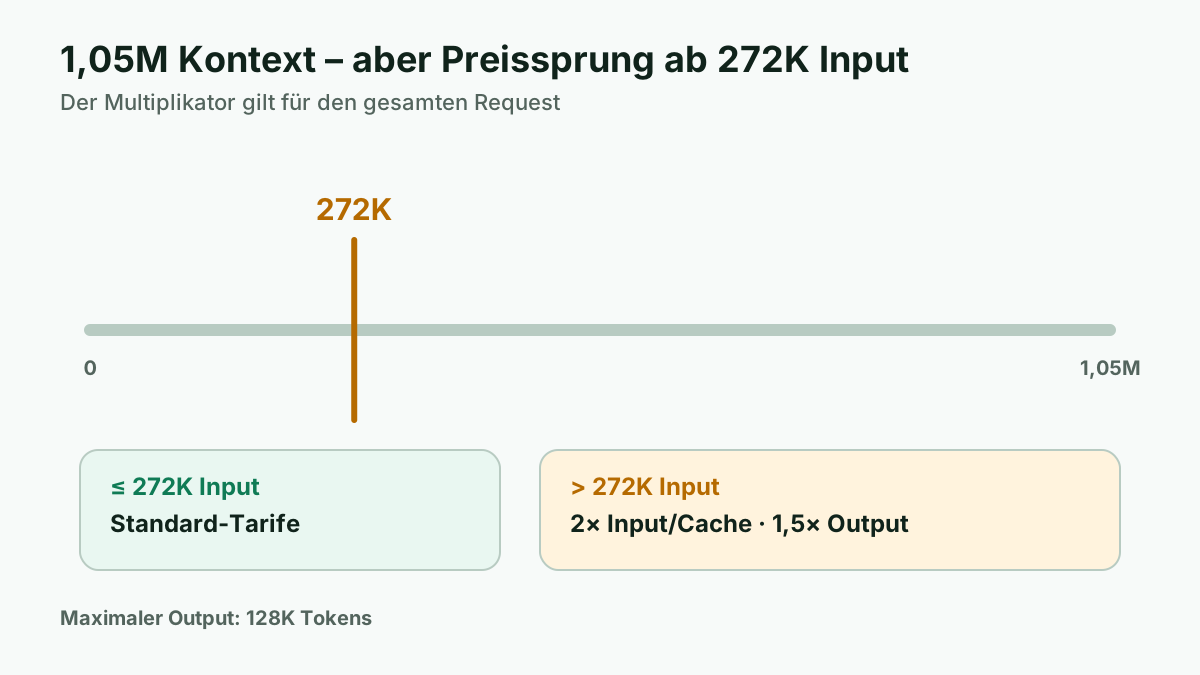
Die Angabe „1,05 Millionen Tokens Kontext“ kann zu einer falschen Kostenannahme führen. OpenAI dokumentiert für Sol und Luna:
Bei Prompts mit mehr als 272.000 Input-Tokens wird der gesamte Request mit dem 2-fachen Input- und Cache-Tarif sowie dem 1,5-fachen Output-Tarif berechnet.
Das gilt nicht nur für die Tokens oberhalb der Schwelle. Der Aufschlag betrifft den vollständigen Request. OpenAI: Sol pricing · OpenAI: Luna pricing
Für große Codebasen, lange Agentenhistorien und umfangreiche Dokumentensammlungen kann diese Grenze wichtiger sein als das maximale Kontextfenster selbst.
Prompt Caching: 90 % Rabatt auf Cached Reads
Cached Input kostet bei Sol und Luna 10 % des normalen Inputpreises. OpenAI nennt für GPT-6 zudem Verbesserungen an der Prompt-Caching-Infrastruktur, die höhere Cache-Hit-Raten ermöglichen sollen. OpenAI: Launch
Das ist besonders relevant für Agenten, die wiederholt große, stabile Präfixe mitsenden: Systemprompts, Tooldefinitionen, Repository-Kontext oder feste Instruktionen.
Die Preise:
| Modell | Normaler Input | Cached Input | Cache Write |
|---|---|---|---|
| GPT-6 Luna | $0,10 / 1M | $0,01 / 1M | $0,125 / 1M |
| GPT-6 Sol | $2,00 / 1M | $0,20 / 1M | $2,50 / 1M |
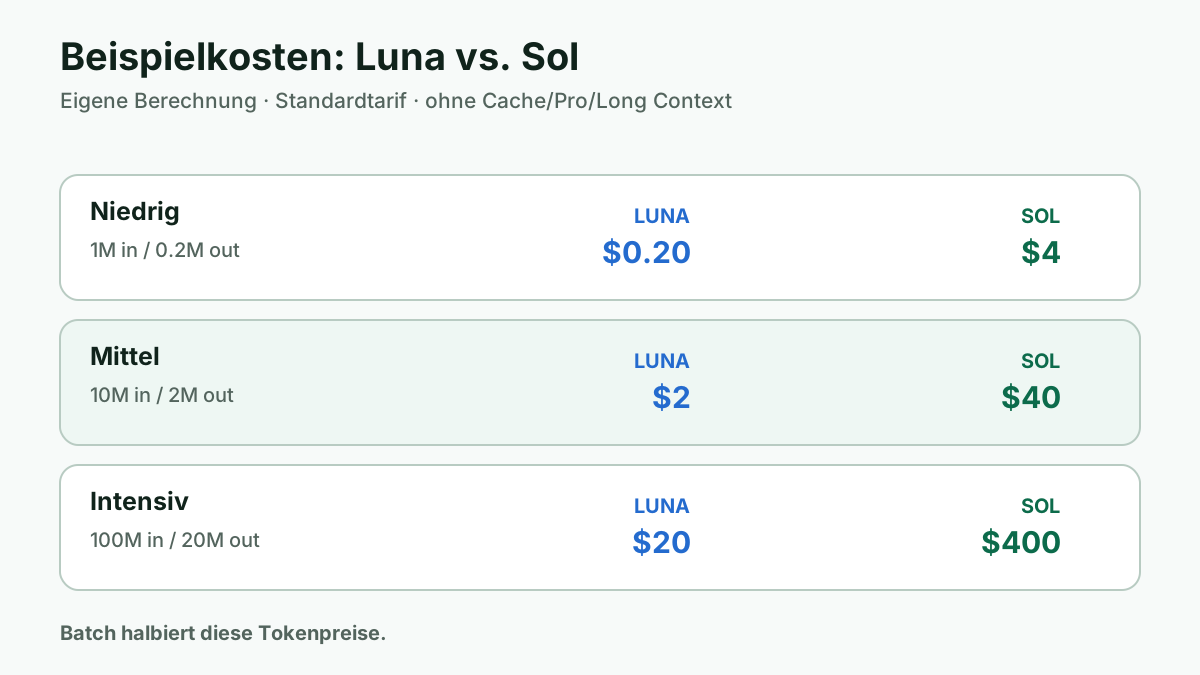
Kostenbeispiele: Luna, Sol und Batch
Die folgenden Rechnungen sind eigene Beispielrechnungen auf Basis der offiziellen Tokenpreise. Sie ignorieren Pro-Zusatzarbeit, Long-Context-Aufschläge, Toolkosten, regionale Processing-Aufschläge und Cachehits.
| Nutzung | Input | Output | Luna | Luna Batch | Sol | Sol Batch |
|---|---|---|---|---|---|---|
| niedrig | 1 Mio. | 0,2 Mio. | $0,20 | $0,10 | $4,00 | $2,00 |
| mittel | 10 Mio. | 2 Mio. | $2,00 | $1,00 | $40,00 | $20,00 |
| intensiv | 100 Mio. | 20 Mio. | $20,00 | $10,00 | $400,00 | $200,00 |
Formel: Input-Millionen × Inputpreis + Output-Millionen × Outputpreis
Beispiel Luna bei mittlerer Nutzung:
10 × $0,10 + 2 × $0,50 = $2,00
Beispiel Sol bei mittlerer Nutzung:
10 × $2,00 + 2 × $10,00 = $40,00
Erste GPT-6-Benchmarks: interessant, aber richtig einordnen
OpenAI veröffentlichte zum Launch mehrere Ergebnisse:
- AutomationBench 1.0.6: GPT-6 Sol mit
xhigherreicht laut OpenAI 33,2 % bei $0,27 Kosten pro Aufgabe. - DeepSWE v1.1: GPT-6 Sol mit
maxerreicht 68,8 %, Luna mitmax66,6 %. - OSWorld 2.0 offline: GPT-6 Sol mit
xhigherreicht 60,5 %.
Quelle für diese Zahlen ist OpenAIs Launch-Evaluierung. OpenAI weist selbst darauf hin, dass eigene Evaluierungen in der Forschungsumgebung oder via API durchgeführt wurden und Produktions-ChatGPT wegen Systemprompt- und Tool-Unterschieden abweichen kann. OpenAI: GPT-6 Sol and Luna
Für eine belastbare Modellwahl sollten diese Launchwerte deshalb durch eigene Evals auf dem tatsächlichen Workflow ergänzt werden.
Welche Variante sollte man wählen?
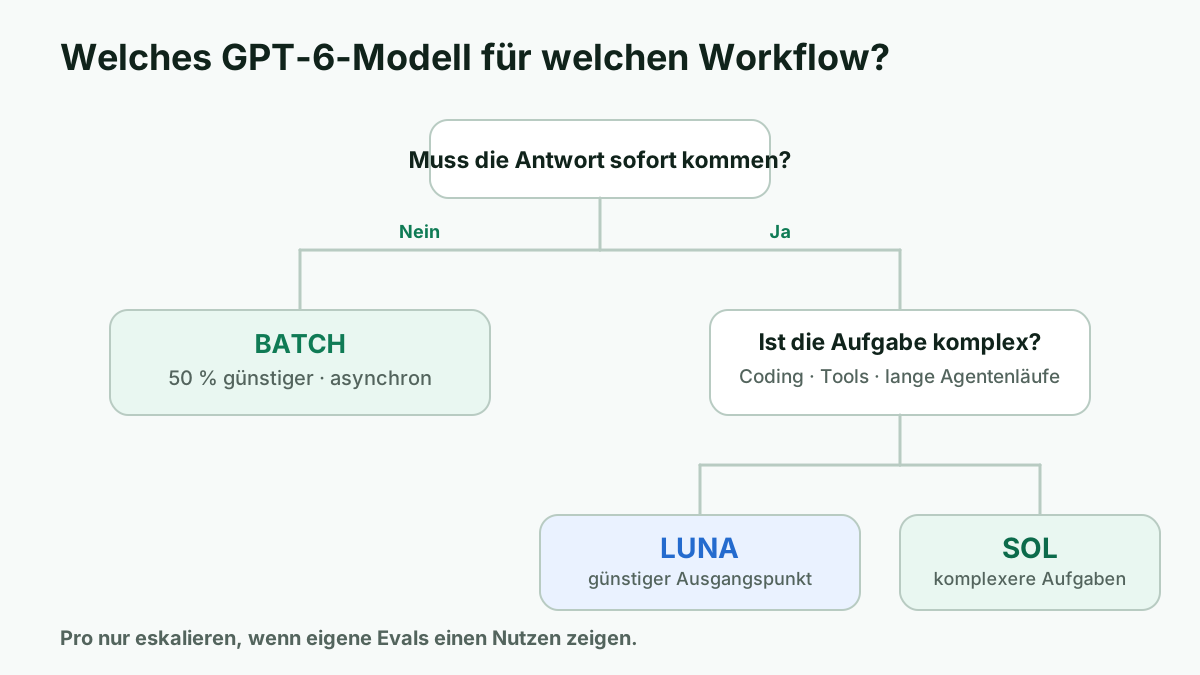
Ein sinnvolles Routing beginnt nicht mit „größtes Modell immer zuerst“, sondern mit der billigsten Variante, die den Qualitätsbedarf zuverlässig erfüllt.
- Luna Standard für viele klar definierte, kostensensitive Aufgaben.
- Luna mit höherem Effort oder Pro für schwierigere Fälle, wenn Luna grundsätzlich geeignet ist.
- Sol Standard für komplexe Coding-, Tool- und Agentenaufgaben.
- Sol Pro nur dort, wo eigene Evals einen klaren Qualitätsgewinn rechtfertigen.
- Batch unabhängig vom Basismodell immer dann, wenn eine Antwort nicht sofort benötigt wird.
GPT-6 Sol vs. Luna: die wichtigsten Unterschiede
| Merkmal | GPT-6 Luna | GPT-6 Sol |
|---|---|---|
| Positionierung | fokussierte High-Volume-Aufgaben | komplexe Coding- und Agenten-Workflows |
| Inputpreis | $0,10 / 1M | $2,00 / 1M |
| Outputpreis | $0,50 / 1M | $10,00 / 1M |
| Cached Input | $0,01 / 1M | $0,20 / 1M |
| Kontext | 1.050.000 Tokens | 1.050.000 Tokens |
| Max. Output | 128.000 Tokens | 128.000 Tokens |
| Knowledge Cutoff | 18.05.2026 | 20.04.2026 |
| Reasoning Effort | none bis max | none bis max |
| Standard / Pro | ja | ja |
| Batch | 50 % günstiger | 50 % günstiger |
| >272K Input | 2× Input/Cache, 1,5× Output | 2× Input/Cache, 1,5× Output |
Datenstand: 22.09.2026. Preise in US-Dollar pro 1 Mio. Tokens, vor möglichen regionalen Aufschlägen und Toolkosten. OpenAI: Luna · OpenAI: Sol
GPT-6 Sol oder Luna: welche Kombination passt?
Die scheinbar große Modellliste lässt sich auf eine einfache Struktur reduzieren: Luna oder Sol, dazu Standard oder Pro, dazu synchron oder Batch.
Luna ist die günstige High-Volume-Option. Sol ist auf komplexere Coding- und Agenten-Workflows ausgelegt. Pro ist kein neues Basismodell, sondern erlaubt mehr Modellarbeit. Batch halbiert den Tokenpreis, wenn der Job warten kann.
Für reale Agentensysteme ist deshalb nicht nur der Listenpreis entscheidend. Die sinnvollste Kennzahl ist Kosten pro erfolgreich abgeschlossener Aufgabe – inklusive Reasoning-Tokens, Cache-Hits, Wiederholungen und Long-Context-Aufschlägen.
Methodik und Quellen
Die technischen Daten und Preise wurden am 22. September 2026 gegen die offiziellen OpenAI-Modellseiten, die Reasoning-Dokumentation, die Batch-Dokumentation und OpenAIs Launch-Beitrag geprüft. Die Benchmarkzahlen werden als von OpenAI veröffentlichte Launch-Ergebnisse gekennzeichnet und nicht als eigener Test dargestellt.
Häufig gestellte Fragen
Ist GPT-6 Luna Pro ein anderes Modell als GPT-6 Luna?
Der relevante Unterschied ist der Reasoning-Modus. OpenAI dokumentiert für GPT-6 `standard` und `pro`. Pro erlaubt mehr Modellarbeit und kann dadurch mehr Tokens und Latenz verursachen. [OpenAI: Reasoning](https://developers.openai.com/api/docs/guides/reasoning)
Kostet GPT-6 Pro pro Token mehr?
Nicht als separater Pro-Aufschlag auf die normale Tokenrate. OpenAI rechnet die im Pro-Modus geleistete Modellarbeit zum Standard-Tokenpreis des gewählten Modells ab. Weil Pro mehr Modellarbeit erzeugen kann, kann der Gesamtpreis eines Requests trotzdem steigen.
Wie günstig ist GPT-6 Luna im Batch?
Der offizielle Luna-Standardpreis beträgt $0,10 Input und $0,50 Output pro 1 Mio. Tokens. Batch und Flex kosten 50 % des Standardtarifs. Daraus folgen rechnerisch **$0,05 Input und $0,25 Output pro 1 Mio. Tokens**. [OpenAI: Luna](https://developers.openai.com/api/docs/models/gpt-6-luna)
Ist Batch genauso intelligent wie Standard?
Batch ist ein Processing-Modus und kein anderes Basismodell. Der praktische Unterschied liegt vor allem in asynchroner Verarbeitung, separater Kapazität und dem 50-%-Preisnachlass. Für interaktive Anwendungen ist Batch wegen der nicht garantierten Sofortantwort ungeeignet.
Hat GPT-6 Luna dasselbe Kontextfenster wie Sol?
Ja. OpenAI dokumentiert für beide **1.050.000 Tokens Kontext** und **128.000 maximale Output-Tokens**. Oberhalb von 272.000 Input-Tokens greift allerdings ein höherer Tarif für den gesamten Request.