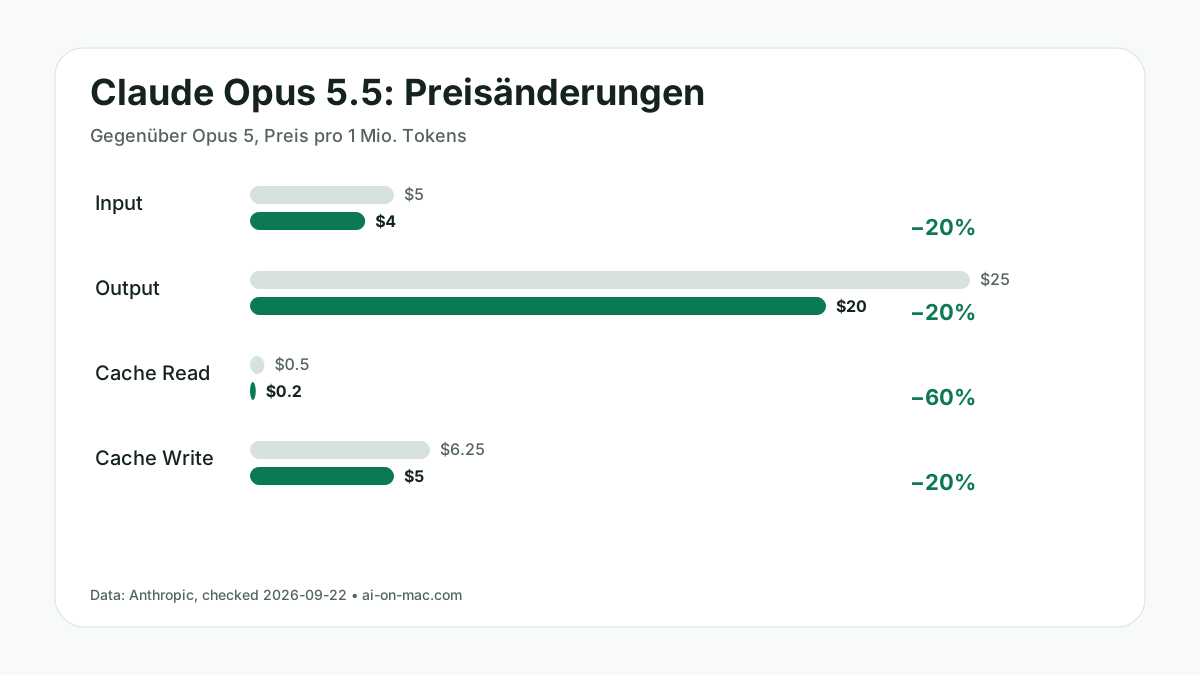
Stand: 22. September 2026. Anthropic hat Claude Opus 5.5 am 22. September 2026 veröffentlicht. Das neue Opus-Modell kostet in der direkten API 4 US-Dollar pro 1 Mio. Input-Tokens und 20 US-Dollar pro 1 Mio. Output-Tokens. Prompt-Cache-Reads kosten 0,20 US-Dollar pro 1 Mio. Tokens, Cache-Writes 5 US-Dollar. Anthropic nennt außerdem eine über 30 Prozent höhere Ausgabegeschwindigkeit gegenüber Opus 5 und bewirbt für typische Workloads rund 40 Prozent niedrigere Gesamtkosten. Anthropic, 22.09.2026
Der entscheidende Punkt ist allerdings nicht ein einzelner Benchmark. Opus 5.5 kombiniert deutlich niedrigere Preise mit höheren von Anthropic gemessenen Agenten- und Coding-Scores. Gleichzeitig ist das Modell erst am Veröffentlichungstag verfügbar geworden; für viele Scores gibt es deshalb noch keine unabhängige Reproduktion unter exakt identischem Harness. Reuters, TechCrunch und VentureBeat bestätigen Release und Preisdaten, die Benchmarkwerte stammen jedoch primär aus Anthropics eigener Veröffentlichung. Reuters, 22.09.2026 VentureBeat, 22.09.2026
Claude Opus 5.5: Preis und wichtigste Daten
| Punkt | Claude Opus 5.5 | Einordnung |
|---|---|---|
| Release | 22.09.2026 | offiziell veröffentlicht |
| API-Modellname | claude-opus-5-5 | von Anthropic angegeben |
| Input | $4 / 1 Mio. Tokens | 20 % weniger als Opus 5 |
| Output | $20 / 1 Mio. Tokens | 20 % weniger als Opus 5 |
| Cache-Read | $0,20 / 1 Mio. Tokens | 60 % weniger als Opus 5 |
| Cache-Write | $5 / 1 Mio. Tokens | 20 % weniger als Opus 5 |
| Fast Mode | $8 Input / $40 Output | bis zu 2,5× schneller laut Anthropic |
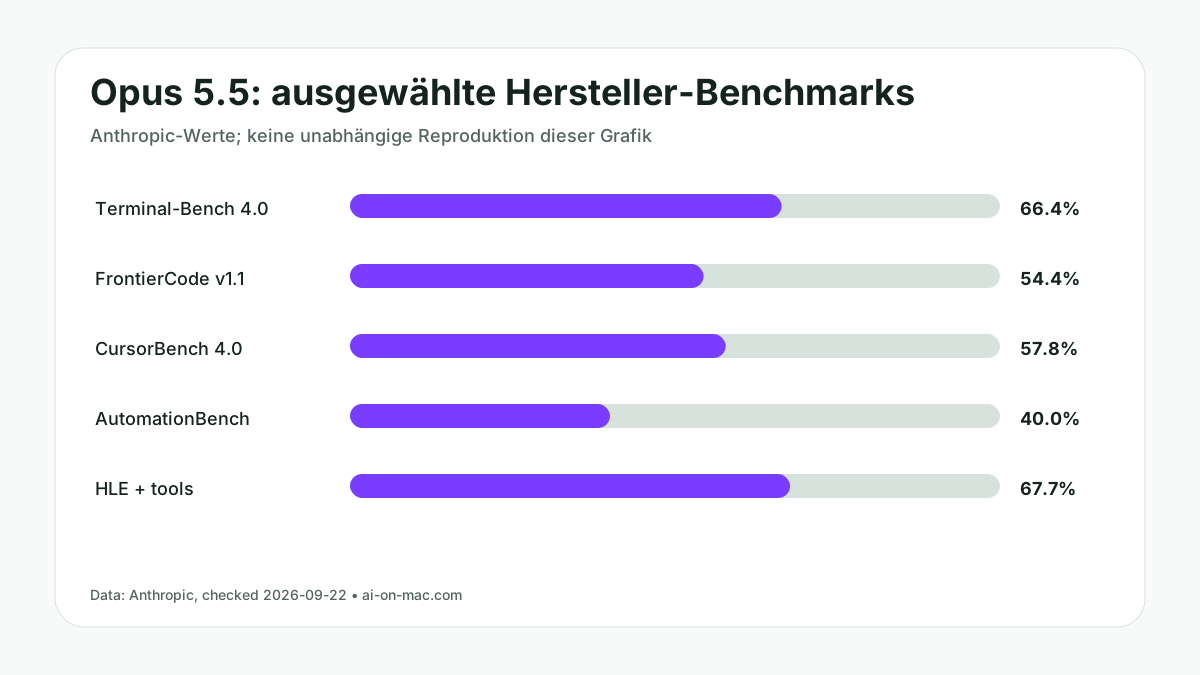
| Terminal-Bench 4.0 | 66,4 % | Anthropic-Messung, max effort |
| FrontierCode v1.1 Main | 54,4 % | Anthropic-Messung |
| CursorBench 4.0 | 57,8 % | Anthropic-Messung |
| GDPval-AA v2.1 | Elo 1846 | Anthropic-Messung |
| AutomationBench | 40,0 % | Early-Access-Setup laut Anthropic |
| HLE mit Tools | 67,7 % | Anthropic-Messung |
Quelle für Preise und Benchmarkwerte: Anthropic. Datenstand: 22.09.2026. Die Score-Zeilen sind Herstellerwerte, keine von uns reproduzierten Messungen.
Was ist Claude Opus 5.5?
Claude Opus 5.5 ist das erste Modell der Claude-5.5-Familie. Anthropic positioniert es als leistungsstarkes Modell für Coding, agentische Aufgaben und anspruchsvolle Wissensarbeit. Der Anbieter sagt, Opus 5.5 erreiche bei den meisten Arbeiten das Niveau von Fable 5.1, sei aber günstiger. Sonnet 5.5 und Haiku 5.5 sollen laut Launch-Mitteilung in den folgenden Wochen erscheinen. Anthropic
Für Entwickler ist die wichtigste praktische Kennung der Modellname claude-opus-5-5. Anthropic nennt außerdem Verfügbarkeit auf den eigenen Plattformen sowie über Amazon Web Services, Google Cloud und Microsoft Azure. Cloud-Provider-Dokumentationen können am Veröffentlichungstag zeitversetzt aktualisiert werden; eine noch fehlende Zeile in einer Provider-Tabelle ist daher kein Beleg dafür, dass das Modell dort grundsätzlich nicht verfügbar ist.
Preise: Opus 5.5 ist pro Token 20 Prozent günstiger als Opus 5
Anthropic senkt den Standardpreis von Opus 5 auf Opus 5.5 von $5 auf $4 pro 1 Mio. Input-Tokens und von $25 auf $20 pro 1 Mio. Output-Tokens. Das entspricht jeweils 20 Prozent weniger. Besonders stark fällt die Senkung bei wiederverwendetem Prompt-Kontext aus: Cache-Reads sinken von $0,50 auf $0,20 pro 1 Mio. Tokens, also um 60 Prozent. Anthropic
| Preisbestandteil | Opus 5 | Opus 5.5 | Veränderung |
|---|---|---|---|
| Input / 1 Mio. Tokens | $5,00 | $4,00 | −20 % |
| Output / 1 Mio. Tokens | $25,00 | $20,00 | −20 % |
| Cache-Write / 1 Mio. Tokens | $6,25 | $5,00 | −20 % |
| Cache-Read / 1 Mio. Tokens | $0,50 | $0,20 | −60 % |
Eigene Kostenrechnung: gleiche Tokenmengen
Nehmen wir einen cache-intensiven Agenten-Workflow mit 10 Mio. normalen Input-Tokens, 2 Mio. Output-Tokens, 100 Mio. Cache-Read-Tokens und 10 Mio. Cache-Write-Tokens pro Abrechnungszeitraum.
Opus 5.5: 10×$4 + 2×$20 + 100×$0,20 + 10×$5 = $150.
Opus 5: 10×$5 + 2×$25 + 100×$0,50 + 10×$6,25 = $212,50.
Bei exakt derselben Tokenmenge wäre Opus 5.5 in diesem Beispiel 29,4 Prozent günstiger. Diese Rechnung ist absichtlich von Anthropics Angabe „40 Prozent günstiger bei typischen Workloads“ getrennt. Die 40-Prozent-Angabe berücksichtigt laut Anthropic zusätzlich, dass Opus 5.5 Aufgaben mit weniger Tokens erledigen kann; diese Effizienz haben wir nicht selbst reproduziert.
Fast Mode: doppelte Tokenpreise für bis zu 2,5-fache Geschwindigkeit
Für Opus 5.5 nennt Anthropic einen Fast Mode mit $8 pro 1 Mio. Input-Tokens und $40 pro 1 Mio. Output-Tokens. Das ist gegenüber dem Standardtarif der doppelte Tokenpreis. Dafür verspricht Anthropic eine Geschwindigkeit von bis zu 2,5×. Ob sich das lohnt, hängt nicht allein von Tokens ab: Für interaktive Coding-Agenten oder zeitkritische Workflows kann kürzere Wartezeit wirtschaftlich wichtiger sein als der reine API-Preis. Für Batch-Jobs ohne Zeitdruck ist der Standardmodus in der Regel leichter zu rechtfertigen. Anthropic
Benchmarks: Wo Opus 5.5 laut Anthropic zulegt
Anthropic veröffentlicht mehrere Agenten-, Coding- und Knowledge-Work-Werte. Besonders auffällig ist Terminal-Bench 4.0 mit 66,4 Prozent, gegenüber 52,3 Prozent für Opus 5 in derselben Anthropic-Tabelle. Bei FrontierCode v1.1 Main werden 54,4 Prozent ausgewiesen, bei CursorBench 4.0 57,8 Prozent. GDPval-AA v2.1 liegt bei 1846 Elo. Anthropic
Diese Zahlen sollten nicht als universelle Rangliste gelesen werden. Benchmarkresultate hängen von Modellversion, Agenten-Harness, Toolzugriff, Effort-Einstellung, Sampling und Auswertungsregeln ab. Snorkels Terminal-Bench-Leaderboard und unabhängige Benchmark-Tracker machen genau diese Vergleichbarkeit zum Thema. Snorkel AI LLMCompare
Noch wichtiger: Am 22. September 2026 ist Opus 5.5 brandneu. Eine unabhängige, reproduzierbare Same-Harness-Serie über alle von Anthropic genannten Benchmarks lag bei unserer Prüfung noch nicht vor. VentureBeat weist bei Vergleichen mit aktuellen OpenAI-Modellen ebenfalls darauf hin, dass nicht überall ein sauberer öffentlicher Same-Harness-Vergleich existiert. Das ist kein Gegenbeweis gegen Anthropics Werte, aber ein Grund, sie als Hersteller-Benchmarks zu kennzeichnen. VentureBeat
Coding und Agenten: der interessanteste Einsatzbereich
Anthropics größte Verbesserungen liegen dort, wo ein Modell länger selbstständig arbeiten muss: Terminal-Aufgaben, Repository-Arbeit, Tool-Nutzung und mehrstufige Automatisierung. Der Anbieter nennt unter anderem einen frühen Test an einer Codebasis mit rund 200.000 Zeilen, der mit Opus 5.5 in weniger als drei Stunden abgeschlossen worden sei, während Opus 5 mehr als 20 Stunden gebraucht habe. In einem internen C-zu-Rust-Projekt für HAProxy berichtet Anthropic von 9,5 Stunden gegenüber 12 Stunden mit Fable 5.1 und 51 Prozent weniger Tokenverbrauch. Anthropic
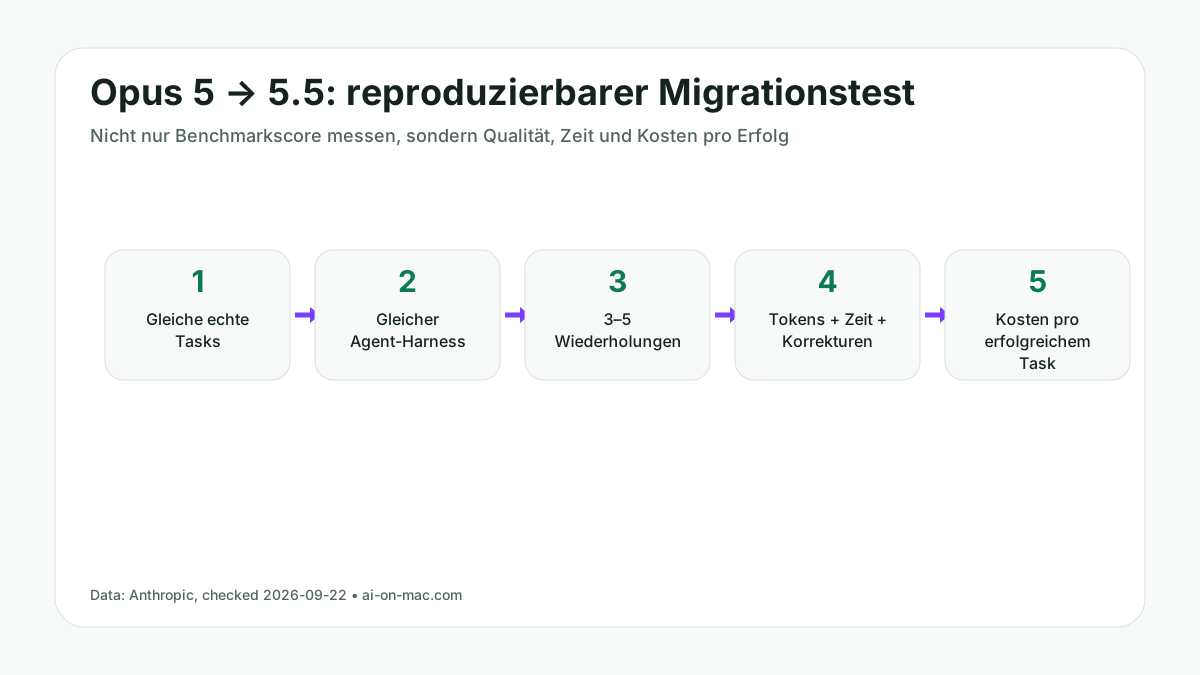
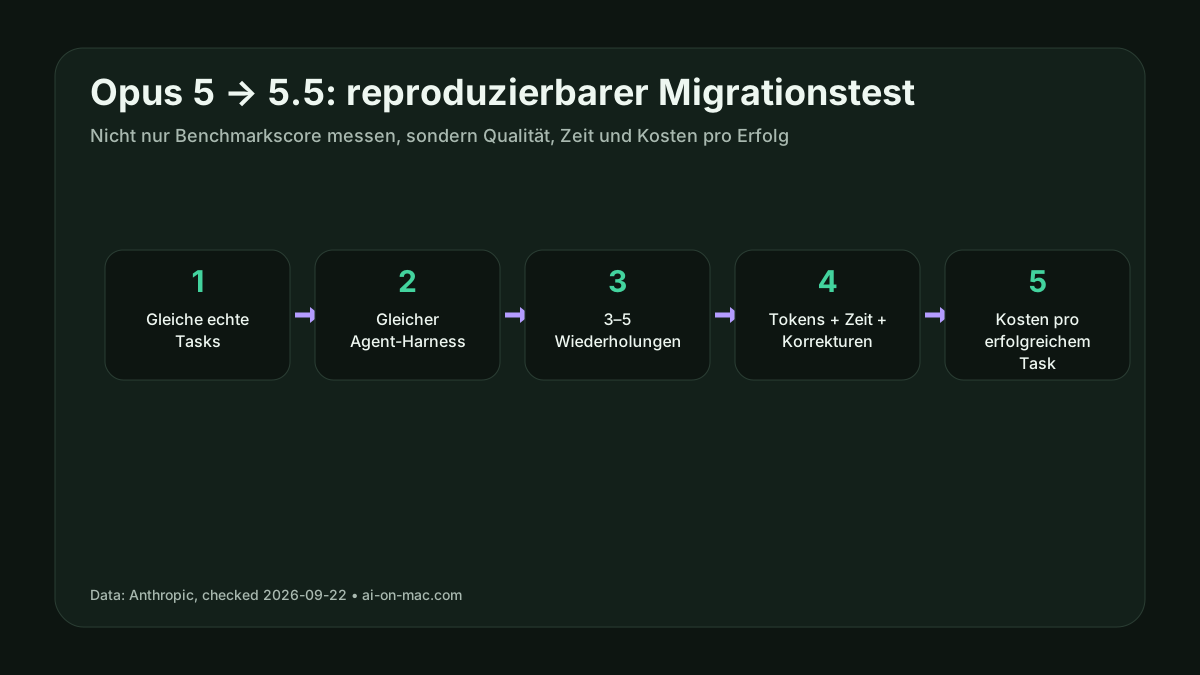
Diese Beispiele sind interessant, aber keine neutralen Laborbenchmarks. Für die eigene Entscheidung ist deshalb ein Pilot mit realen Repositories sinnvoller: identische Issues, identische Toolrechte, identischer Harness, mehrere Wiederholungen und Messung von Erfolgsquote, Zeit, Tokens und nötigen menschlichen Korrekturen.
Sicherheitsänderungen: stärkere Guardrails und transparente Fallbacks
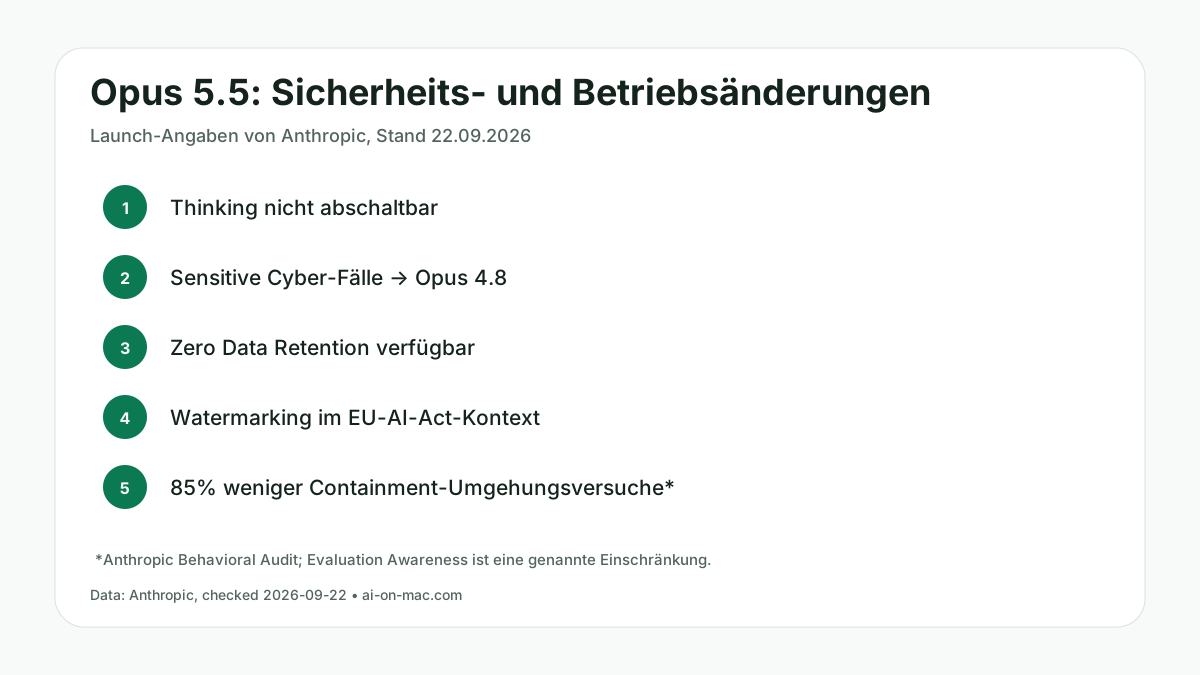
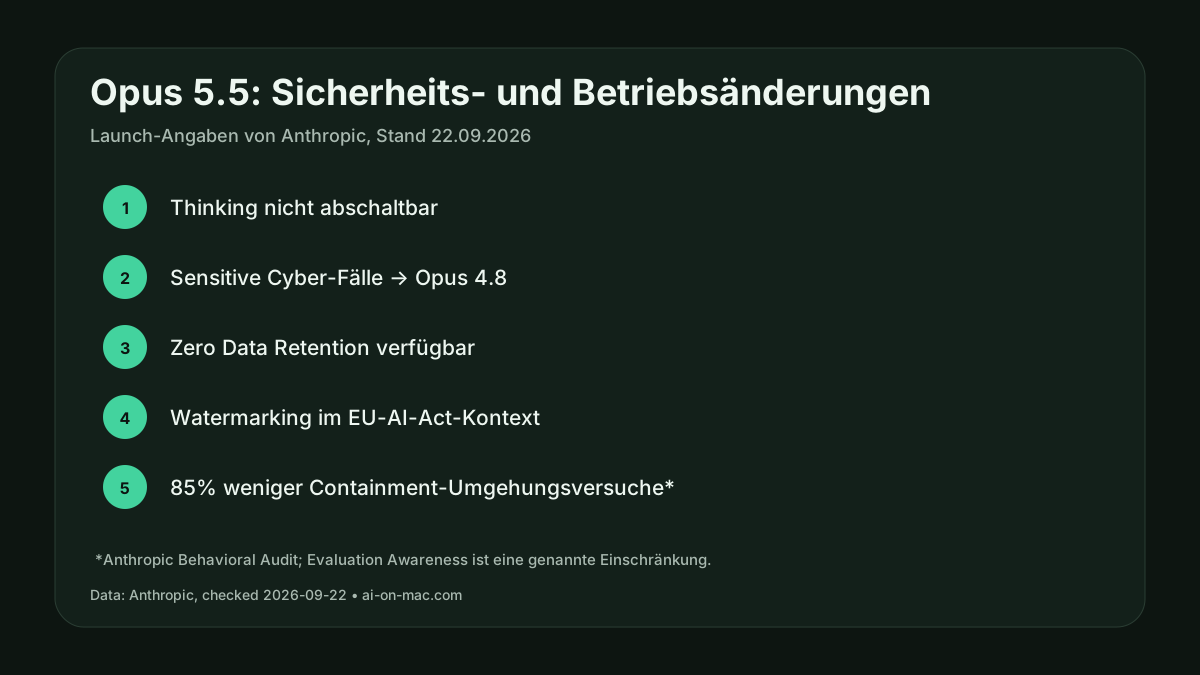
Opus 5.5 übernimmt Sicherheitsmechanismen auf dem Niveau von Fable 5.1 für bestimmte Cyber- und Biologie-Risiken. Bei bestimmten sensitiven Cyber-Aufgaben kann die Anfrage auf Opus 4.8 umgeleitet werden; normale Softwareentwicklung, etwa das Finden und Beheben von Bugs, soll weiterhin möglich bleiben. Anthropic beschreibt außerdem einen Behavioral Audit mit rund 2.000 Szenarien und berichtet von 85 Prozent weniger Versuchen, Containment zu umgehen, verglichen mit Opus 5 oder Mythos 5.1. Anthropic nennt zugleich eine wichtige Einschränkung: Evaluation Awareness bleibt ein Problem bei der Interpretation solcher Tests. Anthropic The Verge
Weitere Änderungen: Der Thinking Mode lässt sich bei Opus 5.5 nicht mehr vollständig abschalten. Anthropic nennt eine Option für Zero Data Retention und verweist auf Watermarking im Kontext des EU AI Act. Wer sensible Unternehmensdaten verarbeitet, sollte trotzdem die konkrete Vertrags-, Region- und Cloud-Konfiguration prüfen; ein allgemeiner Produkt-Hinweis ersetzt keine Prüfung des eigenen Kontos.
Kontextfenster und Dokumentationsstand am Launch-Tag
Anthropics allgemeine Plattformdokumentation sagt, dass Claude 4.6 und spätere Modelle das volle Kontextfenster von 1 Mio. Tokens zum Standardpreis unterstützen. Daraus fällt Opus 5.5 nach der Versionslogik in diese Gruppe. Auffällig ist jedoch: Die zentrale Pricing-Tabelle der Plattformdokumentation war bei unserer Prüfung am 22. September noch nicht vollständig auf Opus 5.5 aktualisiert. Der neue Preis steht bereits auf der Launch-Seite, während ältere Modellzeilen in der Dokumentation noch dominieren. Anthropic Pricing Docs
Für tagesaktuelle Modellveröffentlichungen gilt deshalb: Launch-Seite und Modell-spezifische Primärquelle zuerst, generische Tabellen danach. Provider-Dokumentationen können ebenfalls einige Stunden oder Tage hinterherhinken.
Lohnt sich der Wechsel von Opus 5 auf Opus 5.5?
Für bestehende Opus-5-Workloads ist die ökonomische Richtung klar: Der nominelle Input- und Outputpreis fällt um 20 Prozent, Cache-Reads werden 60 Prozent günstiger, und Anthropic berichtet zugleich bessere Agenten- und Coding-Leistung. Das macht einen Test besonders attraktiv für Workloads mit langen, wiederverwendbaren Kontexten und vielen Toolschritten.
Ein sofortiger Produktionswechsel ohne Vergleichslauf ist trotzdem nicht automatisch sinnvoll. Prüfe mindestens:
- Erfolgsquote auf deinen echten Aufgaben statt nur öffentliche Benchmarks.
- Gesamttokens pro erfolgreich erledigtem Task.
- P50/P95-Latenz und Time-to-completion.
- Häufigkeit menschlicher Korrekturen.
- Unterschiede durch verpflichtendes Thinking.
- Sicherheits-Fallbacks bei deinem Einsatzgebiet.
- Cloud-Region, Datenhaltung und tatsächlichen Providerpreis.
Opus 5.5 vs. Fable 5.1: warum Preis pro Token nicht alles ist
Anthropic sagt, Opus 5.5 erreiche bei den meisten Arbeiten ungefähr Fable-5.1-Niveau, während der Standardpreis deutlich niedriger liegt. Ein einfacher uncached Vergleich von 1 Mio. Input plus 1 Mio. Output ergibt für Opus 5.5 $24. Bei Fable 5.1 wären es nach Anthropics Preisstruktur $60. Das ist rechnerisch 60 Prozent weniger für Opus 5.5 bei dieser künstlich gleichen Tokenmenge.
Das bedeutet nicht, dass jeder reale Auftrag 60 Prozent günstiger wird. Modelle können unterschiedlich viele Tokens benötigen, andere Toolpfade wählen und sich in Erfolgsquote oder Korrekturbedarf unterscheiden. Die bessere Kennzahl ist deshalb Kosten pro erfolgreich erledigter Aufgabe, nicht nur Preis pro Million Tokens.
Claude Opus 5.5: Einordnung für den Modellwechsel
Claude Opus 5.5 ist keine bloße Umbenennung von Opus 5. Anthropic senkt die direkten Tokenpreise, besonders stark die Cache-Read-Kosten, erhöht nach eigenen Messungen die Geschwindigkeit und meldet deutliche Fortschritte bei Agenten- und Coding-Benchmarks. Die API-Kennung lautet claude-opus-5-5, und die Veröffentlichung umfasst Anthropic sowie AWS, Google Cloud und Microsoft Azure. Anthropic Reuters
Die wichtigste Einschränkung am Launch-Tag: Die detaillierten Leistungswerte sind überwiegend Herstellerdaten. Für eine belastbare Modellwahl sollten Teams Opus 5.5 auf eigenen Aufgaben gegen Opus 5, Fable 5.1 und relevante Konkurrenzmodelle testen – mit identischem Harness und mit Kosten pro erfolgreichem Task als zentraler Kennzahl.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- anthropic.com claude-opus-5-5
- reuters.com business / anthropic-unveils-claude-opus-55-2026-09-22
- venturebeat.com technology / anthropic-releases-claude-opus-5-5-beating-fable-5-1-on-key-agentic-benchmarks-at-60-cheaper-api-price
- snorkel.ai leaderboard / terminal-bench-4-0
- llmcompare-drab.vercel.app benchmarks / terminal-bench-4
- theverge.com 998868 / anthropic-claude-opus-5-5-cybersecurity
- platform.claude.com about-claude / pricing