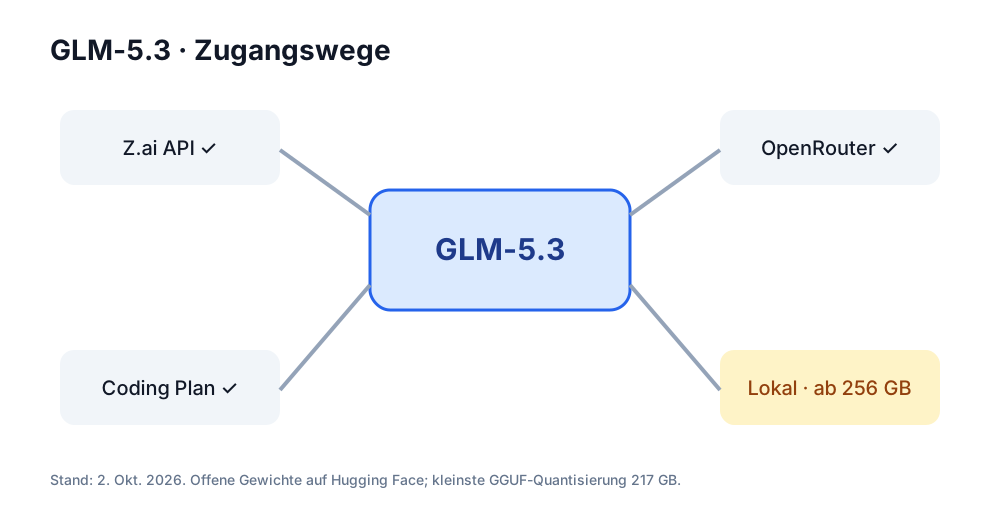
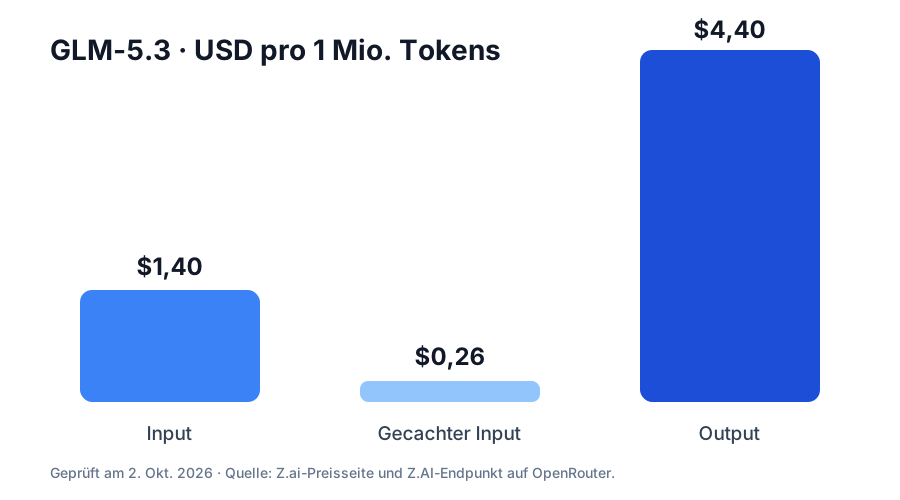
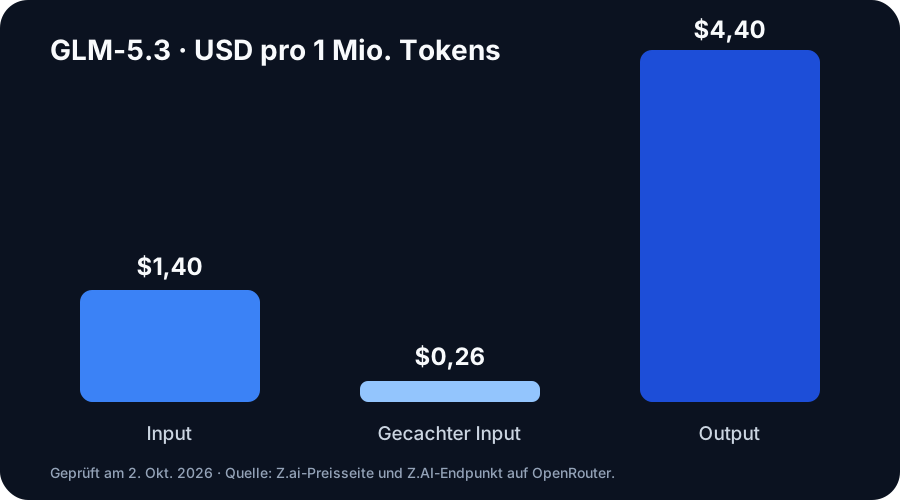
Stand: 2. Oktober 2026. GLM-5.3 kostet bei Z.ai 1,40 US-Dollar pro 1M Input-Tokens, 0,26 US-Dollar pro 1M gecachte Input-Tokens und 4,40 US-Dollar pro 1M Output-Tokens; auf OpenRouter (z-ai/glm-5.3) nennen 39 Provider-Endpunkte zwischen 0,12 und 2,80 US-Dollar für Input. Die Gewichte stehen seit dem 25. August unter einer freizügigen Lizenz auf Hugging Face: 753 Milliarden Parameter, rund 756 GB in FP8. Auf dem Mac kommt damit nur ein Mac Studio mit 256 oder 512 GB Unified Memory in Frage, denn schon die kleinste GGUF-Quantisierung von Unsloth ist 216,7 GB groß.
Beim ersten Faktencheck am 21. August hielt Z.ai die Gewichte noch für eine Sicherheitsprüfung zurück, die lokalen Anforderungen ließen sich nur schätzen. Diese Fassung ersetzt die Schätzungen durch den veröffentlichten Checkpoint, den Lizenztext, die echten GGUF-Dateigrößen und die aktuellen API-Preise. Selbst auf einem Mac getestet haben wir GLM-5.3 nicht; Geschwindigkeitswerte für Apple Silicon enthält dieser Artikel deshalb nicht.
GLM-5.3: die wichtigsten Daten
| Merkmal | GLM-5.3, Stand 2. Oktober 2026 | Quelle |
|---|---|---|
| Entwickler | Z.ai | Z.ai-Doku |
| Veröffentlichung | API-Start am 14. August 2026; offizielles Hugging-Face-Repository vom 25. August | Hugging Face |
| Basismodell | dasselbe Basismodell wie GLM-5.2, alle Verbesserungen aus dem Post-Training | Z.ai-Doku |
| Parameter | 753,3 Milliarden im Checkpoint; Mixture of Experts mit 256 Experten, davon 8 plus 1 geteilter Experte pro Token aktiv | Hugging Face, config.json |
| Gewichte | FP8, rund 756 GB; separates BF16-Repository | Hugging Face |
| Lizenz | GLM-5.3 License: freie Nutzung, Änderung und kommerzieller Einsatz; Sicherheitsprüfung nur für Model-as-a-Service-Anbieter über 10 Milliarden US-Dollar Jahresumsatz | LICENSE |
| Ein- und Ausgabe | Text rein, Text raus | Z.ai-Doku |
| Kontext und Output-Limit | 1M Tokens Kontext, bis zu 128K Output-Tokens | Z.ai-Doku |
| Reasoning | immer aktiv; Stufe low, high oder max, Standard max | Z.ai-Doku |
| API-Preis bei Z.ai | 1,40 $ Input, 0,26 $ gecachter Input, 4,40 $ Output pro 1M Tokens | Z.ai-Preise |
| OpenRouter | z-ai/glm-5.3, 39 Provider-Endpunkte, 0,12 bis 2,80 $ Input | OpenRouter |
| Ollama | nur glm-5.3:cloud, läuft auf den Servern von Ollama | Ollama |
| Lokal auf dem Mac | nur Mac Studio mit 256 oder 512 GB, GGUF-Dateien ab 216,7 GB | Unsloth-GGUF, Apple |
Läuft GLM-5.3 lokal auf dem Mac?
Ja, aber nur auf den größten Mac-Studio-Konfigurationen und nur stark komprimiert. Der offizielle FP8-Checkpoint braucht rund 756 GB, so viel bietet kein Mac. Apple verkauft den Mac Studio derzeit mit M5 Ultra und 256 oder 512 GB Unified Memory; jedes MacBook Pro, der Mac mini und der Mac Studio mit M5 Max enden bei 128 GB.
Für llama.cpp veröffentlicht Unsloth GGUF-Quantisierungen von GLM-5.3. Die Dateigrößen unten stammen aus der Dateiliste auf Hugging Face vom 2. Oktober 2026. Apples 256 und 512 GB sind binäre Gigabyte, in den dezimalen Einheiten von Hugging Face also rund 275 und 550 GB. Den Rest brauchen macOS, die Runtime und der KV-Cache für lange Kontexte.
| Unsloth-GGUF | Dateigröße | Realistischer Mac (unsere Einschätzung) |
|---|---|---|
| UD-IQ1_S | 216,7 GB | Mac Studio mit 256 GB, wenig Platz für Kontext |
| UD-IQ2_M | 238,6 GB | Mac Studio mit 256 GB, sehr knapp |
| UD-Q2_K_XL | 253,9 GB | Mac Studio mit 512 GB |
| UD-Q3_K_XL | 343,0 GB | Mac Studio mit 512 GB |
| UD-IQ4_XS | 365,3 GB | Mac Studio mit 512 GB |
| UD-Q4_K_XL | 467,3 GB | Mac Studio mit 512 GB, wenig Platz für Kontext |
| Q8_0 | 801,4 GB | kein Mac |
Wie viel Qualität die 1- bis 3-Bit-Dateien gegenüber Z.ais FP8-Betrieb behalten, haben wir nicht gemessen. Bevor du dich auf eine lokale Quantisierung verlässt, vergleiche ihre Antworten mit der API an deinen eigenen Aufgaben. Warum die Gewichte allein nicht entscheiden, ob ein Modell passt, erklärt der Unified-Memory-Guide.
Pro Token aktiviert GLM-5.3 nur 8 seiner 256 Experten plus einen geteilten Experten. Für die GLM-5-Basis nennt Z.ai 40 Milliarden aktive von 744 Milliarden Parametern. Der Rechenaufwand pro Token liegt damit weit unter dem eines gleich großen dichten Modells, doch für jedes erzeugte Token müssen aktive Gewichte aus dem Speicher gelesen werden; auf Apple Silicon begrenzt deshalb die Speicherbandbreite das Tempo.
Drei weitere Punkte für Mac-Nutzer:
- Ollama: Die Bibliothek führt nur
glm-5.3:cloud.ollama run glm-5.3:cloudschickt deine Prompts an die Server von Ollama; auf dem Mac läuft dabei nichts. - MLX: Stand 2. Oktober gibt es kein mlx-community-Release des vollen GLM-5.3, nur Konvertierungen einzelner Nutzer. Das kleinere GLM-5.3-Flash gibt es als 4-Bit-Version von mlx-community, doch auch die ist 204 GB groß.
- API aus Mac-Tools: Z.ais Coding Plan beginnt bei 18 US-Dollar im Monat, rechnet mit Punkten und funktioniert laut Z.ai mit Claude Code, Kilo Code, Cline und OpenCode. Aufrufe außerhalb der Stoßzeiten kosten die Hälfte der Punkte.
Für Macs mit bis zu 128 GB Unified Memory ist die Auswahl offener Modelle für 8 bis 64 GB der bessere Einstieg für lokales Arbeiten.
Was GLM-5.3 über die API kostet
Z.ais eigene Preisseite führt GLM-5.3 inzwischen direkt auf. Am 21. August stand dort nur GLM-5.2.
| Token-Art, Z.ai | Preis pro 1M Tokens |
|---|---|
| Input | 1,40 $ |
| Gecachter Input | 0,26 $ |
| Speicherung des gecachten Inputs | befristet kostenlos |
| Output | 4,40 $ |
Mit diesen Preisen kostet eine kurze Session mit 1M Input- und 0,2M Output-Tokens 2,28 US-Dollar. Ein mittlerer Agentenlauf mit 10M Input- und 2M Output-Tokens kostet 22,80 US-Dollar. In einem Workflow mit 100M Input-Tokens, davon 80M aus dem Cache, und 20M Output-Tokens beträgt die Rechnung 136,80 statt 228 US-Dollar ohne Cache, also 40 Prozent weniger.
Weil die Gewichte offen sind, bieten inzwischen viele Provider GLM-5.3 an. OpenRouter führt 39 Endpunkte. Eine Auswahl vom 2. Oktober 2026:
| Provider auf OpenRouter | Format | Input | Output | Gecachter Input |
|---|---|---|---|---|
| Z.AI | FP8 | 1,40 $ | 4,40 $ | 0,26 $ |
| Together | nicht angegeben | 1,40 $ | 4,40 $ | 0,26 $ |
| DeepInfra | FP4 | 0,56 $ | 2,50 $ | 0,12 $ |
| Novita | FP8 | 0,69 $ | 2,16 $ | 0,13 $ |
| Baidu | FP8 | 0,16 $ | 0,49 $ | 0,03 $ |
| Alibaba (fast) | nicht angegeben | 2,80 $ | 8,80 $ | 0,56 $ |
Quelle: OpenRouter-Endpunktliste. FP4- und NVFP4-Endpunkte betreiben eine stärker komprimierte Version als Z.ai mit FP8; teste die Ergebnisse, bevor du produktiven Verkehr an den günstigsten Provider schickst. Zusätzlich bietet OpenRouter z-ai/glm-5.3:batch für 0,45 $ Input und 2,00 $ Output für Aufgaben, die warten können, und z-ai/glm-5.3-prime, eine schnellere Variante für 2,80 und 8,80 $.
Benchmarks: wo GLM-5.3 vorn liegt und wo nicht
Alle Werte der folgenden Tabelle stammen aus der Model Card von Z.ai. Die Vergleichsspalte zeigt den besten Wert unter den acht Modellen, die Z.ai aufführt.
| Benchmark (Z.ai) | GLM-5.2 | GLM-5.3 | Bestes gelistetes Modell |
|---|---|---|---|
| Terminal-Bench 3.0 | 4,6 | 28,3 | GPT-5.6 Sol: 34,6 |
| DeepSWE v1.1 | 46,2 | 66,9 | GPT-5.6 Sol: 72,7 |
| SWE-Marathon v1.1 | 19,4 | 42,5 | Opus 4.8: 48,8 |
| CyberGym | 77,2 | 84,5 | GLM-5.3 |
| ExploitBench | 24,4 | 54,4 | Fable 5 (mit Fallback): 78,0 |
| AutomationBench v1.0.6 | 26,2 | 48,2 | GLM-5.3 |
| GDPval-AA v2 | 1.508 | 1.769 | GLM-5.3 |
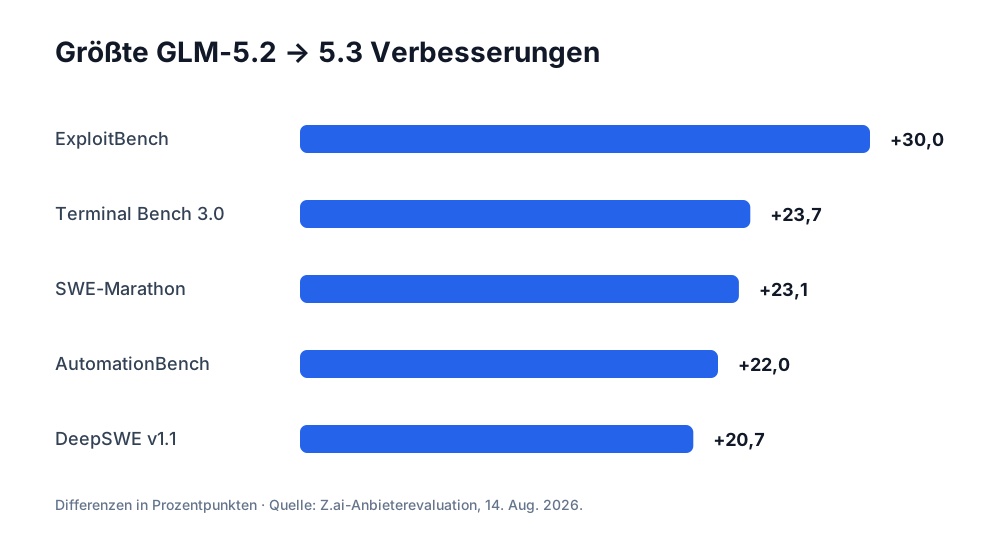
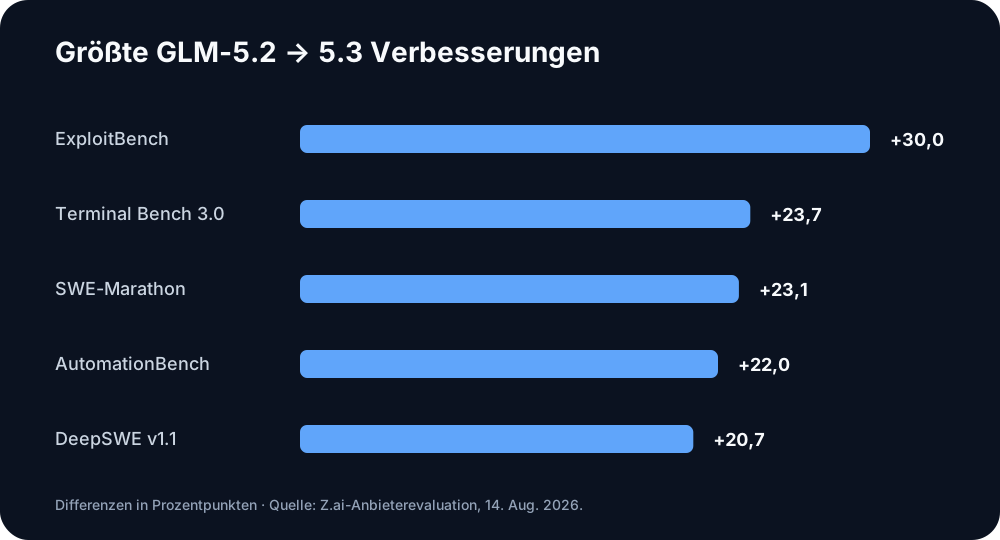
Das Muster passt zu Z.ais Trainingsansatz. Die größten Sprünge zeigen sich bei langen Terminal-Sitzungen, mehrstufiger Softwarearbeit, Automatisierung und Security-Aufgaben. Die „50 Prozent besser“ aus Z.ais Ankündigung beziehen sich auf Z.ai Code Bench, einen internen Benchmark: GLM-5.3 erreicht dort 34,5 statt 23,4 Prozent bei GLM-5.2 und braucht dafür weniger Output-Tokens pro Aufgabe. Von außen lässt sich dieser Test nicht nachprüfen.
Unabhängige Daten sind noch rar. OpenRouter zeigt für GLM-5.3 die Indizes von Artificial Analysis, Stand 2. Oktober: 44,8 für Intelligenz, 74,8 für Coding und 53,1 für Agentenaufgaben. Am Tag des Starts wies Reuters darauf hin, dass die Security-Ergebnisse nicht unabhängig geprüft waren. Z.ais Agentenergebnisse hängen außerdem vom Harness ab: Die Model Card nennt Claude Code 2.1.207, maximale Reasoning-Stufe und Kontexte bis 1M Tokens.
Warum Z.ai die Gewichte zum Start zurückhielt
GLM-5.3 nutzt dasselbe Basismodell wie GLM-5.2. Z.ai führt alle Verbesserungen auf weiteres Post-Training mit mehr ausführbaren Umgebungen und mehr Reinforcement Learning zurück, aufgebaut auf dem eigenen Open-Source-Framework slime. Mit wachsendem Post-Training stiegen die Security-Werte schneller als von Z.ai erwartet: CyberGym von 77,2 auf 84,5, ExploitBench von 24,4 auf 54,4.
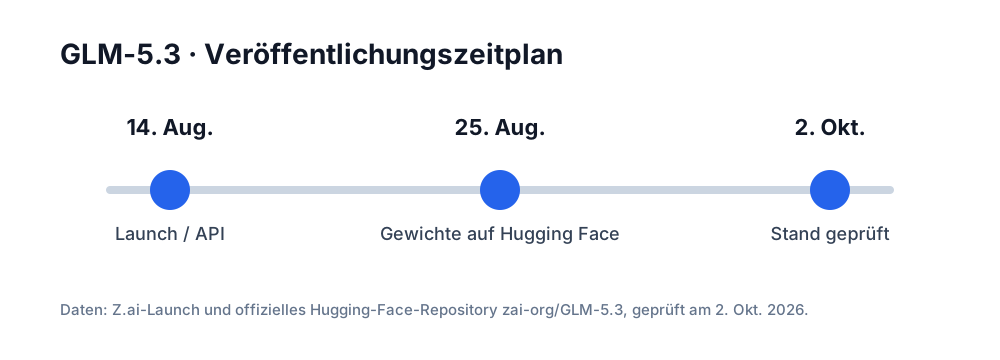
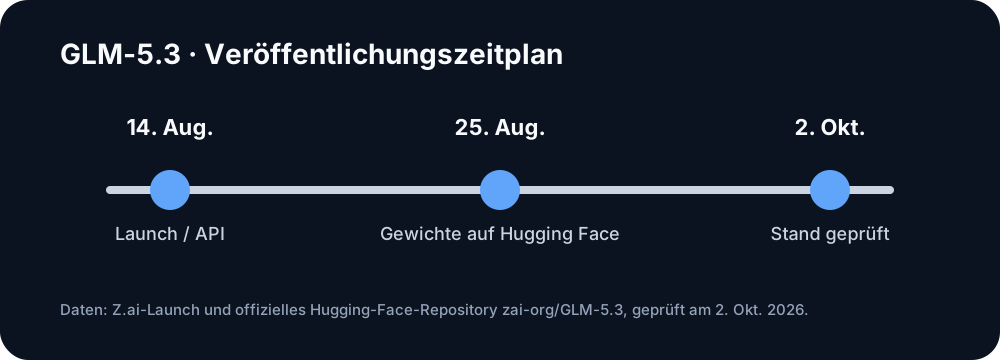
Weil Exploit-Fähigkeiten Angreifern ebenso nützen wie Verteidigern, startete Z.ai am 14. August nur die API und kündigte die Gewichte nach einer zusätzlichen Sicherheitsprüfung für etwa zwei Wochen später an. WIRED und Axios berichteten über die Verzögerung. Das offizielle Hugging-Face-Repository stammt vom 25. August, das GGUF-Repository von Unsloth folgte am 28. August.
GLM-5.3 per API aufrufen
Z.ai dokumentiert für GLM-5.3 drei Protokolle:
| Protokoll | Basis-URL |
|---|---|
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
| Anthropic Messages | https://api.z.ai/api/anthropic |
Reasoning lässt sich nicht mehr abschalten. Sendet eine bestehende Integration thinking.type: "disabled", soll man laut Z.ais Migrationshinweis zuerst auf enabled umstellen und reasoning_effort auf low setzen, bevor man die Modell-ID auf glm-5.3 ändert; sonst schlägt die Anfrage fehl. Für komplexe Coding-Aufgaben empfiehlt Z.ai max.
curl -X POST "https://api.z.ai/api/coding/paas/v4/chat/completions" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -d '{
    "model": "glm-5.3",
    "messages": [
      {"role": "user", "content": "Prüfe dieses Repository und schlage einen verifizierten Plan für den Bugfix vor."}
    ],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "max",
    "max_tokens": 4096
  }'
Wer die Gewichte selbst betreibt, sollte ein Detail aus der Model Card beachten: Im Chat-Template von GLM-5.3 ist clear_thinking standardmäßig false. Für Chat-Anwendungen empfiehlt Z.ai, clear_thinking=true mitzugeben.
Für wen sich GLM-5.3 lohnt und wer besser etwas anderes nimmt
Ein Test lohnt sich, wenn du:
- Coding-Agenten auf langen, mehrstufigen Aufgaben einsetzt,
- großen Repository-Kontext wiederholt sendest und vom gecachten Input für 0,26 $ profitierst,
- GLM-5.2 bereits über Z.ai nutzt, wo der Preis gleich geblieben ist,
- einen Mac Studio mit 512 GB besitzt und Code auf dem eigenen Rechner behalten willst, auch um den Preis eines stark quantisierten Modells.
Nimm besser etwas anderes, wenn du:
- Bilder oder Videos als Eingabe brauchst, denn GLM-5.3 liest nur Text (GLM-5.3-Flash ist multimodal),
- Antworten ohne Reasoning-Tokens brauchst,
- ein Modell lokal auf einem Mac mit 128 GB oder weniger betreiben willst,
- vor der Wahl eine lange Reihe unabhängiger Benchmarks sehen möchtest.
Was GLM-5.3 für Mac-Nutzer bedeutet
Für fast jeden Mac ist GLM-5.3 ein API-Modell: ab 1,40 $ Input und 4,40 $ Output pro 1M Tokens bei Z.ai und günstiger bei einigen OpenRouter-Providern, die stärker komprimierte Versionen betreiben. Die offenen Gewichte sind für Provider interessant und für Besitzer eines Mac Studio mit 256 oder 512 GB, die GGUF-Quantisierungen von 217 bis 467 GB laden können. Bevor du dafür Hardware kaufst, vergleiche die Qualität dieser Quantisierungen an deinen eigenen Aufgaben mit der API; auf einem Mac gemessen haben wir sie nicht.
Häufig gestellte Fragen
Sind die Gewichte von GLM-5.3 verfügbar?
Ja. Z.ai veröffentlicht sie auf Hugging Face als zai-org/GLM-5.3 in FP8, dazu ein separates BF16-Repository. Das offizielle Repository stammt vom 25. August 2026, elf Tage nach dem API-Start.
Ist GLM-5.3 Open Source?
GLM-5.3 ist ein Open-Weight-Modell unter der GLM-5.3 License. Nutzung, Änderung, Weitergabe und kommerzieller Einsatz sind erlaubt; nur Model-as-a-Service-Anbieter mit mehr als 10 Milliarden US-Dollar Umsatz in zwölf Monaten brauchen vorher eine Sicherheitsprüfung durch Z.ai.
Läuft GLM-5.3 lokal auf dem Mac?
Nur auf einem Mac Studio mit 256 oder 512 GB Unified Memory und mit einer stark quantisierten GGUF-Datei. Die kleinste Unsloth-Quantisierung ist 216,7 GB groß, Macs mit bis zu 128 GB nutzen deshalb die API.
Gibt es GLM-5.3 in Ollama?
Nur als glm-5.3:cloud. Dieser Tag läuft auf den Servern von Ollama, nicht lokal auf deinem Mac.
Was kostet GLM-5.3?
Z.ai berechnet 1,40 US-Dollar pro 1M Input-Tokens, 0,26 US-Dollar pro 1M gecachte Input-Tokens und 4,40 US-Dollar pro 1M Output-Tokens. Auf OpenRouter nennen 39 Provider-Endpunkte zwischen 0,12 und 2,80 US-Dollar für Input, Stand 2. Oktober 2026.
Wie groß sind Kontext und Output von GLM-5.3?
Z.ai dokumentiert ein Kontextfenster von 1M Tokens und bis zu 128K Output-Tokens. OpenRouter nennt 1.048.576 Tokens Kontext.
Kann man Reasoning deaktivieren?
Nein. GLM-5.3 arbeitet immer mit Reasoning. Unterstützt werden low, high und max, Standard ist max.
Welche Modell-ID nutze ich bei OpenRouter?
Nutze z-ai/glm-5.3. Der Alias ~z-ai/glm-latest zeigt derzeit auf dasselbe Modell, kann später aber auf eine neuere GLM-Version wechseln.
Ist GLM-5.3 besser als GLM-5.2?
Z.ai meldet große Sprünge in Coding- und Agentenbenchmarks, etwa Terminal-Bench 3.0 von 4,6 auf 28,3 und SWE-Marathon von 19,4 auf 42,5. Das sind Herstellerwerte, unabhängige Auswertungen gibt es bisher wenige.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- z.ai blog / glm-5.3
- docs.z.ai llm / glm-5.3
- docs.z.ai overview / pricing
- docs.z.ai overview / migrate-to-glm-new
- docs.z.ai devpack / overview
- huggingface.co zai-org / GLM-5.3
- huggingface.co main / LICENSE
- huggingface.co main / config.json
- huggingface.co zai-org / GLM-5.3-BF16
- huggingface.co zai-org / GLM-5
- huggingface.co unsloth / GLM-5.3-GGUF
- unsloth.ai models / GLM-5.3
- ollama.com library / glm-5.3
- openrouter.ai z-ai / glm-5.3
- openrouter.ai v1 / models
- openrouter.ai glm-5.3-20260816 / endpoints
- apple.com mac-studio / specs
- github.com THUDM / slime
- github.com sunblaze-ucb / cybergym
- github.com exploitbench / exploitbench
- reuters.com technology / chinas-zai-says-new-model-nears-anthropics-mythos-5-cyber-defence-tests-2026-08-14
- wired.com story / zai-open-weight-ai-models-release-cybersecurity-hacking
- axios.com 14 / china-open-source-ai-glm-53