Aktualisiert am 9. Oktober 2026. Die Launch-Benchmarks stammen weiterhin aus der August-Veröffentlichung; Provider-Limits und Preise wurden dagegen neu anhand der Anbieter überprüft. Tencent hat Hy4 preview am 28. August 2026 veröffentlicht und die Modellgewichte öffentlich bereitgestellt. Das Modell nutzt eine Mixture-of-Experts-Architektur mit 770 Milliarden Gesamtparametern und 49 Milliarden aktivierten Parametern pro Token. Offiziell werden 1 Million Token Kontext angegeben; Tencent Cloud konkretisiert dies für seine API auf 1024k Kontext, maximal 960k Input und 64k Output. 123
Der wichtigste Vorbehalt steht ebenso früh: Die auffälligen Benchmarkwerte, die am Veröffentlichungstag kursieren, sind überwiegend Tencent-eigene Resultate. Sie sind interessant, aber noch kein Ersatz für unabhängige, reproduzierbare Tests. Tencent selbst bezeichnet Hy4 ausdrücklich als frühe Version und nennt unter anderem zu langes Reasoning und übermäßige Selbstverifikation als bekannte Schwächen. 2
Aktueller Stand
- Modell: Tencent Hy4 preview
- Release: 28. August 2026
- Architektur: MoE, 770B gesamt / 49B aktiv
- Kontext: 1M; Tencent Cloud: 1024k Fenster, 960k max. Input, 64k max. Output
- Lizenz: Apache 2.0
- API: Tencent Cloud TokenHub und OpenRouter
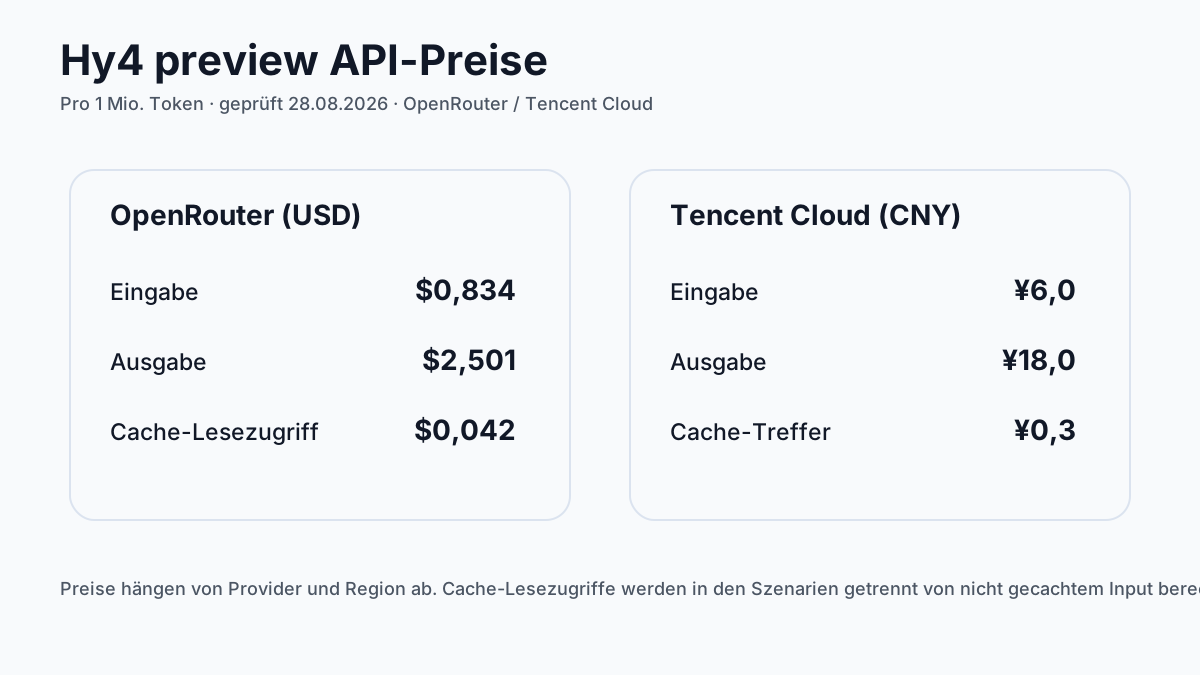
- OpenRouter-Preis: $0,834/M Input, $2,501/M Output, $0,042/M Cache Read
- Tencent-Cloud-Preis: 6 CNY/M Input, 18 CNY/M Output, 0,3 CNY/M Cache-Hit
- Self-Hosting: technisch möglich, aber die offiziellen Serving-Rezepte zielen auf große Multi-GPU-Server; MXFP8-Gewichte liegen laut SGLang bei rund 760 GB
- Benchmarkstatus: stark, aber aktuell überwiegend herstellerberichtet
Was Hy4 preview technisch ist
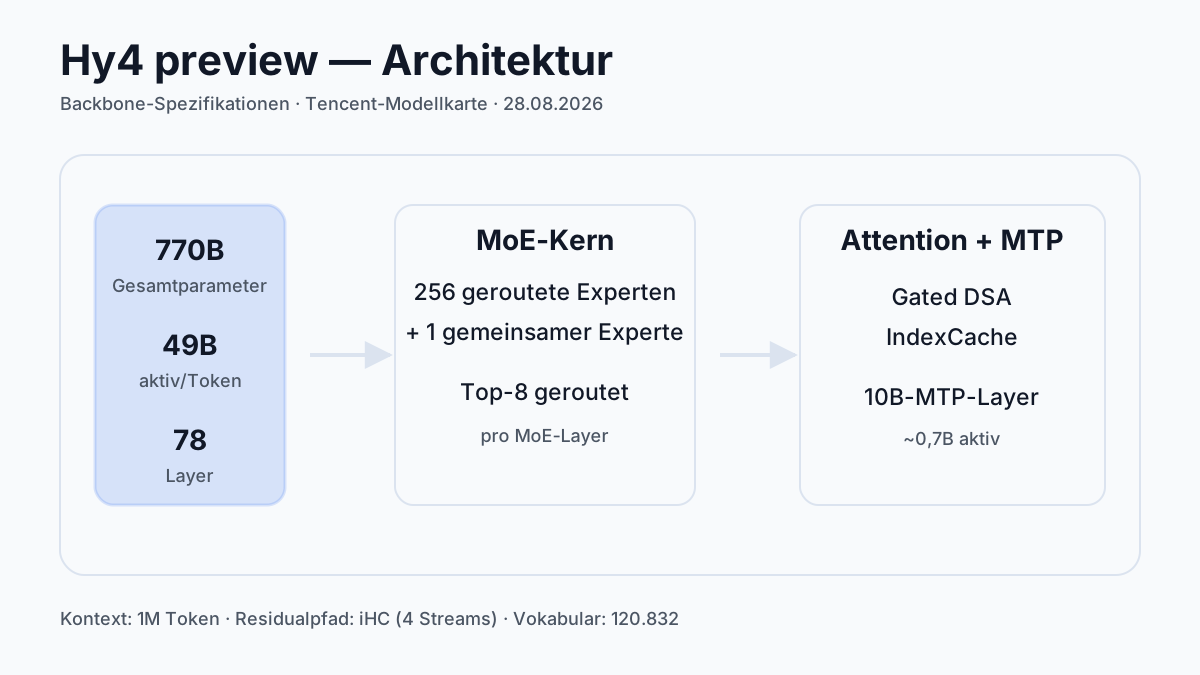
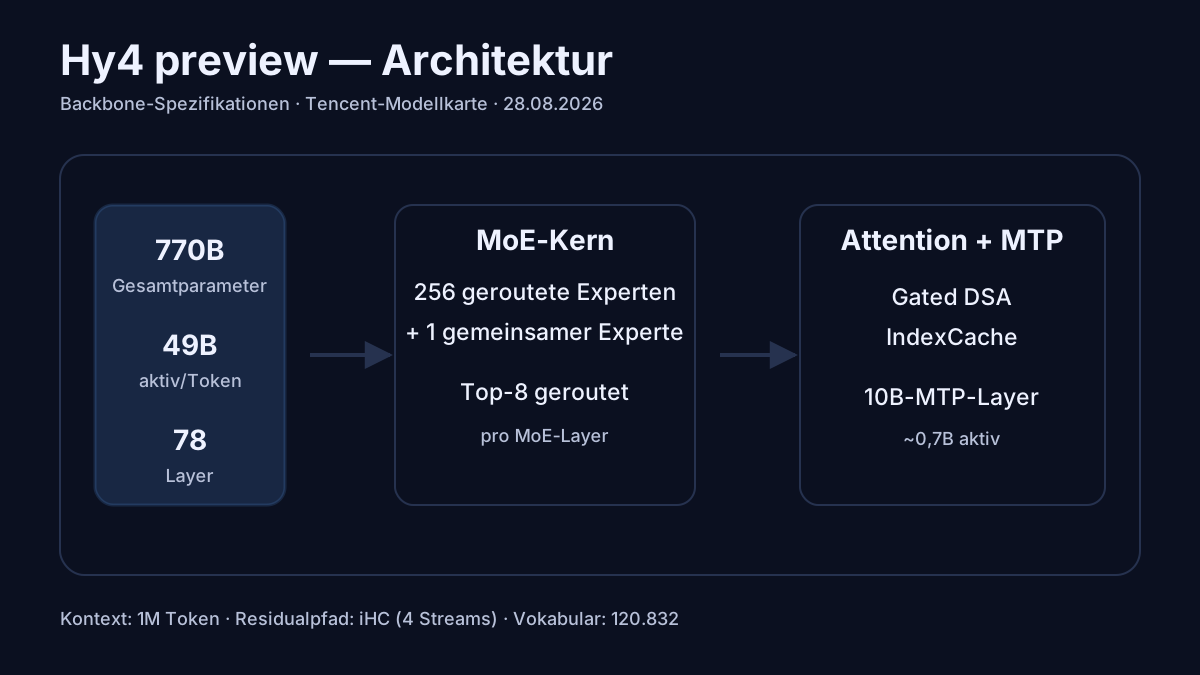
Hy4 preview ist kein dichtes 770B-Modell, bei dem für jedes Token alle Parameter rechnen. Tencent verwendet Mixture of Experts (MoE): Der Backbone besitzt 78 Layer. Der erste nutzt einen dichten Feed-Forward-Block, die restlichen 77 MoE. Pro MoE-Layer gibt es 256 geroutete Experten plus einen gemeinsamen Experten; pro Token werden die Top-8 der gerouteten Experten aktiviert. Dadurch stehen 770B Parameter im Modell, während im Backbone pro Token 49B aktiv sind. 2
Zusätzlich enthält Hy4 eine native MTP-Schicht (Multi-Token Prediction) mit 10B Gesamtparametern und ungefähr 0,7B aktiven Parametern. Sie ist für spekulatives Decoding vorgesehen. Für Aufmerksamkeit nennt Tencent Gated DeepSeek Sparse Attention (Gated DSA) zusammen mit IndexCache; die Residualverbindungen verwenden iHC (identity Hyper-Connections) mit vier Residual-Streams. 24
IndexCache ist nicht bloß ein Marketingname. Die zugehörige Forschungsarbeit beschreibt die Wiederverwendung sparsamer Attention-Indizes über Layer hinweg, um Indexer-Rechenarbeit zu reduzieren. Die dort gemessenen Beschleunigungen dürfen allerdings nicht direkt als Hy4-End-to-End-Speed gelesen werden: Die Arbeit evaluiert eigene Versuchsaufbauten, nicht exakt den veröffentlichten Hy4-Service. 4
Hy3 preview zu Hy4 preview
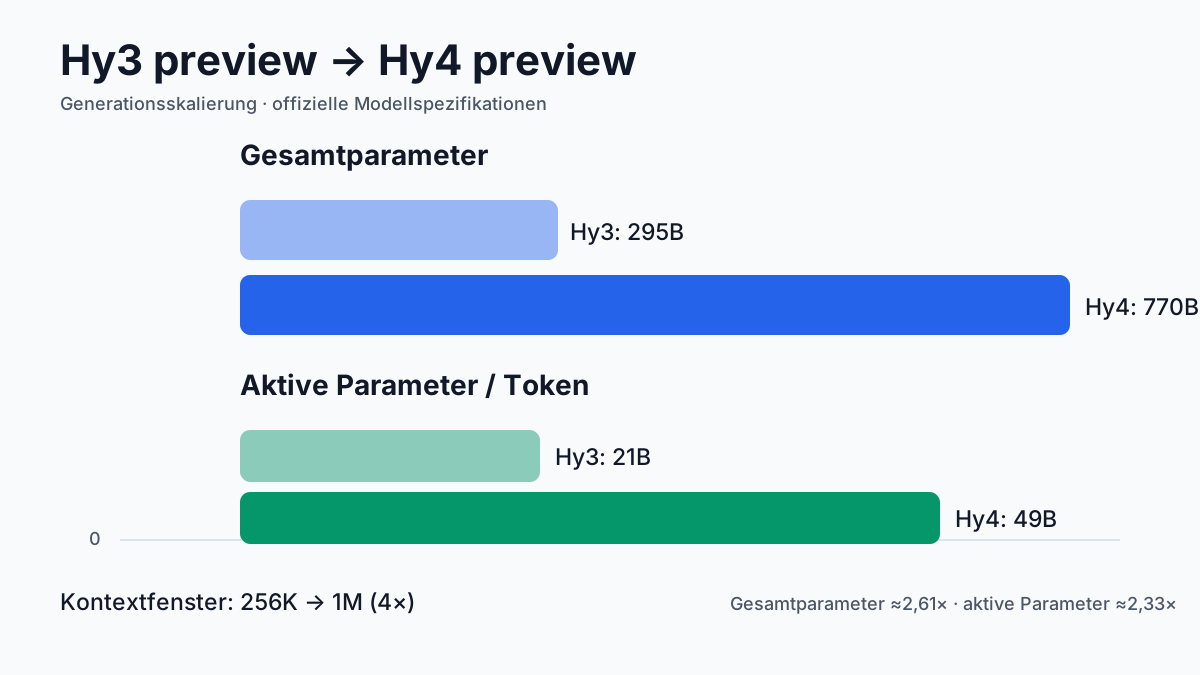
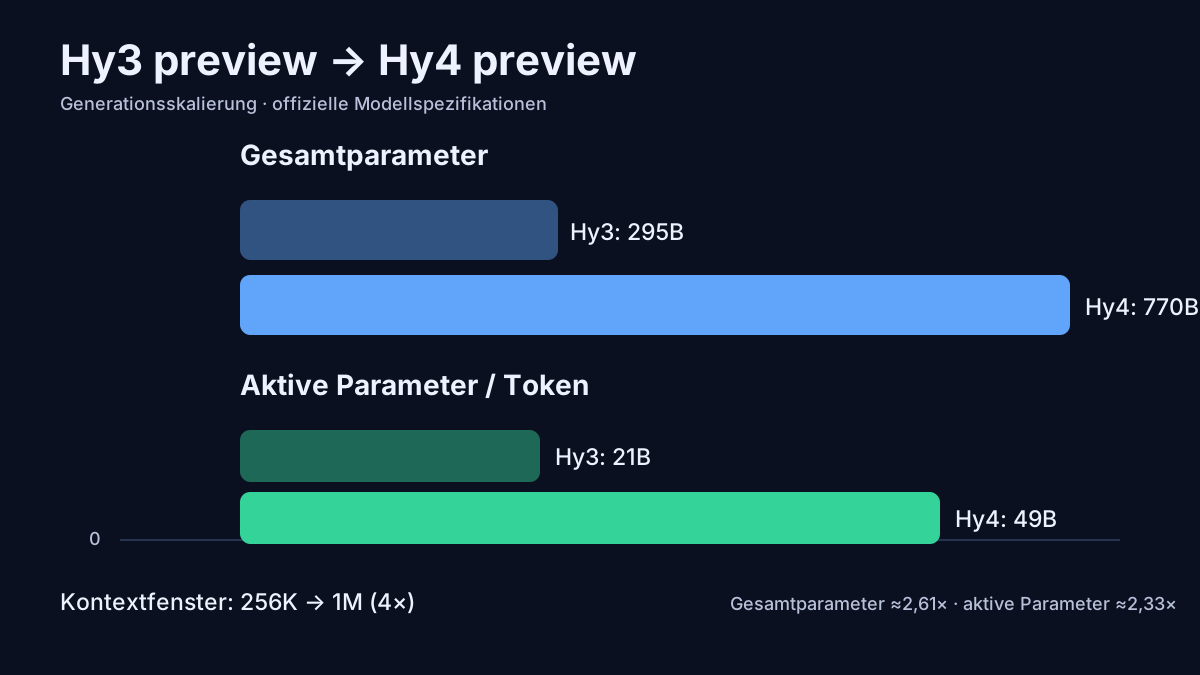
Der Generationssprung ist groß. Hy3 preview hatte 295B Gesamtparameter, 21B aktive Parameter und 256K Kontext. Hy4 preview liegt bei 770B, 49B und 1M. Das entspricht rechnerisch etwa 2,61× mehr Gesamtparametern, 2,33× mehr aktiven Parametern und 4× so viel nominalem Kontext. 52
Für den Vorgänger und den OpenRouter-Zugang gibt es einen eigenen Überblick: Tencent Hy3 im OpenRouter-Kontext.
Das erklärt aber nicht automatisch die Qualitätssteigerung. Tencent führt sie zusätzlich auf mehr Trainingsdaten sowie größere Pre- und Post-Training-Läufe zurück. Ohne veröffentlichte vollständige Trainingsdaten und unabhängige Ablationen lässt sich der jeweilige Anteil dieser Faktoren nicht sauber trennen. 12
1M Kontext: Was tatsächlich nutzbar ist
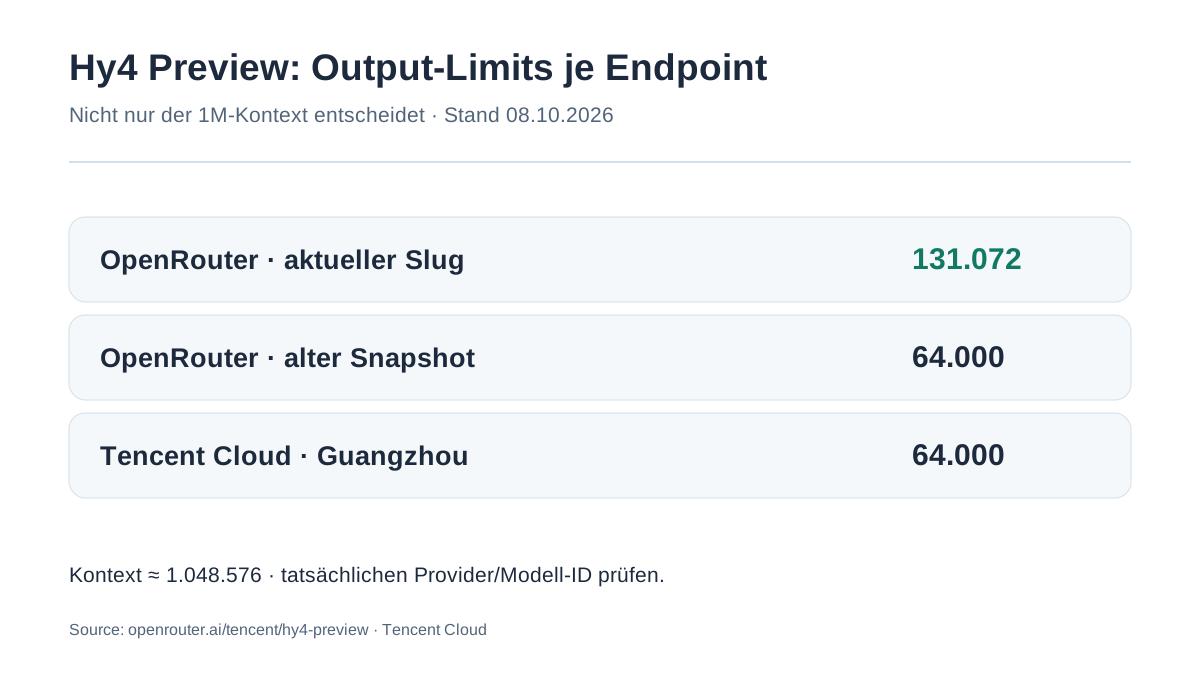
Die Modellkarte nennt etwa eine Million Tokens Kontext. Der aktuelle OpenRouter-Eintrag tencent/hy4-preview führt 1.048.576 Kontext- und bis zu 131.072 Output-Tokens. Ältere datierte OpenRouter-Snapshots wie tencent/hy4-preview-20260827 zeigen hingegen noch 64.000 Output-Tokens. Tencent Cloud dokumentiert für den eigenen hy4-preview-Endpunkt 1024K Gesamtkontext, 960K maximalen Input und 64K Output. Für produktiven Code daher Slug, Provider, Version und deren tatsächliches Output-Limit getrennt prüfen. OpenRouter aktuell · historischer Snapshot · Tencent Cloud.
Diese Zahlen sind nicht widersprüchlich: Ein Kontextfenster ist das Gesamtbudget, während ein API-Anbieter zusätzlich einen maximalen Input reservieren kann, damit Platz für die Ausgabe bleibt. Für Anwendungen sollte deshalb statt der bloßen „1M“-Angabe das konkrete Limit des tatsächlich verwendeten Endpoints in die Architekturentscheidung eingehen.
Ein zweiter Unterschied ist praktisch wichtiger als die Zahl im Datenblatt: Das Modell kann 1M unterstützen, doch lokales oder selbst gehostetes Serving benötigt ausreichend KV-Cache. SGLang empfiehlt je nach GPU und Präzision deutlich kleinere Startwerte wie 262K und weist ausdrücklich darauf hin, das Kontextlimit an das verfügbare KV-Budget anzupassen. 6
Anbieter-/Snapshot-Grenzen im Vergleich
Bei OpenRouter gelten die auf der aktuellen Modellseite beworbenen 131.072 Ausgabetokens nicht automatisch für eine alte datierte Revision oder den direkt genutzten Tencent-Cloud-Endpunkt. Die tatsächliche Verfügbarkeit ist beim Routing und bei der Provider-Auswahl zu prüfen. OpenRouter aktuell · datierter Snapshot.
API, Reasoning, Tools und strukturierte Ausgabe
Tencent Cloud dokumentiert Kompatibilität mit OpenAI Chat Completions, OpenAI Responses und Anthropic Messages. Tool Calling und strukturierte Ausgabe per JSON Schema werden dokumentiert. Der Reasoning-Modus steht standardmäßig auf high; für direkte Antworten kann ein No-Think-Modus verwendet werden. 3
OpenRouter bestätigt für seinen Endpoint ebenfalls Tool Calling über tools/tool_choice sowie strukturierte Ausgaben über ein JSON Schema. 7
Für Entwickler ist das relevant, weil Hy4 dadurch über ein reines Chatmodell hinaus als Backend für Agenten- und Workflow-Systeme positioniert wird. Trotzdem ist API-Kompatibilität nicht identisch mit vollständiger Verhaltensgleichheit zu anderen Anbietern: Parser, Reasoning-Felder, Tool-Call-Details und Fehlerfälle müssen im eigenen Stack getestet werden.
Was Hy4 preview für Mac-Nutzer bedeutet
Hy4 preview ist für einen Mac vor allem ein Cloud-Modell oder ein Remote-Server, kein lokales Desktop-Modell. Der Mac kann trotzdem der sinnvolle Kontrollpunkt sein: Er filtert Dateien, startet den Agenten, führt freigegebene Shell-Befehle aus und protokolliert Kosten sowie Fehler. Die Inferenz findet beim gewählten API-Anbieter oder auf einem entfernten Multi-GPU-Host statt.
| Dein Ziel | Sinnvoller Mac-Pfad | Vor dem Einsatz prüfen |
|---|---|---|
| Coding-Agent mit lokalem Repository | API-Client auf dem Mac, nur ausgewählte Dateien senden | Datenschutz, Tool-Rechte, Retries und Tokenkosten |
| Offline- oder vertrauliche Arbeit | kleineres lokales Modell über Ollama, MLX oder llama.cpp | ob der Workflow wirklich ohne Websuche, Plugins und Cloud-Fallback läuft |
| Hy4 selbst betreiben | Mac als Entwicklungs- und Kontrollrechner, Serving auf Remote-GPUs | SSH-/API-Absicherung, Modellversion, KV-Cache und laufende Infrastrukturkosten |
| 1M-Kontext testen | zunächst API-Limit mit einem kontrollierten Dokument prüfen | tatsächliches Input-Limit, Cache-Regeln, Latenz und Retrieval-Qualität |
Der wichtigste Datenfluss ist dabei nicht der Download der Gewichte, sondern der Prompt: Quellcode, Screenshots, Terminalausgaben und Tool-Ergebnisse verlassen den Mac, sobald der API-Weg genutzt wird. Ein lokaler Agent kann die Auswahl und Maskierung dieser Daten steuern, macht Hy4 aber nicht zu einem lokalen Modell. Für einen fairen Vergleich sollte derselbe Mac-Workflow einmal mit einem kleinen lokalen Fallback und einmal mit Hy4 laufen; gemessen werden sollten Erfolgsrate, Gesamttokens, Tool-Call-Fehler, Zeit und Kosten pro abgeschlossenem Task.
Preise: billig für die Größenklasse, aber Cache verändert die Rechnung
Deutschland: US-Dollar, chinesischer Cloud-Endpunkt und EU-Daten
Für deutsche Nutzer sind USD-Routertarife nicht automatisch Euro-Bruttopreise. Steuern, Zahlungswährung, Wechselkurs und mögliche Provider-Aufschläge hängen vom konkreten Rechnungspartner ab. Der Tencent-Cloud-Tarif in CNY bezieht sich auf Guangzhou und beweist weder Preisgleichheit mit einem europäischen Standort noch EU-Datenresidenz. OpenRouter kann Anfragen über verschiedene Upstreams – etwa DeepInfra, NovitaAI oder SiliconFlow – leiten. Ein deutschsprachiger Prompt erzwingt keine Verarbeitung innerhalb der EU. Bei Kundencode oder personenbezogenen Daten zuerst Endpunkt, Provider, DPA, Logging und Drittlandübermittlungen prüfen. OpenRouter-Providerübersicht.
Lizenz: Hy4 ist nicht MiniMax H3
Tencent bietet Hy4 Preview unter Apache 2.0 an. Diese Lizenz ist nicht mit der territorial eingeschränkten MiniMax-H3-Community-Lizenz zu verwechseln. Die Möglichkeit zur lokalen Nutzung hängt bei Hy4 vor allem an Rechenzentrumshardware und den Lizenzpflichten, nicht an der für H3 dokumentierten EU-Ausschlussklausel. Tencent Hy4 Lizenz.
Geprüft am 9. Oktober 2026: OpenRouter listet 0,834 USD ungecachten Input / 2,501 USD Output / 0,042 USD Cache-Read pro Million Tokens. Tencent Cloud zeigt für den dokumentierten Standort Guangzhou 6 CNY Input / 18 CNY Output / 0,3 CNY Cache-Hit. Diese Beträge betreffen verschiedene Verträge und Währungen und sind nicht als identische globale Endkundenpreise zu lesen. OpenRouter · Tencent Cloud.
Drei reproduzierbare Kostenszenarien
Die Szenarien unten wenden die veröffentlichten Tarife an. Uncached Input wird zum Inputpreis berechnet; Cache Reads werden separat zum Cache-Read-Tarif abgerechnet.
Formel OpenRouter:
Kosten = Input_M × 0,834 + Output_M × 2,501 + CacheRead_M × 0,042
| Szenario | Uncached Input | Output | Cache Read | OpenRouter | Tencent Cloud |
|---|---|---|---|---|---|
| Leicht | 2M | 0,5M | 10M | $3,34 | 24 CNY |
| Mittel | 20M | 5M | 100M | $33,39 | 240 CNY |
| Intensiv | 200M | 50M | 1.000M | $333,85 | 2.400 CNY |
Die Cache-Rate ist bei dokumentenlastigen Agenten potenziell besonders relevant. Die Rechnung gilt jedoch nur, wenn die wiederverwendeten Tokens tatsächlich als Cache-Hit abgerechnet werden. Cache-Semantik, TTL und Provider-Verhalten sollten deshalb vor einer Kostenprognose im Zielsystem geprüft werden.
Benchmarks: starke Zahlen, noch schwache Unabhängigkeit
Am Release-Tag nennt Tencent eine breite Benchmarkpalette. Ein Hugging-Face-Metadaten-PR extrahiert beispielsweise 65,7 auf SWE-Bench Pro aus der Modellkarte. Eine Sekundäranalyse transkribiert unter anderem 85,4 auf Terminal-Bench 2.1, 82,9 auf SWE-bench Multilingual, 64,3 auf DeepSWE, 92,3 auf GPQA Diamond, 74,1 auf Toolathlon-Verified, 83,7 auf MCP-Atlas und 55,4 auf Humanity’s Last Exam mit Tools. 12
| Benchmark | Hy4 preview | Evidenzstatus am 28.08.2026 |
|---|---|---|
| GPQA Diamond | 92,3 | Tencent-reported |
| Terminal-Bench 2.1 | 85,4 | Tencent-reported |
| MCP-Atlas | 83,7 | Tencent-reported |
| SWE-bench Multilingual | 82,9 | Tencent-reported |
| Toolathlon-Verified | 74,1 | Tencent-reported |
| SWE-Bench Pro (public) | 65,7 | Tencent-reported |
| DeepSWE | 64,3 | Tencent-reported |
| HLE mit Tools | 55,4 | Tencent-reported |
| APEX-Agents | 37,1 | Tencent-reported |
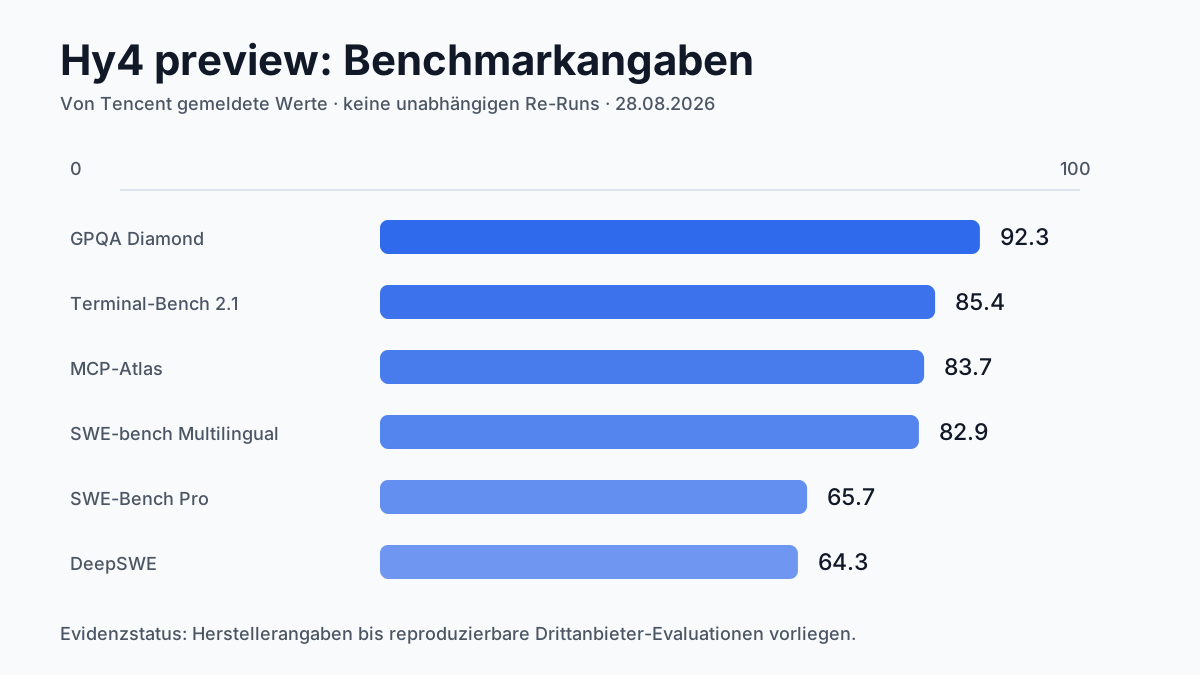
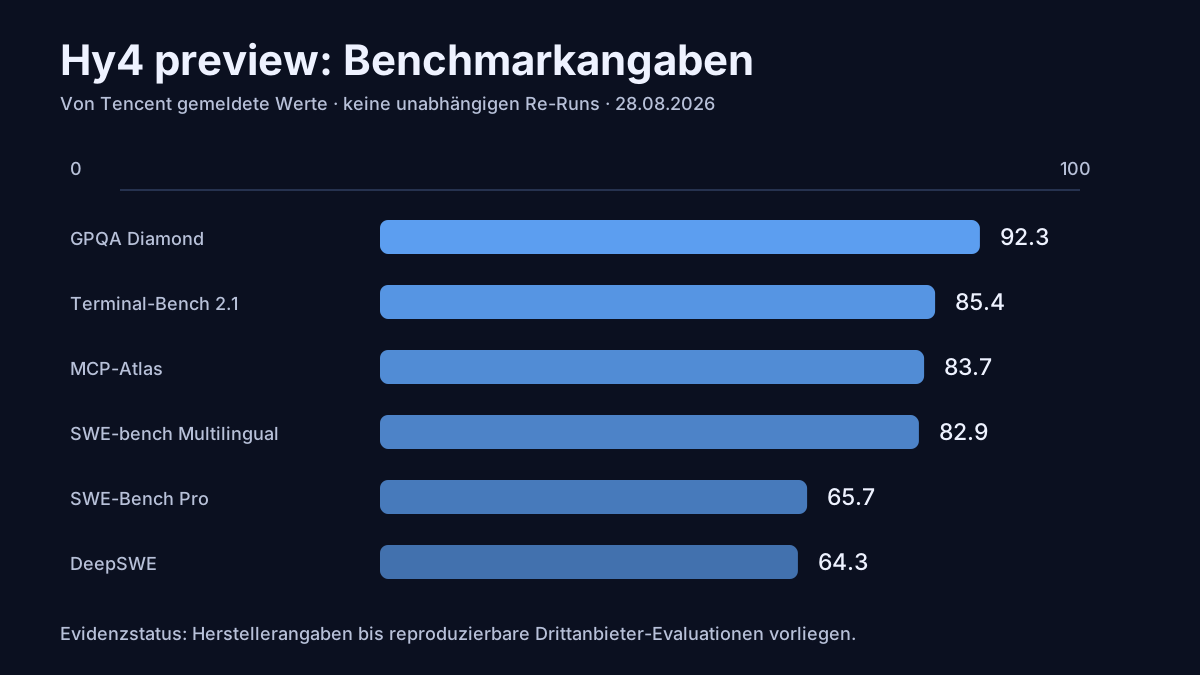
Die Kennzeichnung „Tencent-reported“ heißt hier nicht „falsch“. Sie bedeutet, dass bislang keine reproduzierbare Drittanbieter-Evaluation mit identischem Modell, Agent-Harness, Toolzugriff, Sampling, Budget und Benchmarkversion vorliegt. Gerade Agentenbenchmarks sind stark von Harness und Umgebung abhängig. Terminal-Bench 2.1 selbst wurde beispielsweise gegenüber früheren Versionen überarbeitet, um fehlerhafte oder driftende Tasks zu korrigieren. 8
Der interne Blindtest ist interessant, aber kein unabhängiger Sieg
Tencent ließ 163 interne Experten 203 Engineering-Aufgaben blind bewerten. Hy4 preview erreichte 2,99/4, GLM 5.3 2,92/4 und Kimi K3 2,94/4. Im direkten Vergleich gegen GLM 5.3 nennt Tencent 46,8% Siege, 12,8% Gleichstände und 40,4% Niederlagen; gegen Kimi K3 51,2% / 7,9% / 40,9%. 2
Die nüchterne Lesart: Hy4 lag in diesem internen Setup knapp vorne, nicht dominant. Die Bewerter waren Tencent-Mitarbeiter und die Aufgaben stammen aus Tencent-internen Produktivitätskontexten. Das macht den Test praxisnah für Tencent, aber nicht unabhängig.
Self-Hosting: offene Gewichte bedeuten nicht lokale Leichtigkeit
Die Gewichte sind offen verfügbar und Hy4 preview steht unter Apache 2.0. Das ist ein starkes Signal für Entwicklernutzung und Weiterverteilung unter den Bedingungen der Lizenz. 9
Die Hardwareanforderungen bleiben jedoch massiv. SGLang beziffert die BF16-Gewichte auf ungefähr 1,5 TB und den MXFP8-Checkpoint auf ungefähr 760 GB. Die Dokumentation führt B200/B300/GB300-Konfigurationen auf und behandelt den verfügbaren KV-Speicher separat. 6
Das offizielle vLLM-Rezept fasst die Zielklasse als 16×B200 oder 8×B300 mit MTP zusammen; das Beispiel startet den FP8-Checkpoint mit Tensor Parallel Size 8. 10
Damit ist Hy4 zwar self-hostbar, aber kein realistisches „einfach auf dem Laptop laden“-Modell. Auch wenn weitere Quantisierungen entstehen, sollte man Speicherbedarf, Qualitätsverlust, Kernel-Support und maximale Kontextlänge getrennt betrachten. Eine kleinere Quantisierung löst nicht automatisch das KV-Cache-Problem eines 1M-Kontexts.
Was Tencent selbst als Schwäche nennt
Tencent nennt zwei konkrete bekannte Probleme: Hy4 preview kann bei komplexen Aufgaben länger als nötig nachdenken und die eigene Arbeit übermäßig verifizieren. Zugleich bezeichnet das Team die Veröffentlichung ausdrücklich als frühe Hy4-Version mit weiterem Spielraum in Pre- und Post-Training. 2
Das ist für Agenten wichtig. Mehr Reasoning kann die Qualität erhöhen, aber auch Latenz und Outputkosten treiben. Anwender sollten deshalb neben Benchmarks auch Aufgaben mit klaren Budgets testen: Zeit bis zur ersten brauchbaren Lösung, Gesamttokens, Tool-Calls, Fehlversuche und Kosten pro erfolgreich abgeschlossenem Task.
Wie gut ist Hy4 preview also?
Am 8. Oktober 2026 ist Hy4 Preview vor allem für kontrollierte API-Vergleiche relevant. Die Open-Weight-Lizenz und Modellarchitektur sind dokumentiert; das API-Limit hängt vom konkreten Anbieter beziehungsweise Snapshot ab. Die Benchmark-Tabelle enthält weiterhin überwiegend Tencent-gemeldete Launchwerte, keine von dieser Redaktion unabhängig nachgemessenen Scores.
Für API-Nutzer ist das Modell deshalb sofort testenswert, insbesondere wenn lange Kontexte und Cache Reads eine große Rolle spielen. Für Self-Hosting ist es ein Rechenzentrumsprojekt. Und für Benchmark-Vergleiche sollte die Rangfolge noch nicht als endgültig behandelt werden.
Was ein belastbarer Vergleich messen muss
Ein belastbarer Vergleich sollte Hy4 preview, GLM 5.3 und Kimi K3 mit demselben Agent-Harness, denselben Tools, identischen Token-/Zeitbudgets und identischen Aufgaben vergleichen. Neben Erfolgsrate sollten mindestens Kosten, Gesamttokens, Latenz, Tool-Call-Fehler, Wiederholungen und Verifikationsschleifen erfasst werden. Erst dann lässt sich aus „gute Benchmarktabelle“ eine belastbare Kauf- oder Deploymententscheidung machen.
Quellen und Reproduzierbarkeit
Das sind drei getrennte Ausgabelimits statt einer universellen Grenze: Der aktuelle OpenRouter-Eintrag nennt 131.072 Output-Tokens, der ältere datierte Snapshot 20260827 und Tencent Cloud nennen jeweils 64.000. Vor einer produktiven Anfrage mit 100.000 Ausgabetokens muss der tatsächlich verwendete Anbieter geprüft werden. Dieser Artikel enthält keine selbst durchgeführten 1M-Kontext- oder Apple-Silicon-Benchmarks; die Kostenbeispiele sind Berechnungen aus Listenpreisen.
Verlinkte Belege
Footnotes
Häufig gestellte Fragen
Was ist Tencent Hy4 preview?
Tencent Hy4 preview ist ein offenes Mixture-of-Experts-Modell mit 770B Gesamtparametern und 49B aktiven Parametern pro Token. Tencent beschreibt außerdem 1M Kontext.
Wie viel kostet Tencent Hy4 preview pro Million Tokens?
OpenRouter listet $0,834 für Input, $2,501 für Output und $0,042 für Cache Reads pro Million Token. Tencent Cloud zeigt für die dokumentierte Guangzhou-Region 6, 18 und 0,3 CNY.
Kann man Hy4 preview lokal ausführen?
Ja, die Gewichte sind offen verfügbar. Die Serving-Dokumentation nennt jedoch ungefähr 760 GB für MXFP8 und 1,5 TB für BF16 sowie Multi-GPU-Konfigurationen. Das ist kein typisches Laptop-Deployment.
Sind die Hy4-Benchmarks unabhängig verifiziert?
Nein. Die veröffentlichten Launch-Werte sind überwiegend Herstellerangaben oder Transkriptionen der Modellkarte. Eine reproduzierbare Drittanbieter-Evaluation mit identischem Modell, Harness und Budget steht noch aus.
Wie unterscheidet sich Hy4 preview von Hy3 preview?
Hy3 preview wird mit 295B Gesamtparametern, 21B aktiven Parametern und 256K Kontext beschrieben. Hy4 preview kommt auf 770B, 49B und 1M.
Welche API-Limits hat Hy4 preview?
Der aktuelle OpenRouter-Eintrag listet 1.048.576 Kontext und bis zu 131.072 Output-Tokens. Der datierte Snapshot 20260827 und Tencent Cloud nennen weiterhin 64.000 Output-Tokens; Tencent Cloud begrenzt den Input zusätzlich auf 960K.