Stand: 29. September 2026
Anthropic hat Claude Sonnet 5.5 am 28. September 2026 veröffentlicht. Das Modell behält den API-Preis von Sonnet 5 bei, soll laut Anthropic aber deutlich schneller und effizienter arbeiten. Gleichzeitig gibt es mehrere API-Änderungen, die bei einer direkten Migration von Sonnet 5 zu Fehlern führen können.
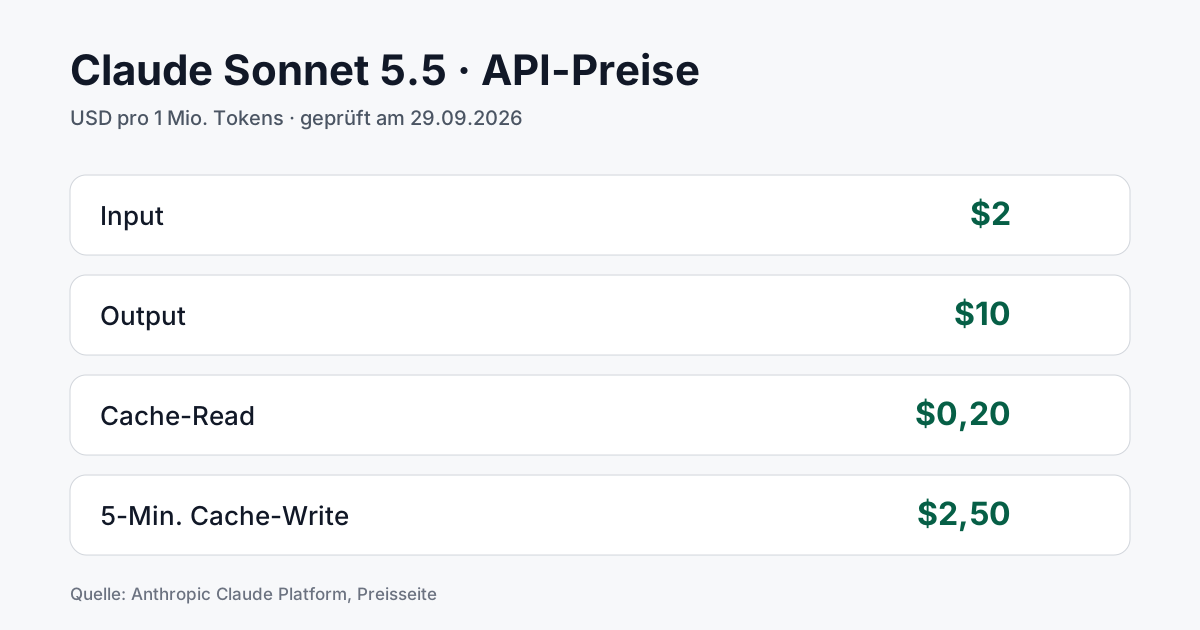
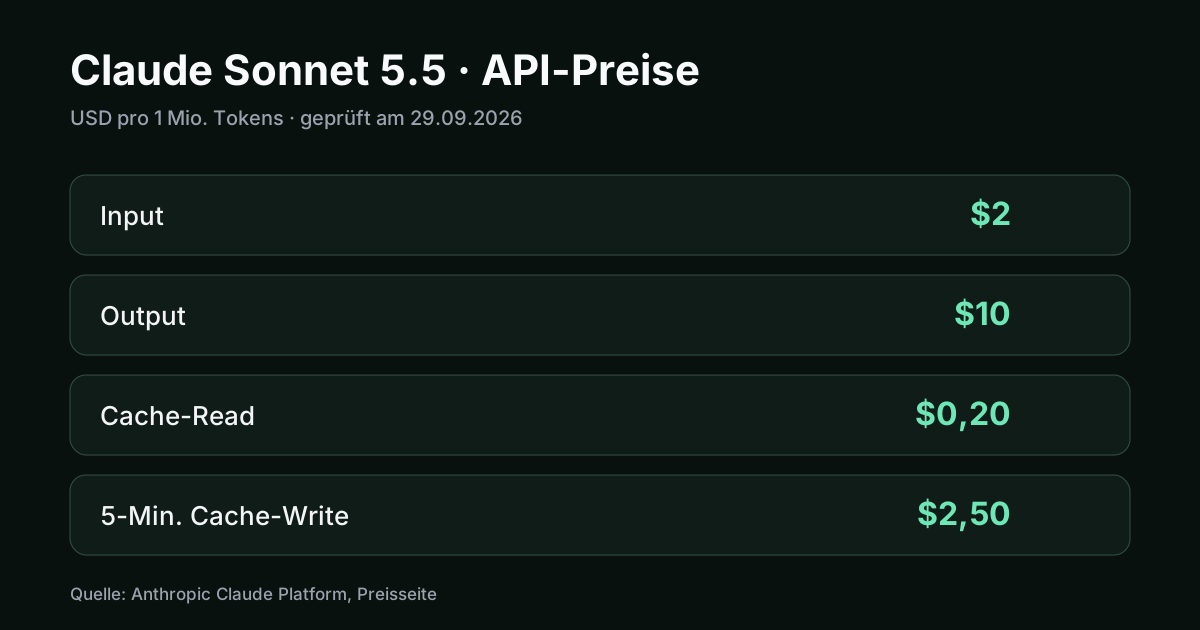
Die wichtigsten Eckdaten: 1 Million Tokens Kontext, 128.000 reguläre maximale Output-Tokens und $2 pro Million Input- sowie $10 pro Million Output-Tokens. Prompt-Cache-Reads kosten $0,20 pro Million Tokens.
Claude Sonnet 5.5 ist kein einfaches Preisupdate. Der Tokenpreis bleibt unverändert, Anthropic meldet jedoch höhere Geschwindigkeit, bessere Coding- und Agentenleistung und geringere Kosten pro erledigter Aufgabe. Für bestehende Integrationen sind insbesondere Thinking, Tool Choice und anbieterspezifische Modell-IDs relevant.
Claude Sonnet 5.5 auf einen Blick
| Merkmal | Claude Sonnet 5.5 |
|---|---|
| Veröffentlichung | 28. September 2026 |
| Claude-API-ID | claude-sonnet-5-5 |
| Kontextfenster | 1.000.000 Tokens |
| Reguläres Outputlimit | 128.000 Tokens |
| Batch-Output-Beta | bis 300.000 Tokens |
| Inputpreis | $2 / 1 Mio. Tokens |
| Outputpreis | $10 / 1 Mio. Tokens |
| 5-Minuten-Cache-Write | $2,50 / 1 Mio. Tokens |
| 1-Stunden-Cache-Write | $4 / 1 Mio. Tokens |
| Cache-Read | $0,20 / 1 Mio. Tokens |
| Thinking | Adaptive |
| Standard-Effort in der API | High |
| Knowledge Cutoff | Juni 2026 |
| Training Cutoff | Juni 2026 |
Quelle: Anthropic Claude Platform, geprüft am 29. September 2026.
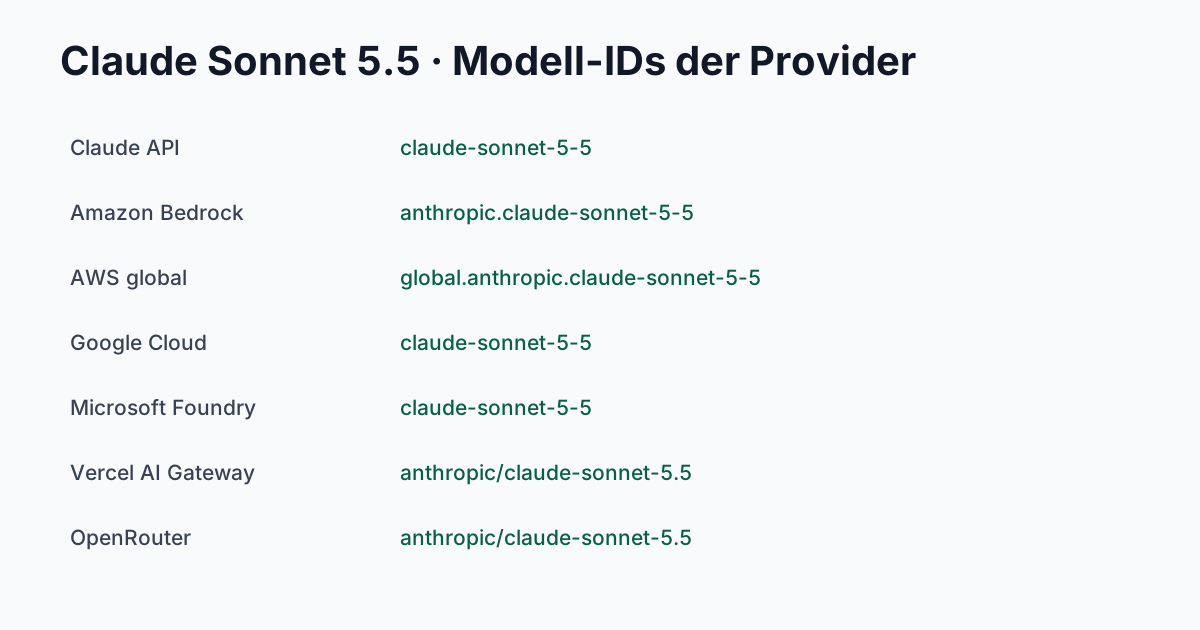
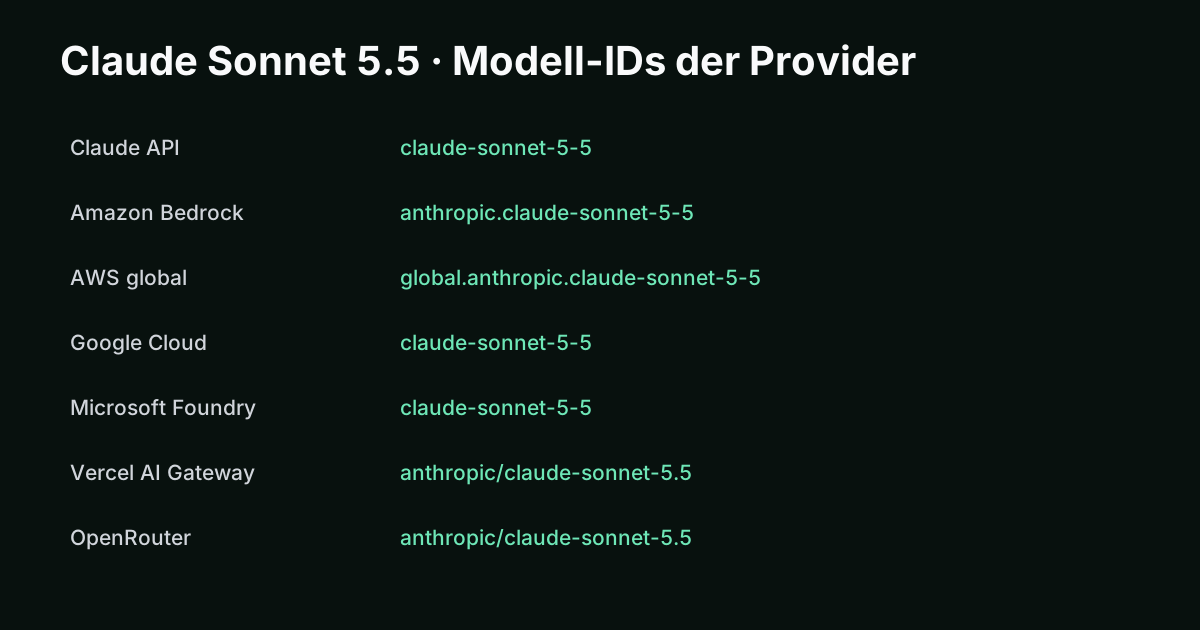
anthropic/claude-sonnet-5.5 oder claude-sonnet-5-5?
Beides kann korrekt sein – aber nicht auf derselben Plattform.
- Claude API:
claude-sonnet-5-5 - Vercel AI Gateway:
anthropic/claude-sonnet-5.5 - OpenRouter:
anthropic/claude-sonnet-5.5 - Amazon Bedrock:
anthropic.claude-sonnet-5-5 - AWS Global Inference:
global.anthropic.claude-sonnet-5-5 - Google Cloud:
claude-sonnet-5-5 - Microsoft Foundry:
claude-sonnet-5-5
Diese Unterscheidung ist technisch relevant: Wer eine Gateway-ID direkt in die native Anthropic SDK übernimmt, verwendet nicht die korrekte native Modellbezeichnung.
Was verbessert Sonnet 5.5 gegenüber Sonnet 5?
Anthropic nennt zwei zentrale Verbesserungen:
- mehr als 30 % höhere Ausgabegeschwindigkeit
- bis zu 30 % geringere Kosten pro erledigter Aufgabe
Der zweite Punkt ist leicht misszuverstehen. Der Listenpreis pro Token ist nicht gesunken. Sonnet 5 und Sonnet 5.5 kosten beide $2 pro Million Input- und $10 pro Million Output-Tokens.
Anthropic führt die geringeren Aufgabenkosten stattdessen auf weniger benötigte Tokens und Tool-Aufrufe zurück. Das ist eine Effizienzbehauptung und keine pauschale 30-%-Rabattgarantie.
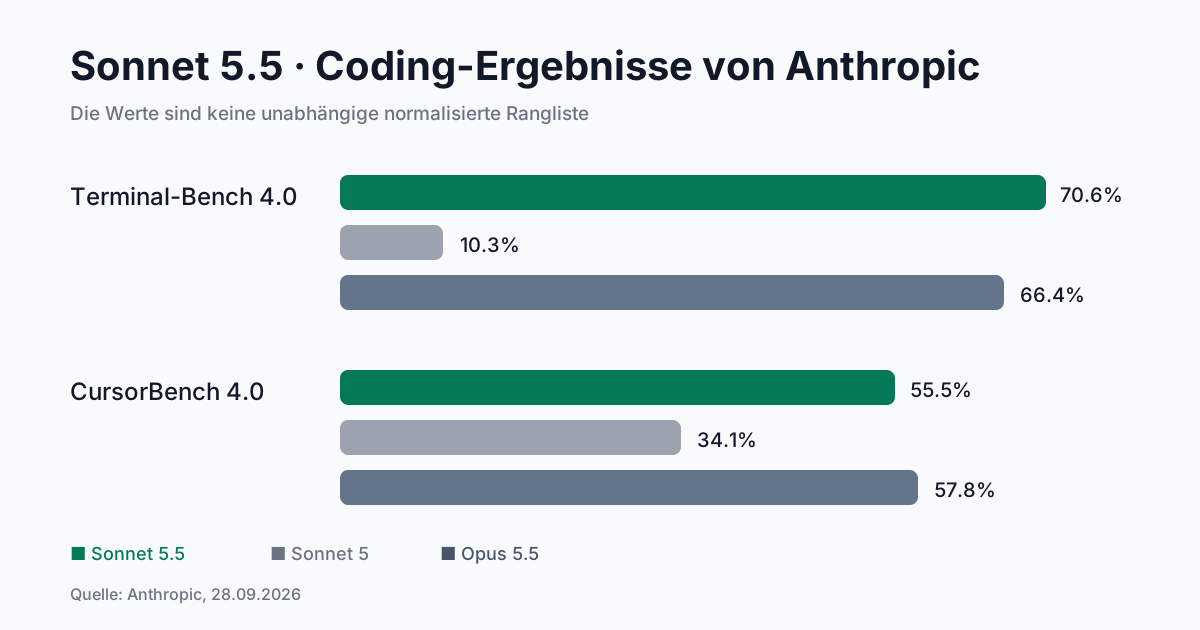
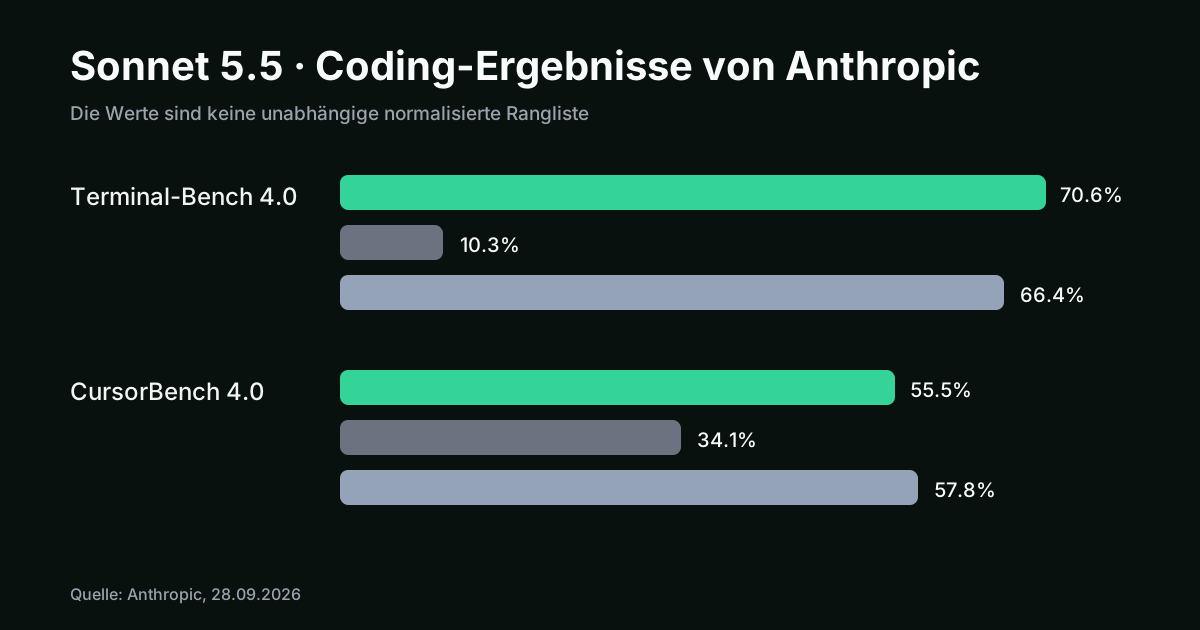
Benchmarks: besonders stark bei Coding und Agenten
Anthropic berichtet unter anderem:
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % |
| FrontierCode 1.1 | 46,2 % Max / 52,1 % Xhigh | 42,4 % | 54,4 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 |
Diese Werte stammen aus Anthropics Launchmaterial und sind deshalb Hersteller-Benchmarks.
Wichtige Beobachtung: Max Effort ist nicht automatisch besser
Auf FrontierCode erreicht Sonnet 5.5 laut Anthropic mit Xhigh 52,1 %, mit Max dagegen 46,2 %.
Anthropic erklärt das damit, dass Max häufiger zusätzliche Code-Review-Subagenten einsetzte. Das führte in einigen Fällen zu Timeouts oder zu Änderungen außerhalb des eigentlichen Aufgabenbereichs.
Für reale Deployments bedeutet das: Effort-Level sollten mit eigenen Evals getestet werden.
Was zeigen unabhängige Benchmarks?
Vals AI meldet für Sonnet 5.5 einen Vals Index von 69,22 ± 0,96 %. Das Modell erreicht dort unter anderem:
- Code Migration: 69,83 %
- Vibe Code Bench v1.1: 92,39 %
- Terminal-Bench 4.0: 53,03 %
Der Terminal-Bench-Wert liegt deutlich unter Anthropics 70,6 %. Daraus folgt nicht automatisch, dass einer der beiden Werte falsch ist.
Agentische Benchmarks reagieren stark auf Unterschiede bei:
- Harness
- Effort-Level
- Tool-Konfiguration
- Timeouts
- Fallbacks
- Agent-Loop
Hersteller- und unabhängige Benchmarkwerte sollten deshalb getrennt dargestellt werden.
Was kostet Claude Sonnet 5.5 praktisch?
Ein Request mit 10.000 Input-Tokens und 2.000 Output-Tokens kostet ohne Cache:
- Input: 10.000 / 1.000.000 × $2 = $0,02
- Output: 2.000 / 1.000.000 × $10 = $0,02
- Gesamt: $0,04
1.000 identische Aufrufe mit dieser Tokenverteilung kosten damit ungefähr $40 reine Tokenkosten.
Prompt Caching
Wenn von 10.000 Input-Tokens bei einem Folgeaufruf 8.000 Tokens aus dem Cache gelesen werden:
- 2.000 neue Input-Tokens: $0,004
- 8.000 Cache-Read-Tokens: $0,0016
- 2.000 Output-Tokens: $0,02
- Gesamt: $0,0256
Der vorherige Cache-Write wird separat berechnet.
Batch API
Nicht zeitkritische Batch-Verarbeitung reduziert reguläre Input- und Outputpreise um 50 % auf effektiv $1 / $5 pro Million Tokens.
Die wichtigsten Breaking Changes
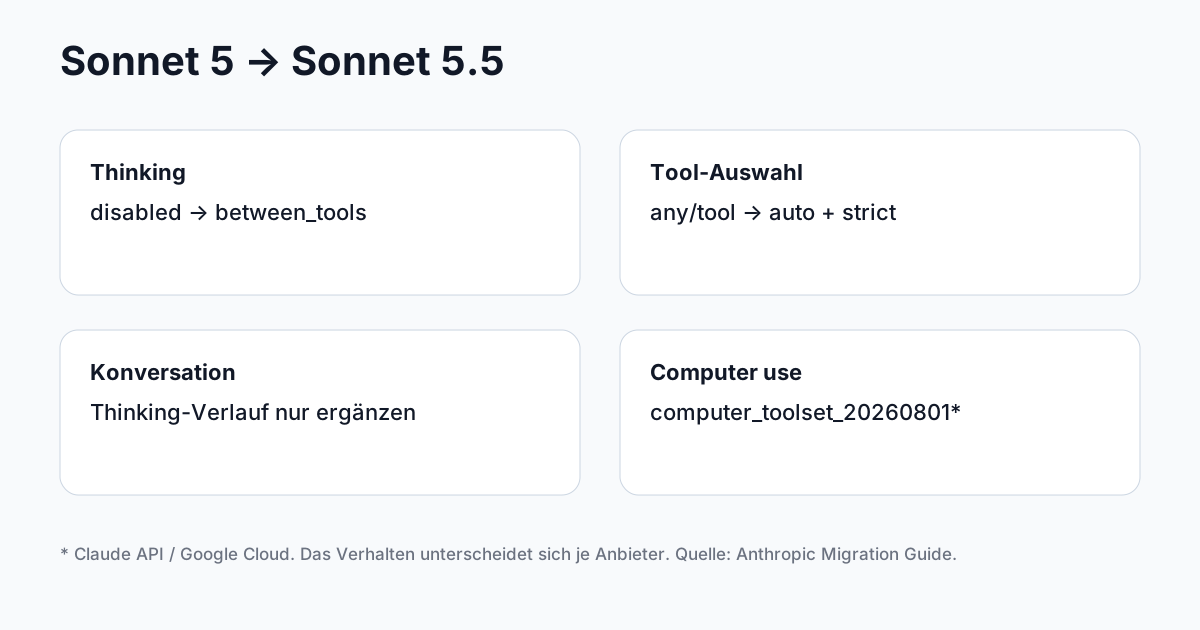
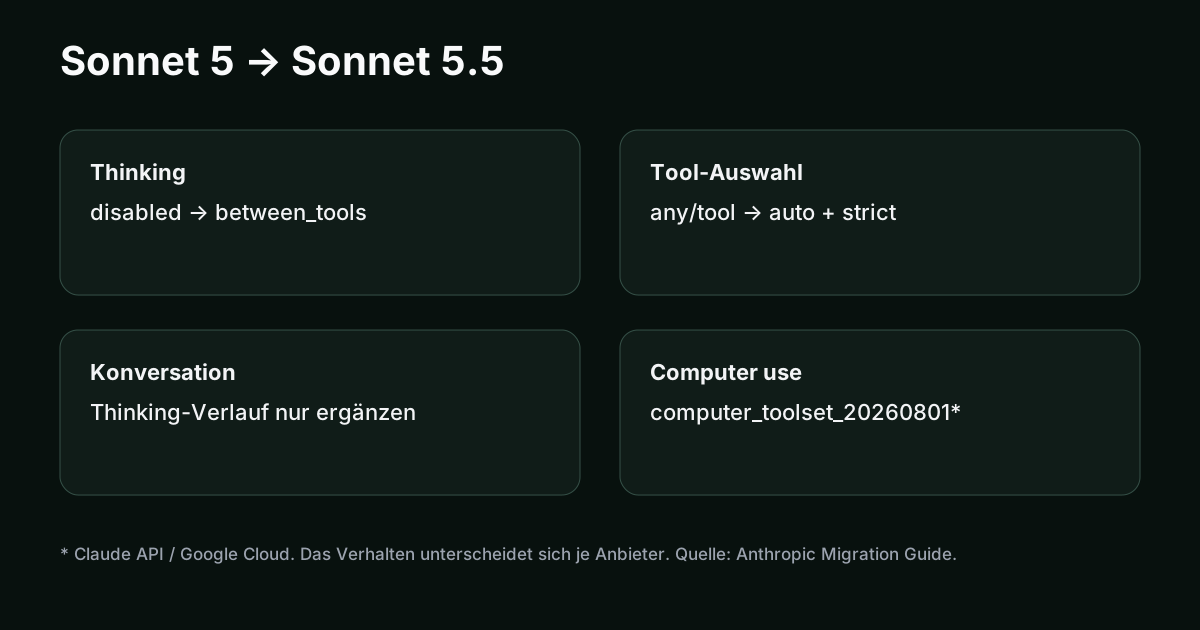
1. thinking: disabled funktioniert nicht mehr
Sonnet 5 akzeptierte:
{"thinking":{"type":"disabled"}}Sonnet 5.5 lehnt diese Konfiguration ab.
Für weniger Upfront-Reasoning steht stattdessen zur Verfügung:
{"thinking":{"type":"between_tools"}}between_tools funktioniert bei Low, Medium und High Effort. Xhigh und Max verwenden Adaptive Thinking.
2. Forced Tool Choice fällt weg
tool_choice: any und ein erzwungenes konkretes Tool werden nicht mehr unterstützt.
Anthropic empfiehlt automatische Auswahl und bei Bedarf Strict Tool Use.
3. Thinking-Blöcke sind stärker an Modell und Conversation gebunden
Gespräche mit Sonnet 5.5 sollten im Regelfall append-only behandelt werden. Nachträgliche Änderungen an älteren Messages, Tools oder Systemprompts können vorhandene Thinking-Blöcke ungültig machen.
4. Computer Use wurde geändert
Für Claude API und Google Cloud wird statt computer_20251124 das neuere computer_toolset_20260801 benötigt. Provider können sich dabei unterscheiden.
5. Effort-Level neu evaluieren
Low, Medium, High, Xhigh und Max sollten nicht als direkt identische Fortsetzung der Sonnet-5-Stufen behandelt werden.
Kontextfenster und Output
Claude Sonnet 5.5 bietet:
- 1.000.000 Tokens Kontext
- 128.000 reguläre Output-Tokens
- bis 300.000 Output-Tokens über Batch-Beta
Das Outputlimit ist nicht mit dem Kontextfenster zu verwechseln.
Claude Sonnet 5.5 vs. Opus 5.5
| Modell | Input / 1 Mio. | Output / 1 Mio. |
|---|---|---|
| Sonnet 5.5 | $2 | $10 |
| Opus 5.5 | $4 | $20 |
Sonnet 5.5 kostet damit pro regulärem Input- und Output-Token halb so viel wie Opus 5.5.
Anthropic positioniert Sonnet 5.5 für klar definierte Coding-, Agenten- und Knowledge-Work-Aufgaben, während Opus 5.5 bei besonders komplexen, offenen Aufgaben stärker positioniert bleibt.
Für wen lohnt sich Sonnet 5.5?
Sonnet 5.5 ist besonders interessant für:
- Coding-Agenten
- automatisierte Tool-Workflows
- lange Dokumentkontexte
- Knowledge-Work
- Anwendungen mit hohem Tokenvolumen
- Workflows, in denen Opus-Qualität nicht zwingend erforderlich ist
Weniger sinnvoll ist ein pauschaler Wechsel ohne eigene Tests, wenn ein Workflow empfindlich auf Tool-Verhalten, Reasoning-Level oder Agent-Loops reagiert.
Fazit: Migration vor Feature-Denken
Claude Sonnet 5.5 kombiniert ein 1M-Kontextfenster, relativ niedrige $2/$10 API-Preise und eine Leistung, die in mehreren Hersteller- und unabhängigen Benchmarks nahe an die Flaggschiffklasse heranreicht.
Der wichtigste praktische Punkt ist jedoch die Migration: Sonnet 5.5 ist nicht in jeder Konfiguration ein vollständig kompatibler Drop-in-Replacement für Sonnet 5.
Thinking, Tool Choice, Conversation State, Computer Use und Effort-Level sollten vor einem Produktionswechsel gezielt geprüft werden.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Claude Sonnet 5 und Sonnet 5.5?
Sonnet 5.5 wurde am 28. September 2026 veröffentlicht. Der Token-Preis bleibt bei 2 US-Dollar pro Million Input- und 10 US-Dollar pro Million Output-Tokens, Anthropic nennt aber über 30 Prozent schnellere Ausgabe und bis zu 30 Prozent geringere Kosten pro erledigter Aufgabe. Die API verhält sich anders: Thinking Disabled und erzwungene Tool-Auswahl entfallen.
Wie hoch sind die API-Kosten für Claude Sonnet 5.5?
Ein Request mit 10.000 Input- und 2.000 Output-Tokens kostet ohne Cache 0,04 US-Dollar. 1.000 solcher Requests kosten rund 40 US-Dollar. Kommen 8.000 der Input-Tokens aus dem Prompt-Cache, sinkt derselbe Request auf 0,0256 US-Dollar. Über die Batch-API gelten 50 Prozent niedrigere Raten, also effektiv 1 und 5 US-Dollar pro Million Tokens.
Welche Modell-ID nutze ich für Claude Sonnet 5.5?
In der Claude API heißt das Modell claude-sonnet-5-5, bei OpenRouter und Vercel AI Gateway anthropic/claude-sonnet-5.5, bei Amazon Bedrock anthropic.claude-sonnet-5-5 und für AWS Global Inference global.anthropic.claude-sonnet-5-5. Eine Gateway-ID funktioniert nicht automatisch im nativen Anthropic-SDK.
Kann ich Sonnet 5.5 direkt für Sonnet 5 einsetzen?
Nicht in jeder Konfiguration. Die Option thinking disabled wird mit einem 400-Fehler abgelehnt, stattdessen gibt es between_tools. Erzwungene Tool-Auswahl mit tool_choice any oder einem festen Tool wird nicht mehr unterstützt. Gespräche sollten append-only behandelt werden, und Computer Use verlangt unter Claude API und Google Cloud das Toolset computer_toolset_20260801.
Lohnt sich der Wechsel auf Sonnet 5.5 für Agenten-Workflows?
Für Coding-Agenten, automatisierte Tool-Workflows und lange Dokumentkontexte ist Sonnet 5.5 naheliegend, weil das 1M-Kontextfenster erhalten bleibt und die Coding-Benchmarks deutlich über Sonnet 5 liegen. Bei workflows, die auf Tool-Verhalten oder Agent-Loops reagieren, sollten Thinking, Tool-Auswahl und Effort-Level vorher mit eigenen Tests geprüft werden.
Warum weichen die Benchmark-Werte von Anthropic und Vals AI ab?
Anthropic meldet für Sonnet 5.5 auf Terminal-Bench 4.0 70,6 Prozent, Vals AI dagegen 53,03 Prozent. Agentische Benchmarks reagieren stark auf Harness, Effort-Level, Tool-Konfiguration, Timeouts und Fallbacks. Kein Wert ist deshalb automatisch falsch, beide sollten getrennt und mit Methodik-Label dargestellt werden.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- anthropic.com claude-sonnet-5-5
- platform.claude.com sonnet-5-5 / overview
- platform.claude.com sonnet-5-5 / whats-new-sonnet-5-5
- platform.claude.com sonnet-5-5 / migration-guide
- platform.claude.com about-claude / pricing
- platform.claude.com build-with-claude / extended-thinking
- platform.claude.com build-with-claude / prompt-caching
- platform.claude.com build-with-claude / effort
- platform.claude.com build-with-claude / preserved-thinking
- aws.amazon.com machine-learning / introducing-claude-sonnet-5-5-on-aws
- docs.cloud.google.com claude / sonnet-5-5
- learn.microsoft.com concepts / models-from-partners
- vercel.com changelog / claude-sonnet-5-5-now-available-on-ai-gateway
- vals.ai models / anthropic_claude-sonnet-5-5
- venturebeat.com technology / anthropic-launches-claude-sonnet-5-5-with-30-cost-reduction-per-task-due-to-faster-speeds-and-fewer-tool-calls
- tbench.ai www.tbench.ai