Aktualisiert am 13. Oktober 2026 (ursprüngliche Launch-Recherche: 28. August). Qwen3.8-Flash ist Alibabas neues gehostetes multimodales Flash-Modell mit dem API-Namen qwen3.8-flash. Es verarbeitet Text, Bilder und Video, gibt Text aus und bietet in Alibaba Model Studio einen Kontext von 1.000.000 Tokens. Wichtig: Qwen3.8-Flash ist nicht dasselbe wie Qwen3.8-Flash-Next. Flash-Next ist die parallel veröffentlichte Open-Weight-Architekturvorschau in Richtung Qwen4. Wer Preise, Parameterzahlen, Lizenz und lokale Hardwareanforderungen vermischt, kommt deshalb schnell zu falschen Aussagen. 123456
Kurzantwort
- Hosted Qwen3.8-Flash: bis zu 991.808 Input-Tokens, 131.072 Output-Tokens und 1.000.000 Tokens Gesamtkontext. Thinking ist standardmäßig aktiv. 47
- Multimodal: Text, Bilder und Video als Eingabe; Text als Ausgabe. Function Calling, Structured Output, Prefix Continuation und Context Caching werden unterstützt. 48
- Aktueller Originalpreis in Frankfurt/Beijing: 0,8 CNY pro 1 Mio. Input-Tokens und 2,7 CNY pro 1 Mio. Output-Tokens. In Singapore sind es 1,094 bzw. 3,427 CNY. 46
- Öffentliche USD-API-Referenz: QwenCloud/OpenRouter listen rund 0,16 US-Dollar pro 1 Mio. Input-Tokens und 0,47 US-Dollar pro 1 Mio. Output-Tokens. 910
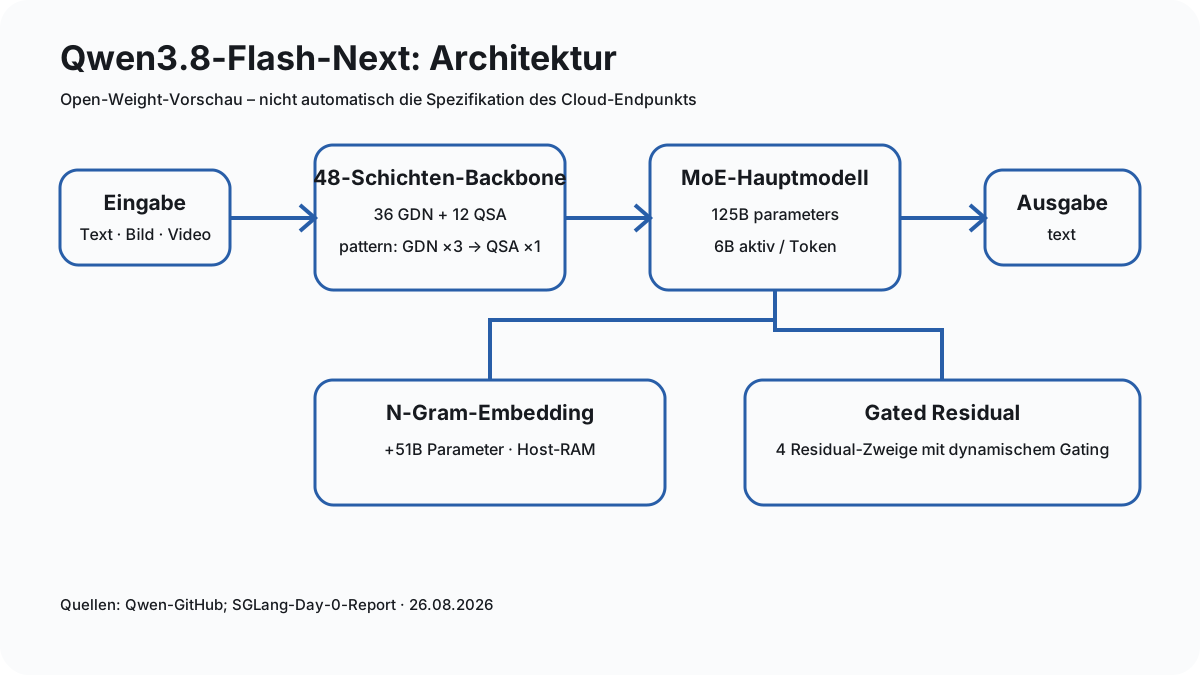
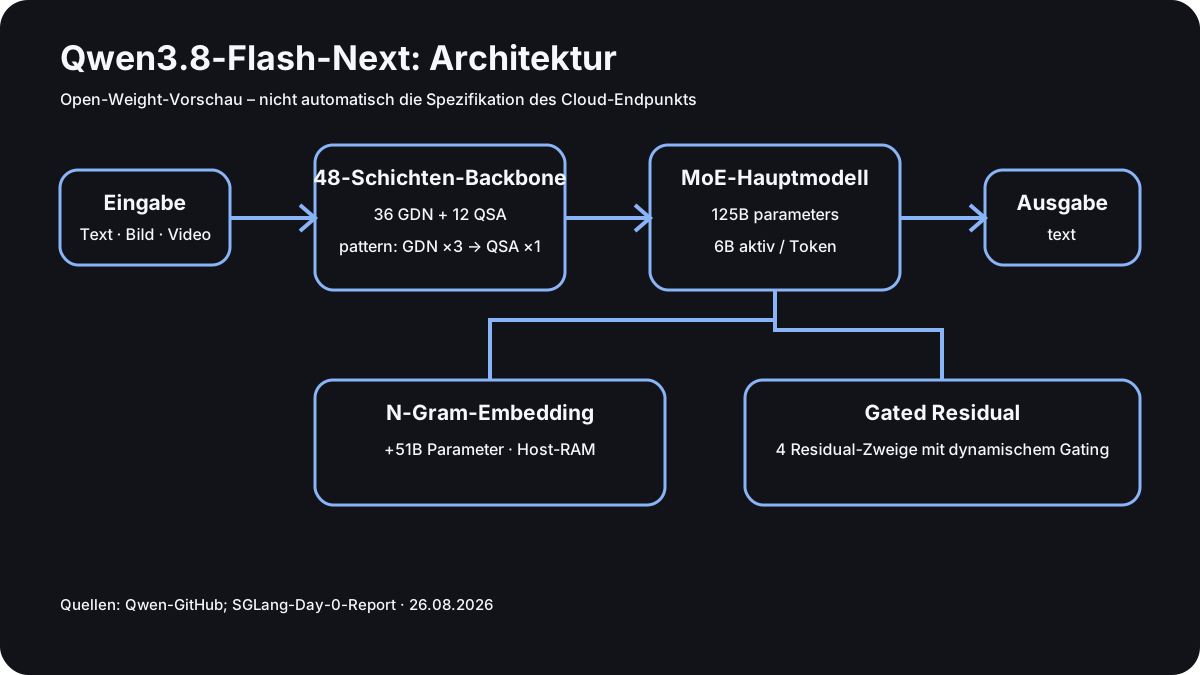
- Flash-Next: 125B-Parameter-Hauptmodell plus 51B N-Gram-Embedding, 6B aktive Parameter pro Token; Qwen Community License 1.0. Diese Architekturangaben gelten direkt für Flash-Next, nicht automatisch für den gehosteten Produktionsendpunkt. 211
- Lokaler Betrieb: prinzipiell über Transformers, llama.cpp, MLX, SGLang, vLLM und Drittanbieter-Quantisierungen möglich, aber das Modell ist groß. Unsloth nennt für eine extreme 1-Bit-Quantisierung etwa 75 GB RAM/Unified Memory. 21213
Qwen3.8-Flash und Qwen3.8-Flash-Next: der wichtigste Unterschied
Alibaba veröffentlichte am 26. August 2026 zwei eng verwandte Namen. qwen3.8-flash bezeichnet den produktiven Cloud-Endpunkt. Qwen3.8-Flash-Next bezeichnet die offenen Gewichte einer experimentellen Architekturvorschau. Qwen beschreibt Flash-Next ausdrücklich als frühen Blick auf die Architektur, die für Qwen4 vorgesehen ist. 125
Diese Trennung hat praktische Folgen:
| Punkt | Qwen3.8-Flash | Qwen3.8-Flash-Next |
|---|---|---|
| Hauptrolle | Gehostetes Produktionsmodell | Open-Weight-Architekturpreview |
| API-ID | qwen3.8-flash | je nach Host Qwen/Qwen3.8-Flash-Next |
| Kontext | 1.000.000 Tokens | 262.144 nativ; Erweiterung auf 1M via YaRN laut Qwen |
| Lokale Gewichte | nicht durch den Cloud-Namen beschrieben | ja |
| Architekturparameter | nicht separat als Cloud-Spezifikation veröffentlicht | 125B Hauptmodell + 51B N-Gram; 6B aktiv/Token |
| Lizenz | Cloud-Nutzungsbedingungen | Qwen Community License 1.0 |
| Typischer Einsatz | API, Agenten, Coding, lange Dokumente | Forschung, Self-Hosting, Quantisierung, Inference-Engineering |
Das ist mehr als Namenskosmetik: Die oft zitierte Zahl „125B“ gehört zur Flash-Next-Veröffentlichung. Sie sollte nicht ohne Zusatz als Parameterzahl des gehosteten qwen3.8-flash ausgegeben werden. 24
Kontextfenster und Ausgabelimit
Alibaba dokumentiert für das gehostete Modell 1.000.000 Tokens Kontext. Ohne Thinking sind maximal 991.808 Input-Tokens möglich; im Thinking-Modus 983.616. Die maximale Ausgabe liegt jeweils bei 131.072 Tokens, die maximale Thinking-Kette bei 262.144 Tokens. 4
Damit zielt das Modell auf Workloads jenseits reiner Kurz-Chats: große Repositories, lange Dokumente, agentische Verläufe oder multimodale Eingaben. Ein 1M-Fenster bedeutet allerdings nicht, dass jede Anwendung automatisch sinnvoll eine Million Tokens senden sollte. Latenz, Kosten, Retrieval-Qualität und die Fähigkeit, relevante Details über sehr lange Sequenzen zu nutzen, bleiben separate Fragen.


Aktuelle Preise: Launch-Angabe und heutige Dokumentation unterscheiden sich
Reuters berichtete zum Launch am 26. August von 1 CNY pro Million Input-Tokens und 3 CNY pro Million Output-Tokens. Zwei Tage später weist die aktuelle offizielle Alibaba-Dokumentation für Beijing und Frankfurt bereits 0,8 CNY Input / 2,7 CNY Output aus. Für Singapore gelten 1,094 / 3,427 CNY. 4614
Das ist ein gutes Beispiel dafür, warum Launch-Artikel bei API-Preisen schnell altern. Für Kauf- oder Kostenentscheidungen sollte die aktuelle regionale Preisseite maßgeblich sein. Für den Vergleich mit dem größeren Modell gibt es im Qwen3.8-Max-Faktencheck eine separate Preis- und Benchmark-Einordnung.
Gegen Qwen3.7-Flash ist 3.8 nicht immer billiger
Auf der Qwen3.7-Flash-Modellseite kostet die Standardabfrage in Frankfurt/Global und Beijing bei Prompts bis 32K Tokens 0,2 CNY Input und 0,8 CNY Output je 1 Mio. Tokens (Listenpreise, abgeglichen am 13. Oktober 2026). Damit ist Qwen3.8-Flash in diesem kurzen Bereich 4× so teuer beim Input und 3,375× beim Output. Erst im langen Tier von 256K bis 1M dreht sich die Rechnung: Qwen3.7-Flash kostet dort 1,2/4,8 CNY, Qwen3.8-Flash 0,8/2,7 CNY. Qwen3.8 ist dann rechnerisch 33,3 % günstiger beim Input und 43,75 % günstiger beim Output. 6
Redaktionelle Schlussfolgerung: Qwen3.8-Flash ist kein pauschaler Preisnachfolger für jeden kurzen Chat. Der wirtschaftliche Vorteil ist besonders interessant, wenn lange Kontexte, bessere Modellqualität oder Agentenfunktionen tatsächlich genutzt werden.


Drei Kostenbeispiele in US-Dollar
Mit der öffentlich gelisteten QwenCloud/OpenRouter-Referenz von 0,16 Dollar pro Million Input- und 0,47 Dollar pro Million Output-Tokens ergeben sich folgende reinen Tokenkosten. 910
| Nutzung | Input/Monat | Output/Monat | Eigene Rechnung |
|---|---|---|---|
| leicht | 10 Mio. | 2 Mio. | $2,54 |
| mittel | 100 Mio. | 20 Mio. | $25,40 |
| intensiv | 1 Mrd. | 200 Mio. | $254,00 |
Formel: (Input-Mio. × 0,16 $) + (Output-Mio. × 0,47 $). Nicht enthalten sind mögliche Provideraufschläge, Tools, Websuche, Speicherung oder wechselnde Rabatte.
Was ändert Flash-Next technisch?
Qwen3.8-Flash-Next kombiniert drei GDN-Schichten mit einer QSA-Schicht in einem wiederkehrenden Muster. SGLang beschreibt 48 Schichten insgesamt: 36 GDN- und 12 QSA-Schichten. QSA steht für Qwen Sparse Attention und soll bei langen Sequenzen nur besonders relevante Kontextbereiche für die teure Attention auswählen. 215
Dazu kommen zwei ungewöhnliche Bausteine:
Gated Residual (GR) verbreitert den Residualpfad auf vier Zweige und steuert dynamisch, welche Information gelesen und zurückgeschrieben wird. N-Gram Embedding ergänzt einen großen, hashbasierten Speicher für lokale Tokenmuster. Qwen nennt dafür 51B zusätzliche Embedding-Parameter; SGLang beschreibt, dass diese Tabelle in Host-RAM ausgelagert werden kann, sodass sie nicht dauerhaft GPU-Speicher belegt. 215
Das Hauptmodell hat 125B Parameter, während pro Token 6B Parameter aktiviert werden. Qwen vergleicht den Trainingsaufwand mit Qwen3.7-Plus und nennt etwa ein Neuntel der Trainingskosten. Das ist eine Herstellerangabe, keine unabhängig reproduzierte Kostenrechnung. 214
Benchmarks: stark, aber Hersteller- und Fremdmessungen trennen
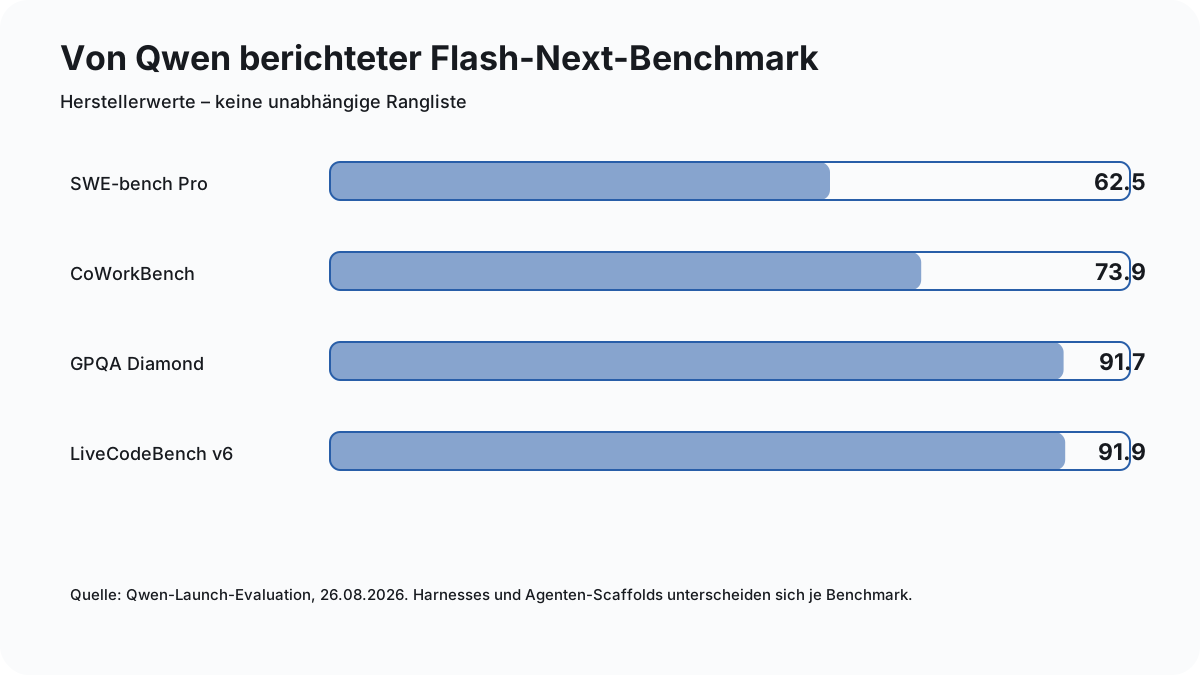
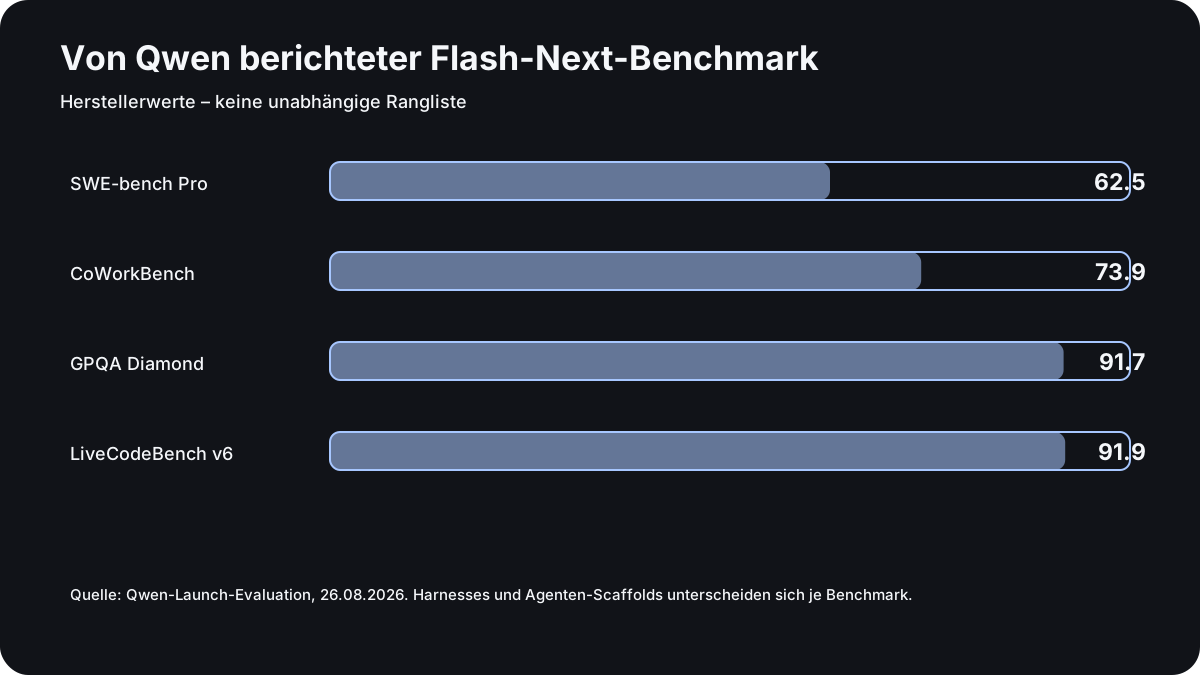
Qwen meldet für Flash-Next unter anderem 62,5 auf SWE-bench Pro, 81,0 auf SWE-bench Multilingual, 73,9 auf CoWorkBench, 91,7 auf GPQA Diamond und 91,9 auf LiveCodeBench v6. Diese Werte zeigen, wo Qwen das Modell positioniert: Coding, Agenten/Office-Aufgaben und allgemeines Reasoning. Sie sind jedoch Herstellerbenchmarks und hängen von Harness, Sampling, Tooling und Prompting ab. 1
Eine unabhängige Gegenperspektive liefert Artificial Analysis. Dort erreicht Flash-Next zum Prüfzeitpunkt einen Intelligence Index von 56; für einen getesteten Alibaba-Endpunkt werden etwa 73,4 Output-Tokens/s und 2,98 Sekunden Time-to-First-Token ausgewiesen. Diese Messungen beantworten andere Fragen als Qwens Einzelbenchmarks und sollten nicht zu einer gemeinsamen Rangliste vermischt werden. 16
API und Agentenfunktionen
Alibaba dokumentiert OpenAI-kompatible Chat-Completions und Responses sowie eine Anthropic-kompatible Messages API. In Model Studio unterstützt Qwen3.8-Flash Function Calling, Structured Output, Prefix Continuation und Context Caching. Thinking ist beim Modell standardmäßig aktiv. 4171871920
Für produktive Anwendungen ist die Region wichtig. In Frankfurt ist Context Caching verfügbar, die integrierte Websuche für dieses Modell laut Modellseite dagegen nicht. Batch Inference ist für Qwen3.8-Flash in Beijing unterstützt, nicht aber in Singapore und Frankfurt; die Batch-Dokumentation setzt parallel ein 256K-Kontextlimit pro Batch-Anfrage. 4212223
Auch Rate Limits unterscheiden sich: Alibaba nennt für Beijing 30.000 RPM und 5 Mio. TPM, für Singapore 15.000 RPM und 2 Mio. TPM; Frankfurt wird mit 30.000 RPM und 5 Mio. TPM geführt. 24
Frankfurt ist nicht automatisch EU Scope: Anbieterregion und Cache-Kosten prüfen
Die offizielle Alibaba-Liste der cachefähigen Modelle nach Region und Scope führt qwen3.8-flash für Frankfurt im „Global scope“. Im unmittelbar darunter aufgeführten „EU scope“ für Frankfurt ist Qwen3.8-Flash derzeit nicht gelistet (erneut abgeglichen am 13. Oktober 2026). Die separate Modellseite kennzeichnet Frankfurt ausdrücklich mit „Deployment scope: Global“. Ein Serverstandort Frankfurt beziehungsweise eine dort aufrufbare Modell-ID ist deshalb kein belastbarer Nachweis für die EU-Scope-Zusicherung. Für personenbezogene Daten die Modellverfügbarkeit im konkret vertraglich gewählten EU-Scope sowie Datenaufbewahrung, Transfers und AVV prüfen. Wenn das Modell im EU-Scope nicht angeboten wird, nicht still auf Global ausweichen. Eine IP-Adresse oder in Euro ausgestellte Rechnung beweist ebenfalls keinen EU-Scope.
Cache-Ersparnis ist nicht dasselbe wie ein hohes Wochenkontingent
Alibaba unterscheidet zwei Cache-Verfahren:
| Eigenschaft | Automatischer (impliziter) Cache | Expliziter Cache |
|---|---|---|
| Aktivierung | Automatisch, kann laut Dokumentation nicht deaktiviert werden | cache_control: {"type":"ephemeral"} für geeignete Inhaltsblöcke |
| Treffer | Nicht garantiert; gleicher Anfang des Prompts kann wiederverwendet werden | Wiederverwendung eines explizit markierten Präfixes nach Cache-Erstellung |
| Mindestgröße | 1.024 Tokens für potenzielle Treffer | 1.024 Tokens pro Cache-Block |
| Qwen3.8-Flash, Frankfurt/Global | Cache-Hit 0,1 CNY / 1 Mio. Tokens (12,5 % des regulären Inputs) | Erstellung 1,25 CNY / 1 Mio. Tokens (156,25 %); Hit 0,1 CNY (12,5 %) |
| Lebensdauer | Nicht garantiert, automatische Bereinigung | 5 Minuten, nach Treffer erneut fünf Minuten |
Abweichung vom Standardmodell: Alibabas allgemeine Context-Cache-Regeln listen explizite Cache-Erstellung standardmäßig mit 125 % und Treffer mit 10 % (sowie implizite Treffer mit 20 % des normalen Input-Preises). Warum der bisherige 20-%-Wert für dieses Modell nicht gilt: Alibaba nimmt qwen3.8-flash ausdrücklich von dieser Standardregel aus. Die Modellseite für Frankfurt (Global scope) weist 0,8 CNY für gewöhnliche Input-Tokens, 0,1 CNY für implizite und explizite Cache-Treffer sowie 1,25 CNY für explizite Cache-Erstellung aus – jeweils pro 1 Mio. Tokens. Das entspricht 12,5 % beziehungsweise 156,25 % des normalen Input-Preises. Preise für Singapore oder andere Scopes weichen ab; ebenso muss expliziter Cache für die gewählte Modell-/Scope-Kombination freigegeben sein. Die getrennte Responses-Session-Caching-Funktion ist nicht mit diesem Chat-Completions-Cache gleichzusetzen. Bei einer Abrechnung gilt die konkrete Modell-/Scope-Preisseite.
Rechenbeispiel, keine gemessene Rechnung: Wenn 10 Mio. Input-Tokens vollständig als Cache-Treffer in Frankfurt/Global abgerechnet werden, fallen für diese Treffer 1,00 CNY an. Ohne Cache-Treffer wären dieselben 10 Mio. Input-Tokens mit 8,00 CNY zu veranschlagen. Nicht enthalten: explizite Cache-Erstellung, normale Input-Tokens, Output-Tokens und gegebenenfalls weitere Gebühren. Ob ein Präfix tatsächlich aus dem Cache bedient wird, ist im API-Usage-Feld beziehungsweise in der Anbieterabrechnung zu prüfen. Solche Einsparungen garantieren keine entsprechend höheren Wochenlimits eines Token-Abos: Tarif-Credits, Rate Limits, Tokenverbrauch und API-Abrechnung sind getrennte Größen. Für Hermes einen synthetischen Workflow mit identischem Prompt-Präfix durchführen und tatsächlich abgerechnete Tokens, Cache-Hits und Wochenlimitentwicklung im Anbieter-Dashboard getrennt protokollieren. Wir haben hierzu keinen eigenen Live-API-Test durchgeführt.
Lässt sich Qwen3.8-Flash lokal auf einem Mac betreiben?
Der Cloud-Endpunkt selbst wird nicht „lokal“ ausgeführt. Dafür ist Flash-Next relevant. Qwens Repository nennt MLX/mlx-vlm ausdrücklich für Apple Silicon und llama.cpp für Text und Vision. 2 Wenn du zunächst mit einer kleineren lokalen Variante starten willst, ist der Qwen3.8-27B-Guide der realistischere Einstieg.
Das heißt aber nicht, dass ein gewöhnlicher 16- oder 32-GB-Mac das Modell komfortabel lädt. Unsloth gibt für eine aggressive 1-Bit-GGUF-Variante etwa 75 GB RAM oder Unified Memory an. Selbst diese Zahl ist eine Drittanbieterangabe für eine konkrete Quantisierung und kein allgemeines Mindestmaß. 1213 Für die grundlegende Speicherplanung empfiehlt sich der Unified-Memory-Guide.
Für typische Macs ist deshalb die Cloud-API realistischer. Lokales Flash-Next wird interessant auf Systemen mit sehr viel Unified Memory/RAM oder mehreren GPUs, wenn Datenschutz, Offline-Betrieb, Forschung oder Inference-Tuning den Aufwand rechtfertigen.
Lokale Laufzeiten: Launch-Fehler nicht verallgemeinern
Die Berichte vom 28. August 2026 betrafen konkrete Entwicklungsstände, darunter den N-Gram-Cache beim spekulativen Decoding und einen QSA/SSM-Pfad. Diese Bugs dürfen nicht ohne Prüfung als aktuell bestehende Probleme aller heutigen Runtime-Versionen ausgegeben werden. Vor einer Fehlermeldung den Issue-Status und die verwendete Version kontrollieren.25262728
Die offizielle Flash-Next-Modellkarte führt inzwischen 180 Milliarden Parameter, die experimentelle Architektur qwen4_exp und die Qwen Community License 1.0. Das bedeutet nicht, dass der gehostete Endpunkt qwen3.8-flash herunterladbare Gewichte bereitstellt. Das offizielle Repository umfasst ungefähr 360 GB Dateien; weder ist das die Größe einer Mac-Quantisierung noch eine Messung des laufenden Unified Memory oder der pro Token aktiven Parameter.
Für einen nachvollziehbaren lokalen Test protokollierst du Commit/Modellrevision, Quantisierung, Runtime-Version, 4K-/32K-Kontext, Bildinput und Toolparser. Vergleiche dasselbe Szenario mit dem kleineren Qwen3.8-27B auf demselben Mac. Ohne solche Messungen bleiben Qualitäts- und Performanceurteile ausdrücklich offen.
Lizenz: offen verfügbare Gewichte, aber nicht Apache
Qwen3.8-Flash-Next steht unter Qwen Community License 1.0. Die Lizenz erlaubt grundsätzlich unter anderem Nutzung, Kopieren, Modifizieren, Verteilen, Hosting und Fine-Tuning. Sie enthält jedoch Bedingungen: Ab sehr großer kommerzieller Reichweite ist eine prominente Modellnennung vorgesehen; für bestimmte Model-as-a-Service- und AI-Work-Assistant-Geschäfte verlangt der Text eine separate Lizenz. 11
Für ein kommerzielles Produkt ist deshalb der konkrete Lizenztext maßgeblich. „Open weights“ sollte hier nicht mit „Apache-2.0 ohne Sonderbedingungen“ gleichgesetzt werden.
Praxistest für die Entscheidung zwischen Cloud und Mac
Lege vor dem Vergleich drei konkrete Aufgaben fest: strukturierte Datenextraktion mit festem JSON-Schema, einen Bugfix mit Tests und eine längere Dokumentaufgabe mit vorab festgelegten Prüfkriterien. Dokumentiere jeweils den exakten Modellnamen, die API-Region, Kontextgröße, Eingabe- und Ausgabetokens, Gesamtkosten sowie bestandene Aufgaben. Der Cloud-Endpunkt qwen3.8-flash ist nicht das Open-Weight-Modell Qwen3.8-Flash-Next.
Für einen lokalen Versuch dokumentiere zusätzlich Mac-Chip, Unified Memory, Quantisierung, Runtime-Version und Speicherdruck. Flash-Next nutzt die Qwen Community License 1.0, nicht Apache 2.0; die konkreten Lizenzbedingungen sind vor kommerzieller Nutzung zu prüfen. Die Speicherrechnungen und veröffentlichten Community-Ergebnisse hier sind keine auf einem Mac von AI on Mac durchgeführten Leistungsmessungen.
Praxiseinsatz und Kaufentscheidung (Oktober 2026)
API-Entscheidung: Für Cloud-Nutzung zuerst QwenClouds aktuelle Modellseite zu Regionalpreis, Tools, API-Key-Berechtigungen und Limits prüfen. Die CNY-Preistier-Grafik zeigt am 13. Oktober erneut abgeglichene Listenpreise für den Frankfurt/Global- und Beijing-Scope, ist aber kein verbindliches Angebot, kein Cache-Kostenvergleich und keine Aussage über den EU-Scope. Für Offline-Einsatz müssen Qwen/Qwen3.8-Flash-Next-Gewichte und Lizenz getrennt geprüft werden.
Qwen3.8-Flash ist besonders interessant, wenn du lange Kontexte, multimodale Eingaben, Agenten/Tool-Calling und sehr niedrige API-Kosten kombinieren willst. Der Preis ist bei kurzen Eingaben nicht automatisch besser als Qwen3.7-Flash, wird aber bei sehr langen Kontexten deutlich attraktiver.
Flash-Next ist interessanter, wenn du die neue Qwen4-nahe Architektur untersuchen, selbst hosten oder quantisieren willst und ausreichend Speicher sowie Bereitschaft für einen noch schnell reifenden Inference-Stack mitbringst.
Der wichtigste Kauf- oder Implementierungscheck lautet deshalb nicht „Wie gut ist Qwen3.8-Flash?“, sondern: Willst du einen günstigen produktiven Cloud-Endpunkt oder die offene Flash-Next-Architektur selbst betreiben?
Methodik und Stand
Ursprüngliche Recherche: 28. August 2026; Modellkarte und Runtime-Einordnung erneut geprüft am 8. Oktober 2026. Geprüft wurden 37 Quellen, darunter Alibaba/Qwen-Primärdokumentation, offizielle Repositories und Lizenztexte, Implementierungsquellen, unabhängige Benchmarks, Nachrichtenquellen und frühe Bugreports. Preise und Verfügbarkeit sind zeitkritisch; insbesondere API-Preise sollten vor produktiver Nutzung erneut auf der regionalen Alibaba-Seite geprüft werden.
Quellen und Nachweise
Modell-, API- und Lizenzangaben werden mit dem jeweiligen Originaldokument verlinkt. Benchmarks aus Community- oder Anbieterquellen sind keine eigenen Apple-Silicon-Messungen.
Footnotes
Häufig gestellte Fragen
Was kostet Qwen3.8-Flash?
In Frankfurt und Beijing nennt Alibaba 0,8 CNY pro 1 Mio. Input-Tokens und 2,7 CNY pro 1 Mio. Output-Tokens. Singapore liegt bei 1,094 beziehungsweise 3,427 CNY; öffentliche USD-Referenzen liegen bei etwa 0,16/0,47 US-Dollar.
Was ist der Unterschied zwischen Qwen3.8-Flash und Flash-Next?
Qwen3.8-Flash ist der gehostete Produktions-Endpunkt. Qwen3.8-Flash-Next sind offene Gewichte einer Architekturvorschau; die Angaben 125B Hauptmodell, 51B N-Gram und 6B aktiv pro Token gehören zu Flash-Next.
Wie groß ist das Kontextfenster von Qwen3.8-Flash?
Das gehostete Modell hat 1.000.000 Tokens Gesamtkontext, bis zu 991.808 Input-Tokens ohne Thinking und 131.072 Output-Tokens. Im Thinking-Modus sinkt das maximale Input-Limit auf 983.616 Tokens.
Ist Qwen3.8-Flash günstiger als Qwen3.7-Flash?
Nicht bei kurzen Prompts: Bis 32K ist Qwen3.8-Flash beim Input rechnerisch viermal teurer. Im Tier 256K–1M ist Qwen3.8-Flash dagegen rund 33,3 Prozent günstiger beim Input und 43,75 Prozent beim Output.
Kann Qwen3.8-Flash lokal auf einem Mac laufen?
Der gehostete Endpunkt läuft nicht lokal. Für lokale Tests ist Flash-Next relevant; eine konkrete 1-Bit-Quantisierung wird mit etwa 75 GB RAM oder Unified Memory angegeben. 16- oder 32-GB-Macs sind dafür kein realistisches Ziel.
Ist Qwen3.8-Flash-Next Open Source?
Die Gewichte sind offen verfügbar und stehen unter der Qwen Community License 1.0, nicht unter Apache-2.0. Für kommerzielle Model-as-a-Service- oder AI-Work-Assistant-Angebote verlangt der Lizenztext eine gesonderte Prüfung beziehungsweise Lizenz.