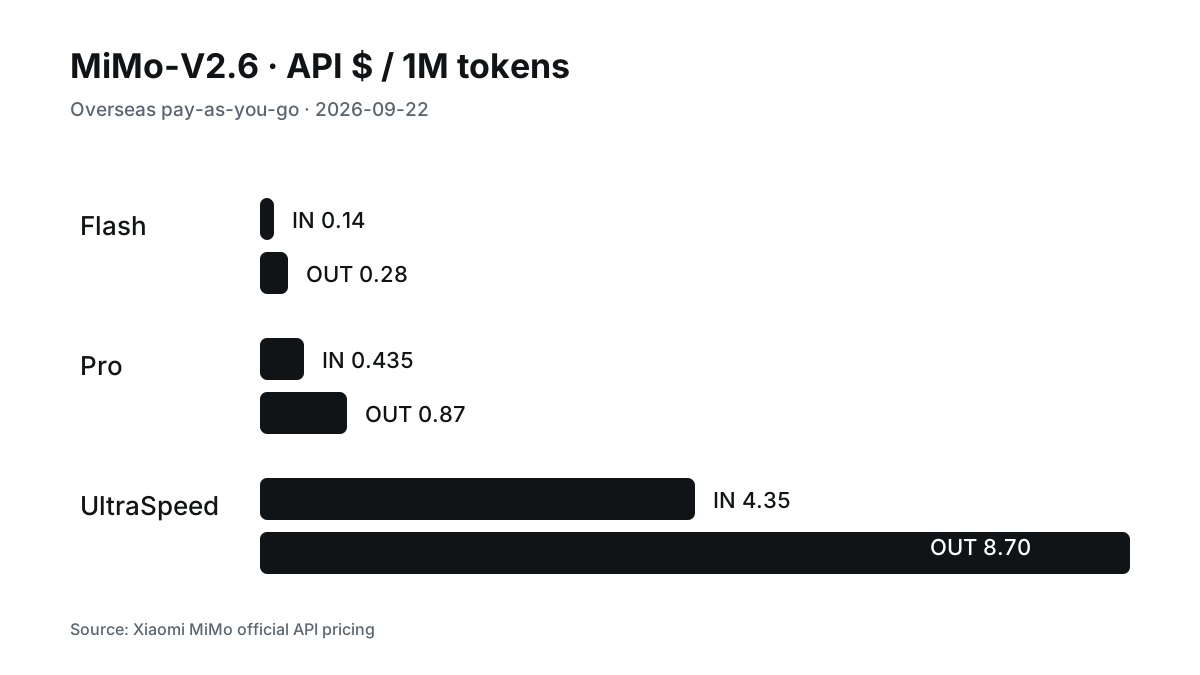
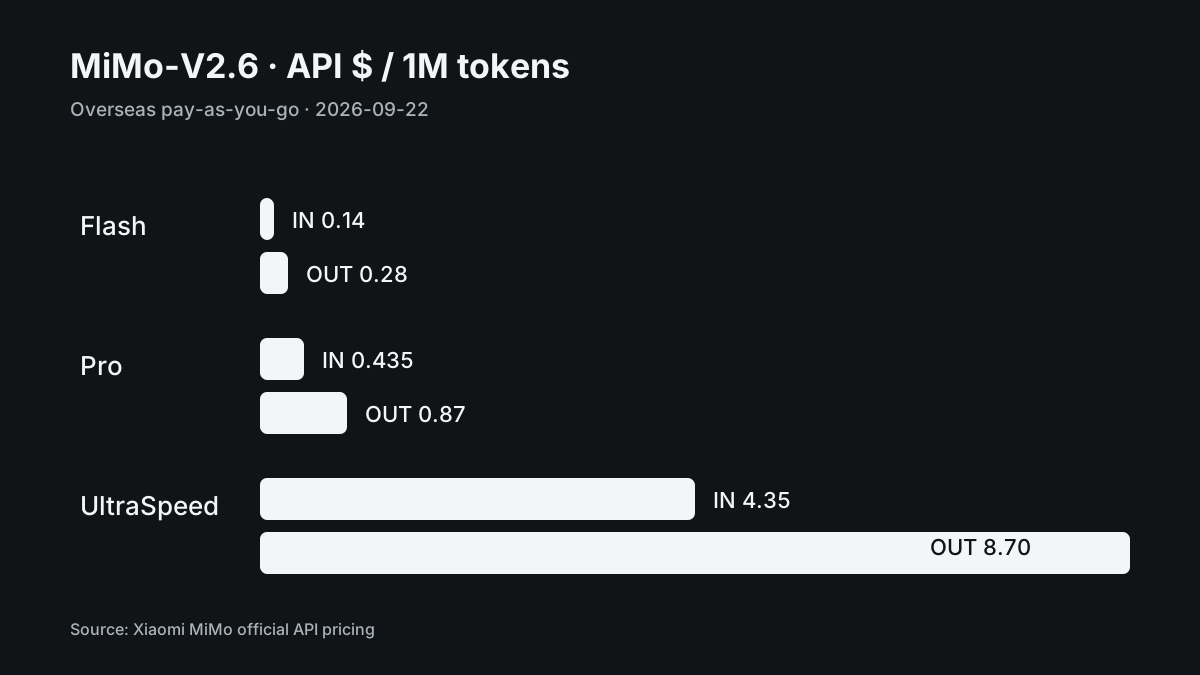
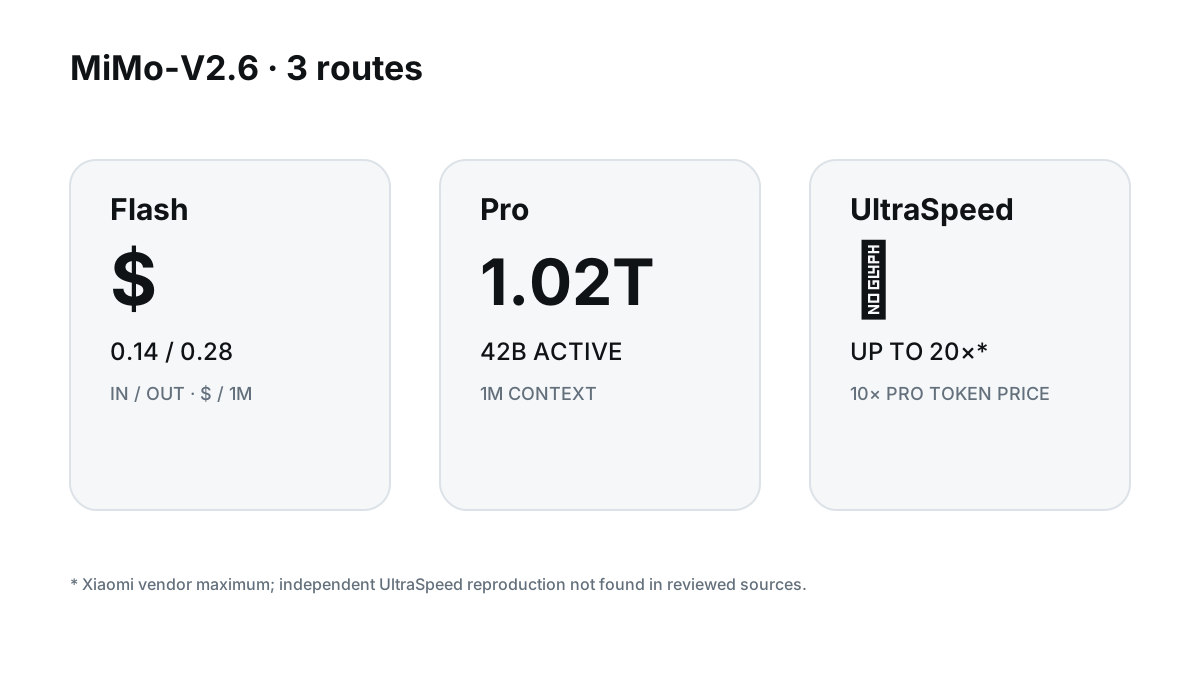
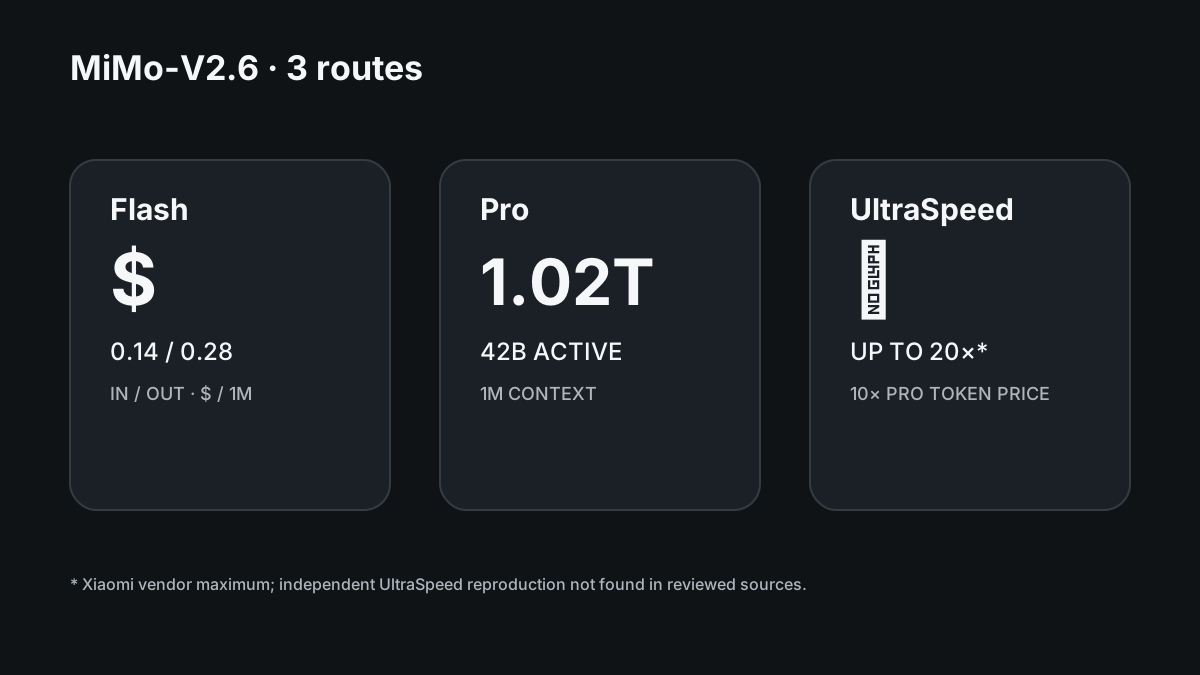
Stand: 22. September 2026. Xiaomi hat die MiMo-V2.6-Familie veröffentlicht und die Gewichte von MiMo-V2.6-Pro und MiMo-V2.6-Flash geöffnet. Parallel gibt es MiMo-V2.6-Pro-UltraSpeed als gehosteten Hochgeschwindigkeitsmodus. MiMo-V2.6-Flash kostet 0,14 US-Dollar pro Million Input-Token und 0,28 US-Dollar pro Million Output-Token, MiMo-V2.6-Pro 0,435 US-Dollar beziehungsweise 0,87 US-Dollar, und UltraSpeed 4,35 US-Dollar beziehungsweise 8,70 US-Dollar — bei identischem 1M-Kontext und identischem 131.072-Token-Output-Limit. Alle drei API-Modellnamen werden kleingeschrieben: mimo-v2.6-flash, mimo-v2.6-pro und mimo-v2.6-pro-ultraspeed.
Wichtig zur Evidenz: Die große Vergleichstabelle weiter unten stammt aus Xiaomis eigener Model Card. Das ist nützlich, aber nicht dasselbe wie unabhängige Replikation. Für MiMo-V2.6-Pro liegt bereits eine unabhängige Messung von Artificial Analysis vor; für viele Einzelbenchmarks und für Flash/UltraSpeed noch nicht.
Die drei Varianten im direkten Vergleich
| Merkmal | MiMo-V2.6-Flash | MiMo-V2.6-Pro | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Rolle | Effizienzvariante | Flaggschiff | schnelle Pro-Inferenz |
| Architektur | Sparse MoE | Sparse MoE | Pro-Familie |
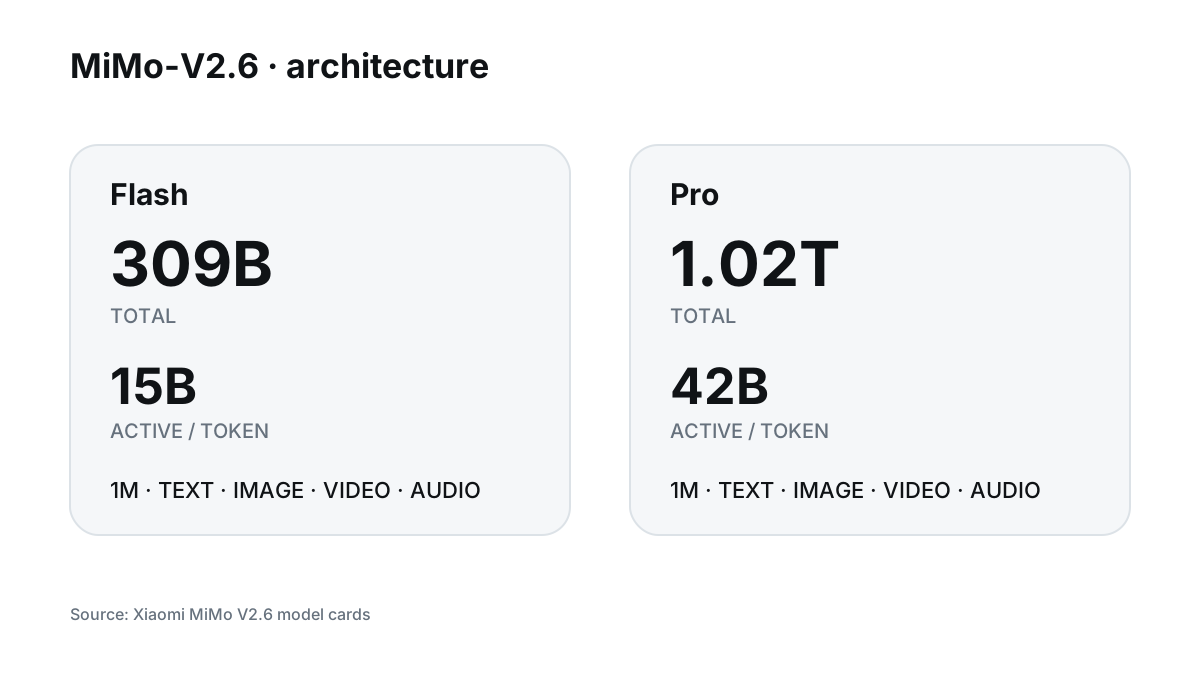
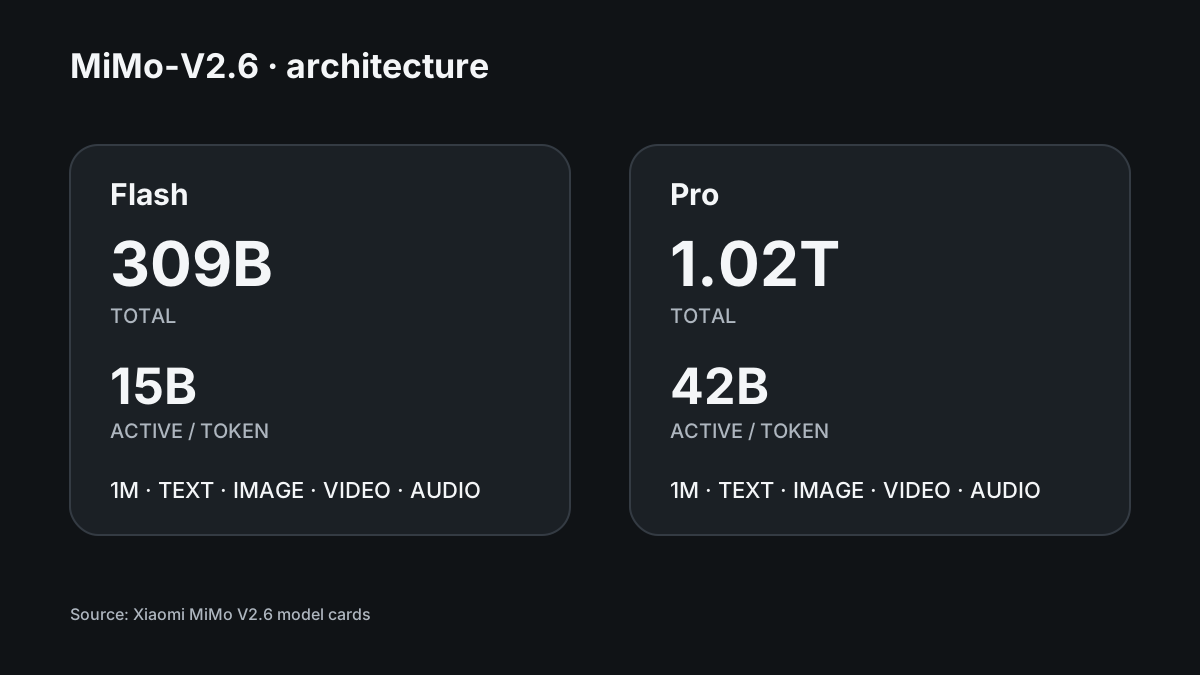
| Gesamtparameter | 309B | 1,02T | wie Pro |
| Aktiv pro Token | 15B | 42B | wie Pro |
| Kontext | 1.048.576 Token | 1.048.576 Token | 1.048.576 Token |
| Max. Output via Responses API | 131.072 Token | 131.072 Token | 131.072 Token |
| Input | Text, Bild, Video, Audio | Text, Bild, Video, Audio | Text, Bild, Video, Audio |
| API Input, Cache Miss | $0,14/M | $0,435/M | $4,35/M |
| API Input, Cache Hit | $0,0028/M | $0,0036/M | $0,036/M |
| API Output | $0,28/M | $0,87/M | $8,70/M |
| Batch API | $0,07/M in, $0,14/M out | $0,2175/M in, $0,435/M out | nicht angeboten |
| offene Gewichte | ja | ja | kein separater UltraSpeed-Checkpoint ausgewiesen |
Quellen: Xiaomi-Preisseite, Responses-API-Dokumentation und Model Cards. Der letzte Punkt ist eine redaktionelle Ableitung: Xiaomi nennt im Open-Source-Abschnitt Pro und Flash als Gewichte, UltraSpeed dagegen als Desktop/API-Modus.
Wie viel stärker ist Pro gegenüber Flash?
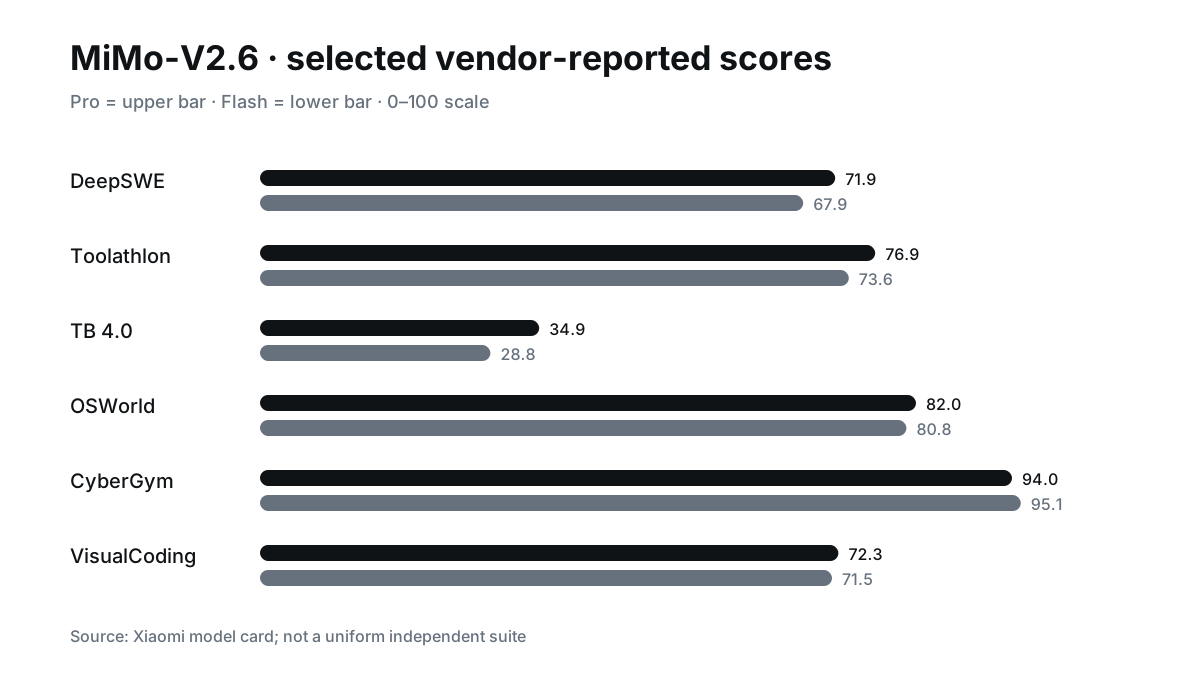
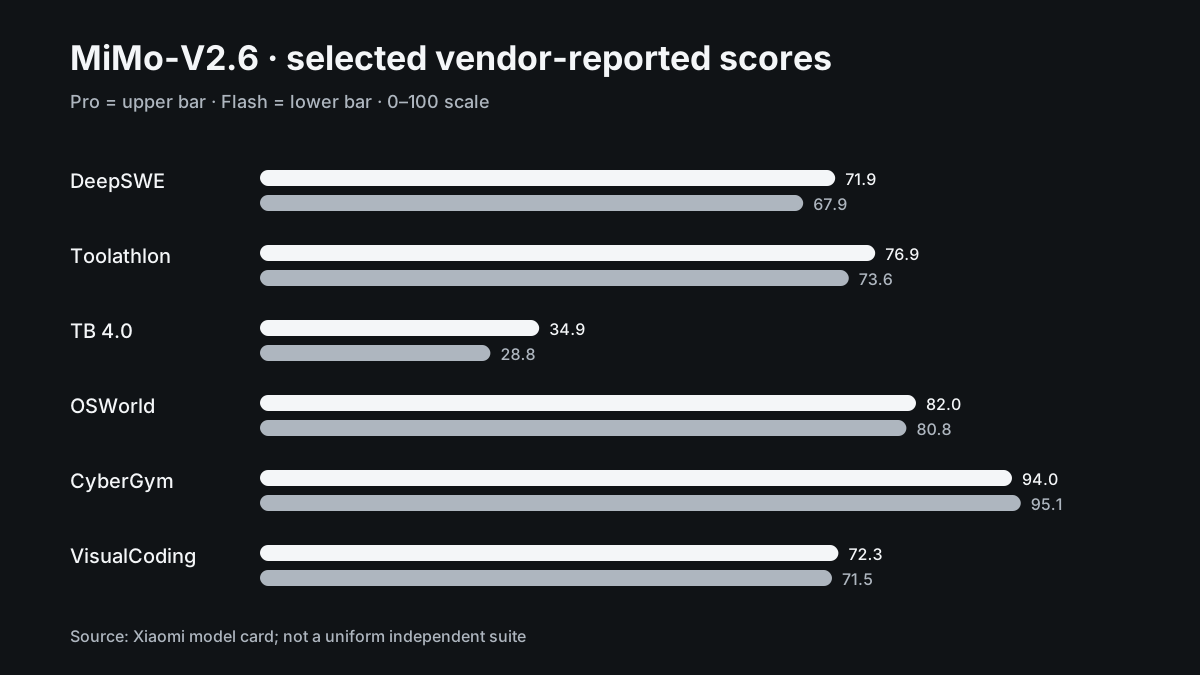
Xiaomis eigene Evaluationsdaten zeigen kein einheitliches Bild von „Pro schlägt Flash überall”. Pro liegt jedoch in der Mehrzahl der veröffentlichten Tests vorn:
| Benchmark | Pro | Flash | Differenz Pro − Flash |
|---|---|---|---|
| DeepSWE v1.1 | 71,9 | 67,9 | +4,0 |
| ProgramBench | 26,5 | 26,0 | +0,5 |
| MiMo Code Bench | 63,2 | 61,2 | +2,0 |
| AutomationBench v1.0.6 | 53,1 | 52,3 | +0,8 |
| Toolathlon-Verified | 76,9 | 73,6 | +3,3 |
| Agents’ Last Exam | 31,6 | 27,6 | +4,0 |
| Terminal Bench 4.0 | 34,9 | 28,8 | +6,1 |
| OSWorld-Verified | 82,0 | 80,8 | +1,2 |
| JobBench | 62,0 | 61,2 | +0,8 |
| CyberGym | 94,0 | 95,1 | −1,1 |
| MiMo Cyber Bench | 80,2 | 77,2 | +3,0 |
| SEC Bench Pro | 66,3 | 47,5 | +18,8 |
| MiMo VisualCoding | 72,3 | 71,5 | +0,8 |
Praktisch ist der Abstand bei einigen allgemeinen Agenten- und visuellen Tests klein. Bei bestimmten Security-Aufgaben ist er deutlich größer. Gleichzeitig gewinnt Flash im veröffentlichten CyberGym-Wert knapp. Wer aus einer einzigen Zahl eine allgemeine Qualitätsrangliste ableitet, überinterpretiert die Daten.
Auch die Benchmarks selbst benötigen Kontext. DeepSWE v1.1 umfasst 113 langlaufende Software-Engineering-Aufgaben; Epoch AI fand bei einer Prüfung Probleme in mindestens 23 Aufgaben und stuft die Benchmarkversion deshalb als fehlerbehaftet ein. Terminal-Bench und CyberGym weisen ebenfalls darauf hin, dass Harness, Konfiguration und Stochastik die Resultate beeinflussen.
Unabhängige Messung: Artificial Analysis
Artificial Analysis misst MiMo-V2.6-Pro aktuell mit 46 Punkten im Intelligence Index und etwa 134 Output-Token/s über Xiaomis API. Der gemessene Preis entspricht der offiziellen Pro-Rate von $0,435/M Input und $0,87/M Output.
Das ist derzeit der stärkste unabhängige Querschnitt in der Quellenbasis dieses Artikels. Für Flash und insbesondere UltraSpeed liegen zum Recherchezeitpunkt noch nicht dieselben unabhängigen Messreihen vor. Xiaomis „bis zu 20ד-Aussage für UltraSpeed ist daher als Hersteller-Maximalangabe zu behandeln, nicht als garantierte End-to-End-Beschleunigung.
Was kostet die Nutzung wirklich?
Die offiziellen Übersee-Preise sind ungewöhnlich weit auseinander. Pro kostet beim normalen Input rund 3,11× so viel wie Flash; UltraSpeed kostet exakt 10× so viel wie Pro. Beim Output gilt dasselbe Verhältnis von 10× zwischen Pro und UltraSpeed.
Beispielrechnungen
Annahme: Cache-Hit-Token ersetzen dieselbe Menge normalen Input. Websuche, Speicher und sonstige Zusatzkosten sind nicht eingerechnet.
| Szenario | Input | Output | davon Cache-Hit | Flash | Pro | UltraSpeed |
|---|---|---|---|---|---|---|
| Leicht | 5M | 1M | 0 | $0,98 | $3,05 | $30,45 |
| Mittlerer Agent | 50M | 10M | 35M | $4,998 | $19,351 | $193,51 |
| Heavy Agent | 500M | 100M | 400M | $46,12 | $180,44 | $1.804,40 |
Formel: (uncached input × input rate) + (cached input × cache-hit rate) + (output × output rate).
Der Cache ist für Pro besonders relevant: Der offizielle Cache-Hit-Preis von $0,0036/M liegt nur bei rund 0,83 % des normalen Pro-Inputpreises. Bei langen Agenten-Sessions mit stark wiederverwendetem Prefix kann der effektive Preis deshalb dramatisch unter einer Rechnung liegen, die jeden Input-Token als Cache Miss behandelt.
UltraSpeed: Wann die 10× höheren Tokenpreise sinnvoll sein können
UltraSpeed ist kein „Pro Plus” mit einer eigenen, besser bewerteten Model Card. Xiaomi beschreibt es als Hochgeschwindigkeitsmodus für Pro und bewirbt bis zu 20× Inferenzgeschwindigkeit. OpenRouter beschreibt die Variante ebenfalls als aus demselben Pro-Checkpoint abgeleitet.
Der Mehrpreis ist deshalb primär ein Latenz-/Durchsatzpreis, nicht ein Preis für ein anderes Qualitätsniveau. Sinnvoll ist das bei interaktiven Agenten, Echtzeit-Code-Assistenten oder Workflows, in denen Wartezeit teurer ist als Tokenverbrauch. Für asynchrone Recherche, Batch-Verarbeitung oder große Hintergrundjobs ist der normale Pro- oder Flash-Tarif wirtschaftlich naheliegender.
Flash: der Preis-Leistungshebel der Familie
Flash ist mit 309B Gesamt- und 15B aktiven Parametern erheblich kleiner als Pro, behält aber 1M Kontext und dieselben vier Inputmodalitäten. In vielen Herstellerbenchmarks liegt es nur wenige Punkte hinter Pro. Gleichzeitig kostet es beim normalen API-Input weniger als ein Drittel und beim Output ebenfalls rund ein Drittel von Pro.
Für hohe Volumina ist das der wichtigste Unterschied. Wer hunderte Millionen Token pro Monat durch Agenten schiebt, sollte Flash nicht als „kleine Version” abtun, sondern separat auf den eigenen Aufgaben testen.
Pro: wenn die letzten Punkte wichtiger sind als der niedrigste Preis
Pro skaliert auf 1,02T Gesamtparameter bei 42B aktiven Parametern pro Token. Die veröffentlichten Resultate zeigen den größten Vorsprung gegenüber Flash bei einigen Security- und Long-Horizon-Aufgaben, während andere Tests beinahe gleichauf sind.
Das macht Pro vor allem dann interessant, wenn Fehlversuche in langen Agentenläufen teuer sind. Ein Modell, das pro Token mehr kostet, kann im Gesamtsystem günstiger sein, wenn es weniger Wiederholungen, weniger Recovery-Schritte oder weniger menschliche Nacharbeit braucht. Diese Behauptung lässt sich jedoch nicht aus der Xiaomi-Tabelle allein beweisen; dafür braucht es Workload-spezifische A/B-Tests.
API und Agenten: zwei wichtige Integrationsdetails
Xiaomis Responses API akzeptiert Text, Bild, Audio und Video. Für alle drei V2.6-Modell-IDs ist max_output_tokens standardmäßig 131.072 und auf maximal 131.072 begrenzt.
Beim Reasoning ist die OpenAI-Kompatibilität nicht vollständig identisch: reasoning.effort=none schaltet Denken aus; andere Effort-Stufen aktivieren Denken, werden derzeit aber nicht fein abgestuft. Bei mehrstufigen Tool-Calls empfiehlt Xiaomi außerdem, vorherige Reasoning-Inhalte wieder mitzugeben. In Thinking Mode werden temperature und top_p auf die empfohlenen Werte 1,0 bzw. 0,95 gesetzt.
Für Agent-Frameworks ist das relevant, weil ein scheinbar kompatibler OpenAI-Endpunkt nicht garantiert, dass jede History-Replay-Strategie funktioniert. Xiaomis OpenCode-Dokumentation nennt explizit einen 400-Fehlerfall, wenn bei Tool-Calls das benötigte reasoning_content fehlt.
Open Weights heißt nicht automatisch „läuft bequem lokal”
Xiaomi hat Pro und Flash unter MIT-Kennzeichnung auf Hugging Face veröffentlicht. Die eigenen Deployment-Beispiele zielen aber klar auf große GPU-Konfigurationen: Die SGLang-Beispiele nutzen für Pro u. a. Tensor Parallel 16 und zwei Nodes; Flash wird mit Tensor Parallel 8 gezeigt.
Für Mac-Nutzer ist deshalb die wichtige Aussage nicht „open = lokal einfach”, sondern: Die Gewichte sind offen, die Referenzbereitstellung ist aber Rechenzentrums-/Multi-GPU-orientiert. Quantisierungen und alternative Runtimes können das ändern, müssen für V2.6 jedoch separat gemessen werden. Dieser Artikel behauptet deshalb bewusst keine Mac-Tokens/s ohne reproduzierbaren Test.
Was hat Xiaomi beim Training anders gemacht?
Xiaomi hat sechs Tage des RL-Trainings öffentlich gestreamt. Nach Unternehmensangaben wurden Pro und Flash jeweils 30 RL-Schritte trainiert; die Kosten lagen bei ungefähr $2,62 Mio. für Pro und $0,85 Mio. für Flash. Die Runs erzeugten insgesamt ungefähr 750.000 Trajektorien.
Das Training mischte Coding-, General-Agent-, Visual- und Cybersecurity-Aufgaben in einem gemeinsamen RL-Prozess. Xiaomi beschreibt 1.568 Prompts × 16 Rollouts pro Schritt und Milliarden Token pro Update. Vor dem Release dokumentierten TechNode und NYU Shanghai RITS das Live-Dashboard; beide machten deutlich, dass die damaligen Zwischenwerte Herstellerdaten und keine unabhängigen Leaderboard-Einträge waren.
Fazit: MiMo-V2.6 als Zweimodellfamilie plus Geschwindigkeitsmodus
MiMo-V2.6 ist weniger eine Dreierfamilie als eine Zweimodellfamilie plus Geschwindigkeitsmodus. Flash priorisiert Kosten und Effizienz, Pro priorisiert maximale Modellkapazität, und UltraSpeed verkauft niedrigere Latenz bzw. höheren Durchsatz zu einem 10× höheren Tokenpreis als Pro.
Für eine reale Entscheidung sollte man deshalb nicht nur den Benchmarkwert vergleichen, sondern Kosten pro erledigter Aufgabe, Fehlerrate, Anzahl nötiger Agent-Schritte und End-to-End-Latenz messen. Genau dort kann sich zeigen, ob Flash trotz geringerer Modellgröße genügt, Pro Wiederholungen spart oder UltraSpeed die Wartezeit tatsächlich wirtschaftlich rechtfertigt.
Häufig gestellte Fragen
Was unterscheidet MiMo-V2.6-Pro, Flash und UltraSpeed?
Flash ist mit 309B Gesamt- und 15B aktiven Parametern das Effizienzmodell, Pro das Flaggschiff mit 1,02T Gesamt- und 42B aktiven Parametern, und UltraSpeed ist nach Xiaomis Darstellung eine gehostete Hochgeschwindigkeits-Inferenzvariante der Pro-Familie — kein eigener Checkpoint.
Haben Flash und Pro beide 1M Kontext?
Ja. Die offiziellen Model Cards nennen für beide 1.048.576 Token, und Xiaomis Responses API listet für alle drei V2.6-Modell-IDs ein maximales Output-Limit von 131.072 Token.
Welches Modell ist für hohe API-Volumina am günstigsten?
Flash mit 0,14 US-Dollar pro Million Input-Token und 0,28 US-Dollar pro Million Output-Token auf Xiaomis offizieller Pay-as-you-go-Rate. Pro kostet beim normalen Input etwa 3,11× so viel, UltraSpeed exakt 10× so viel wie Pro.
Sind Pro und Flash Open Source?
Die Gewichte sind auf Hugging Face veröffentlicht und die Model Cards tragen eine MIT-Lizenzkennzeichnung. Präziser ist die Formulierung 'Open Weights unter MIT-Lizenz'. Für Mac-Nutzung gibt es aktuell keine offiziellen Token-pro-Sekunde-Werte.
Ist UltraSpeed ein stärkeres Modell als Pro?
Nach den verfügbaren Quellen nein. Xiaomi und OpenRouter beschreiben UltraSpeed als schnelle Inferenzvariante der Pro-Familie, nicht als separat bewerteten Checkpoint. Der Mehrpreis ist primär ein Latenz-/Durchsatzpreis.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- mimo.mi.com latest / v2-6
- mimo.mi.com price / pay-as-you-go
- mimo.mi.com chat / responses
- mimo.mi.com chat / openai-api
- mimo.mi.com summary / first-api-call
- mimo.mi.com guidance / rate-limit
- mimo.mi.com faq / api-integration
- mimo.mi.com price / token-plan
- mimo.mi.com integration / codex-configuration
- mimo.mi.com integration / opencode
- mimo.mi.com integration / mimo-desktop
- huggingface.co XiaomiMiMo / MiMo-V2.6-Pro-RL
- huggingface.co XiaomiMiMo / MiMo-V2.6-Flash-RL
- huggingface.co XiaomiMiMo / mimo-v26
- github.com XiaomiMiMo / MiMo
- artificialanalysis.ai models / mimo-v2-6-pro
- artificialanalysis.ai mimo-v2-6-pro / providers
- openrouter.ai xiaomi / mimo-v2.6-pro
- openrouter.ai xiaomi / mimo-v2.6-flash
- openrouter.ai xiaomi / mimo-v2.6-pro-ultraspeed
- technode.com 18 / xiaomi-livestreams-mimo-v2-6-reinforcement-learning-runs
- rits.shanghai.nyu.edu ai / xiaomi-mimo-v2-6-live-rl-dashboard
- runtimewire.com article / xiaomi-open-sources-mimo-v2-6-rl-cost-3-47m
- deepswe.datacurve.ai deepswe.datacurve.ai
- epoch.ai deepswe / review
- programbench.com programbench.com
- tbench.ai www.tbench.ai
- cybergym.io cybergym
- github.com SEC-bench / SEC-bench-Pro
- github.com MaxIntelligenceAgency / ALE-Benchmark
- designarena.ai about
- reddit.com 1wmnw89 / xiaomimimomimov26flashrl_hugging_face
- opencode.ai xiaomi / mimo-v2-6-pro