Kurzantwort
Inkling ist kein Mac-Modell: 975B Gesamtparameter brauchen Rechenzentrums-Hardware, selbst die 1-Bit-GGUF-Variante mit 270 GB ist kein Pfad für normale Macs. Auf Apple Silicon ist Inkling nur über Tinker oder Remote-Inferenz sinnvoll nutzbar – als breites, anpassbares Basismodell, nicht als Spitzenreiter.
- Mac-Urteil
- Lokal nein: BF16 braucht ca. 2 TB VRAM, NVFP4 ca. 600 GB, selbst 270-GB-GGUF ist kein Consumer-Pfad
- Parameter
- 975B gesamt und 41B aktiv pro Token; Inkling-Small: 276B und 12B
- Kontext
- Gewichte bis 1M Token, bei Tinker nur 64K oder 256K
- Tinker-Preise (Stand 10.10.2026)
- Inkling: 1,87 / 0,374 / 4,68 USD pro 1 Mio. Token für Prefill, Cache und Sampling; vor Nutzung erneut prüfen
- Lizenz
- Apache 2.0 plus zusätzliche Acceptable Use Policy – nur eingeschränkt Open Source
Zuletzt geprüft: 2. November 2026
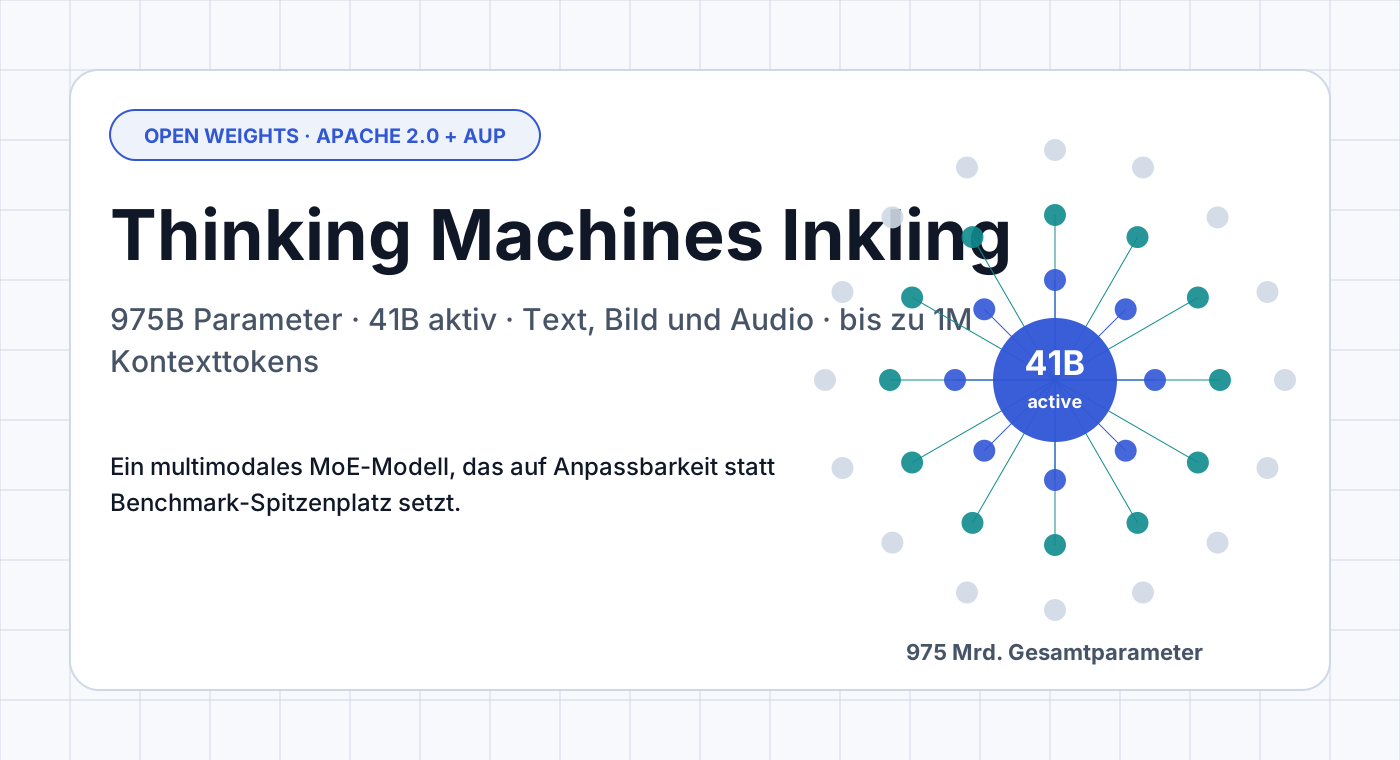
Thinking Machines Lab hat am 15. Juli 2026 sein erstes vollständig selbst trainiertes General-Purpose-Modell veröffentlicht. Inkling ist ein multimodales Mixture-of-Experts-Modell mit 975 Milliarden Gesamtparametern, von denen pro Token nur 41 Milliarden aktiv sind. Es verarbeitet Text, Bilder und Audio nativ, unterstützt laut Modellkarte bis zu eine Million Kontexttokens und steht als vollständiger Download der Modellgewichte zur Verfügung.
Thinking Machines sagt ausdrücklich, dass Inkling weder unter offenen noch unter geschlossenen Modellen insgesamt führend ist. Der Anbieter positioniert es als breit einsetzbares, anpassbares Basismodell, das Unternehmen und Forschungsteams auf eigene Daten, Werkzeuge und Arbeitsabläufe feinabstimmen können.
Inkling kombiniert eine große MoE-Architektur, native Multimodalität, kontrollierbaren Denkaufwand, ein langes Kontextfenster und eine direkte Anbindung an die Fine-Tuning-Plattform Tinker. Gleichzeitig ist das Modell so groß, dass lokales Self-Hosting für normale Macs und Workstations praktisch ausgeschlossen bleibt.
Mac-Einordnung: drei realistische Wege
Inkling ist ein Rechenzentrums-Modell, kein lokaler Mac-Download. Die Tinker-Preise in diesem Artikel sind zuletzt am 10. Oktober 2026 geprüft, vor einer Buchung also erneut prüfen. Zum selben Stand riet Thinking Machines von intensiver Produktivnutzung der Serverless-Beta ab.
Die drei realistischen Wege auf dem Mac:
- Tinker nutzen – für Sampling, Fine-Tuning (SFT, PEFT/LoRA, RL) und Distillation, mit 64K- oder 256K-Kontext statt der nominellen 1M Token der Gewichte.
- Remote-Inferenz – über die Serverless-Beta oder einen anderen gehosteten Anbieter, mit Modell-ID, Kontextgrenze und Tokenkosten vorab geprüft.
- Als Teacher-Modell – Inklings Dokumentverständnis zur Wissensdistillation in ein kompakteres On-Device-Modell nutzen, statt das Modell selbst lokal zu betreiben.
Update: Inkling-Small seit 30. Juli 2026
Thinking Machines hat am 30. Juli 2026 Inkling-Small veröffentlicht. Die kleinere Schwester hat 276 Milliarden Gesamtparameter und 12 Milliarden aktive Parameter und verarbeitet wie Inkling Text, Bilder und Audio bei einem nominellen Kontextfenster von bis zu 1 Million Token. Der Anbieter beschreibt sie als vergleichbar leistungsfähig bei geringerem Kosten- und Latenzprofil; sie ist aber kein dichtes 12B-Modell und benötigt für vollständige Self-Hosting-Inferenz weiterhin Rechenzentrums-Hardware.
| Merkmal | Inkling | Inkling-Small |
|---|---|---|
| Gesamt-/aktive Parameter | 975B / 41B | 276B / 12B |
| Kontext | 1M; Tinker 64K/256K | 1M; Tinker 64K/256K |
| Offizielle BF16-Anforderung | ca. 2 TB aggregierter VRAM | ca. 600 GB aggregierter VRAM |
| Offizielle NVFP4-Anforderung | ca. 600 GB aggregierter VRAM | ca. 180 GB aggregierter VRAM |
Für Inkling-Small nennt die offizielle Model Card als Referenz eine B300-GPU im W4A4-Modus oder zwei H200-GPUs im W4A16-Modus. Das ist eine deutlich niedrigere Schwelle als bei Inkling, aber noch keine bestätigte Apple-Silicon-Lösung: Ein nomineller Speicherfit in 180 GB Unified Memory würde weder Runtime-Overhead noch KV-Cache noch eine offiziell dokumentierte Mac-Inferenz bedeuten. Für normale Macs sind Tinker oder Remote-Inferenz die praktikablen Wege.
Inkling-Small bei Tinker, geprüft am 10.10.2026: Sowohl 64K als auch 256K kosten pro Million Token 0,58 USD Prefill, 0,116 USD Cached Prefill und 1,44 USD Sampling. Für Training nennt die Tinker-JSON-Preisliste 1,73 USD bei 64K und 3,47 USD bei 256K. Die veröffentlichten Preise enthalten einen zeitlich begrenzten 50-%-Rabatt ohne zugesichertes Enddatum; die später aufgeführte Serverless-Beta wird separat berechnet.
Inkling auf einen Blick
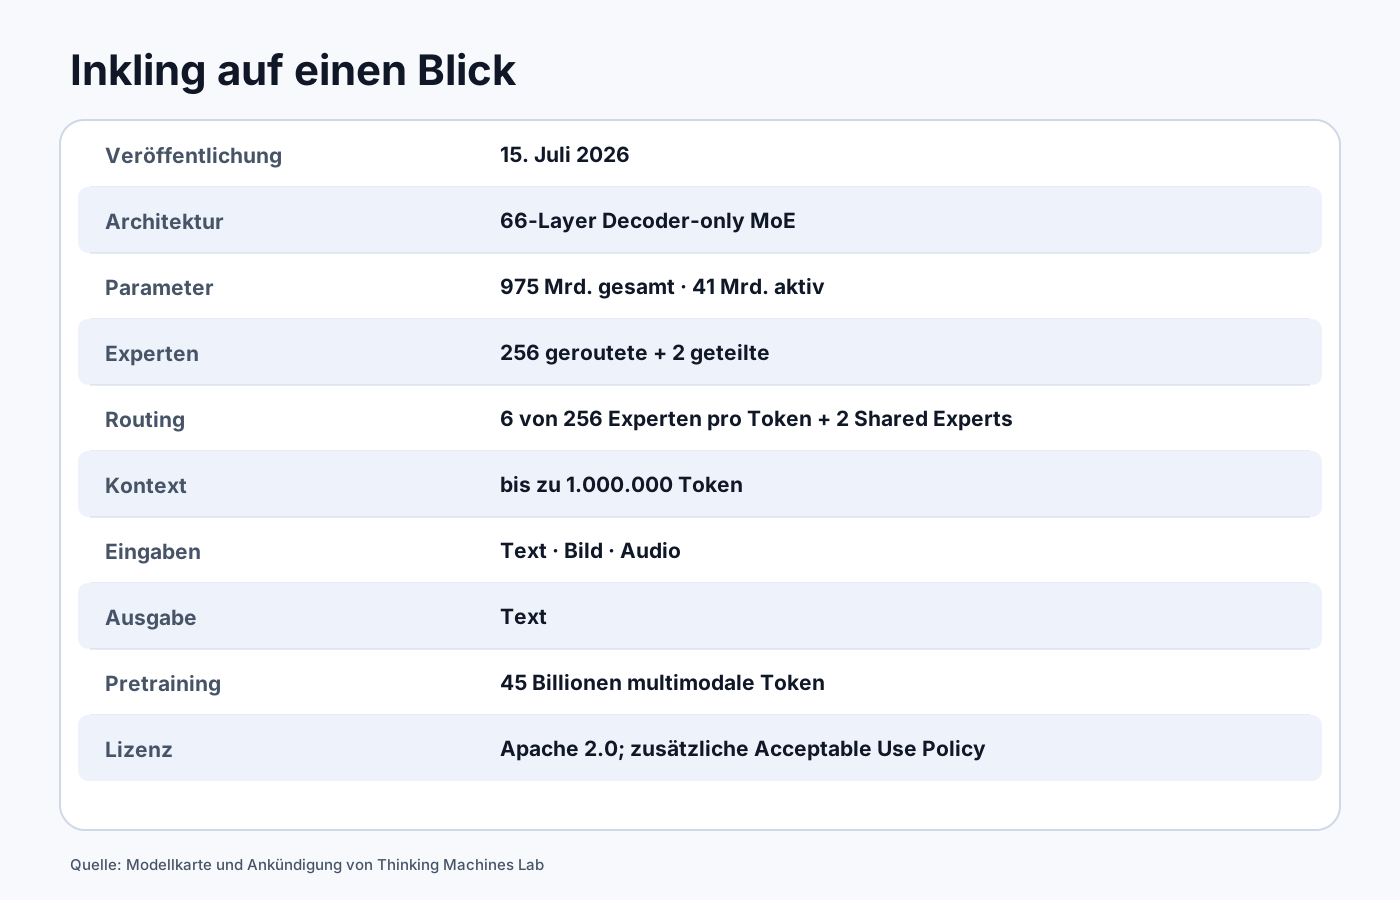
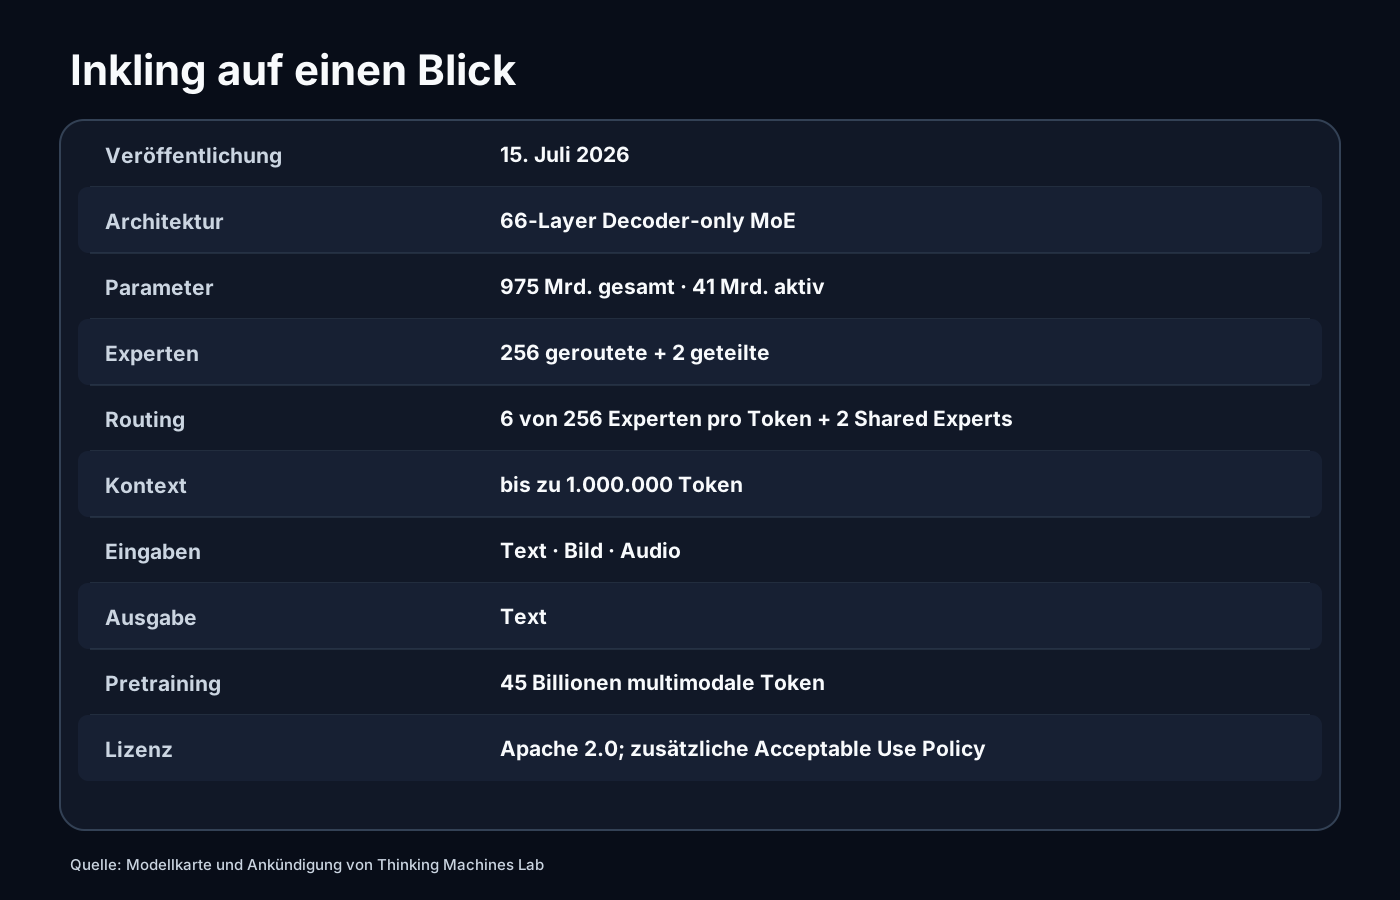
Inkling besitzt 66 Decoder-Layer und einen sparsamen MoE-Feed-Forward-Backbone. Jeder Token wird an sechs von 256 gerouteten Experten geschickt; zusätzlich sind zwei geteilte Experten immer aktiv. Dadurch bleibt die aktive Rechenmenge mit 41 Milliarden Parametern deutlich kleiner als die Gesamtzahl der Gewichte.
Der Unterschied zwischen Gesamtparametern und aktiven Parametern ist entscheidend. MoE reduziert die Rechenarbeit pro generiertem Token, aber nicht automatisch den Speicherbedarf. Für die Inferenz müssen weiterhin sehr viele oder alle Expertengewichte verfügbar sein. Genau deshalb benötigt der offizielle BF16-Checkpoint trotz nur 41 Milliarden aktiver Parameter rund zwei Terabyte aggregierten GPU-Speicher.
Architektur von Inkling


66-Layer Decoder-only Transformer
Inkling ist ein autoregressiver Decoder-only Transformer. Text, Bild- und Audioinformationen werden in einen gemeinsamen Hidden Space projiziert und anschließend von demselben Decoder verarbeitet. Thinking Machines beschreibt Inkling deshalb als nativ multimodal trainiert: Text-, Bild- und Audioinformationen laufen durch denselben Decoder.
Für Bilder verwendet das Modell einen hierarchischen Patch-Encoder. Kleine lokale Gruppen von Bildpatches werden in die Kanaldimension gefaltet und durch einen hierarchischen MLP-Pfad verarbeitet. Audio wird zunächst in eine Mel-Repräsentation überführt, in diskrete Bins quantisiert und anschließend eingebettet. Laut Hugging Face umfasst die Bildrepräsentation eine zeitliche Dimension für Video. Thinking Machines hat die Videoqualität des veröffentlichten Checkpoints jedoch nicht ab Werk evaluiert.
Hybrid-Attention im Verhältnis 5:1
Thinking Machines setzt ein Verhältnis von fünf Sliding-Window-Layern zu einem globalen Attention-Layer ein. Lokale Attention reduziert die Kosten bei langen Sequenzen, während regelmäßig eingestreute globale Layer Informationen über den vollständigen Kontext zusammenführen können. Der letzte Layer verwendet ebenfalls globale Attention.
Relative Positionen statt RoPE
Inkling nutzt relative Positionsrepräsentationen anstelle der bei modernen LLMs verbreiteten Rotary Positional Embeddings. Die Positionsinformation wird direkt in die Attention-Logits eingebracht. Thinking Machines berichtet von besserer Extrapolation auf lange Sequenzen in internen Experimenten. Das angegebene Kontextfenster beträgt bis zu eine Million Tokens.
Short Convolutions
Zusätzlich zur Attention verwendet Inkling kurze eindimensionale Faltungen. Sie werden nach den Key- und Value-Projektionen sowie auf den Attention- und MLP-Residualzweigen eingesetzt. Diese lokalen Operationen sollen kurzreichweitige Muster effizient erfassen und dadurch Attention und MoE-Module entlasten.
Multi-Token Prediction
Der Release enthält einen MTP-Drafter. Zusätzliche Layer schlagen mehrere Folgetokens vor, die anschließend vom Hauptmodell verifiziert werden. Dieses spekulative Decoding kann die Ausgabe beschleunigen, ohne die endgültige Tokenfolge zu verändern, benötigt aber zusätzlichen Speicher für den Drafter.
Training: 45 Billionen Token und über 30 Millionen RL-Rollouts
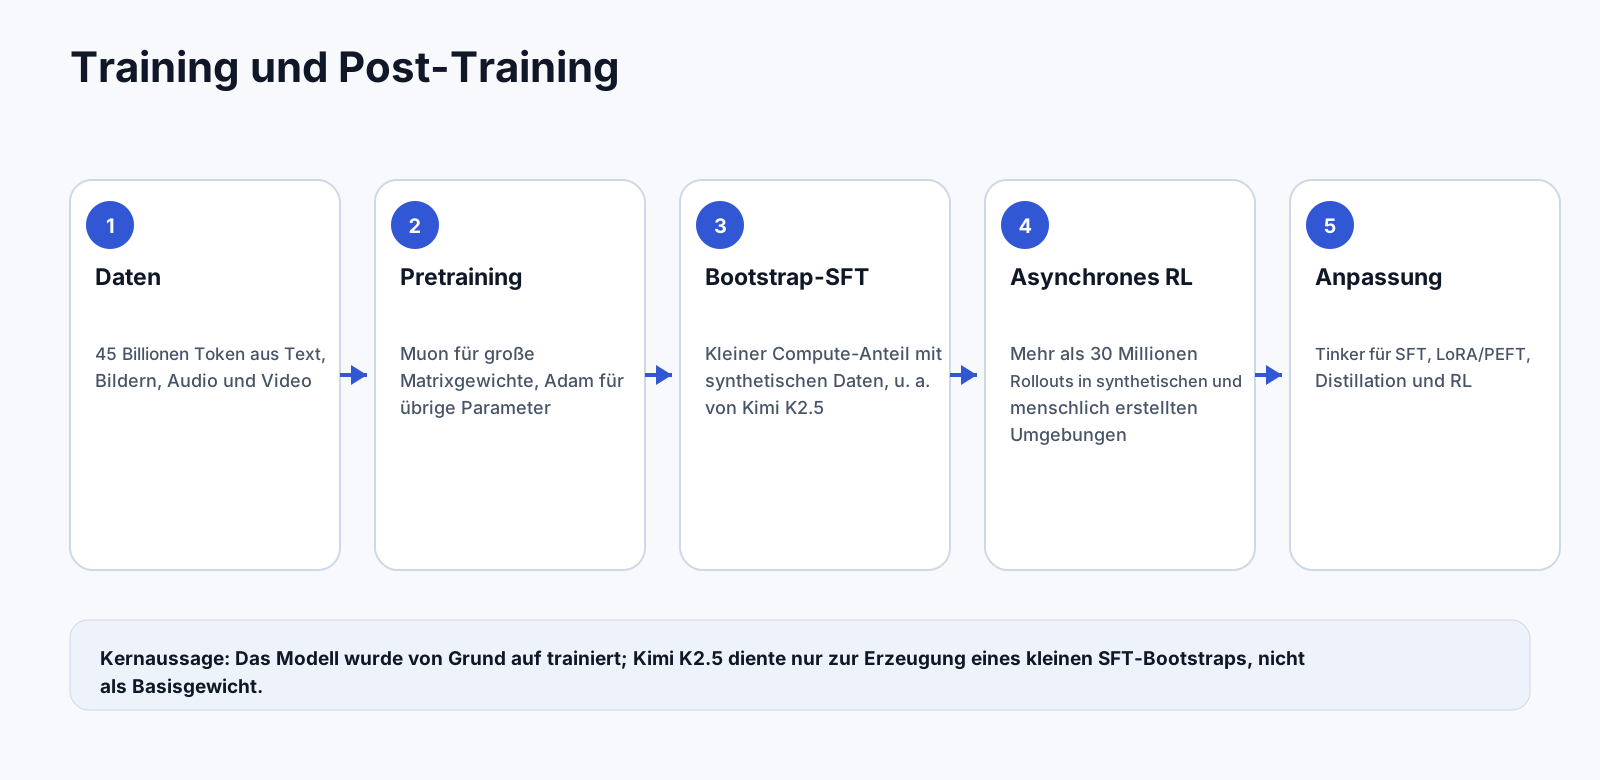
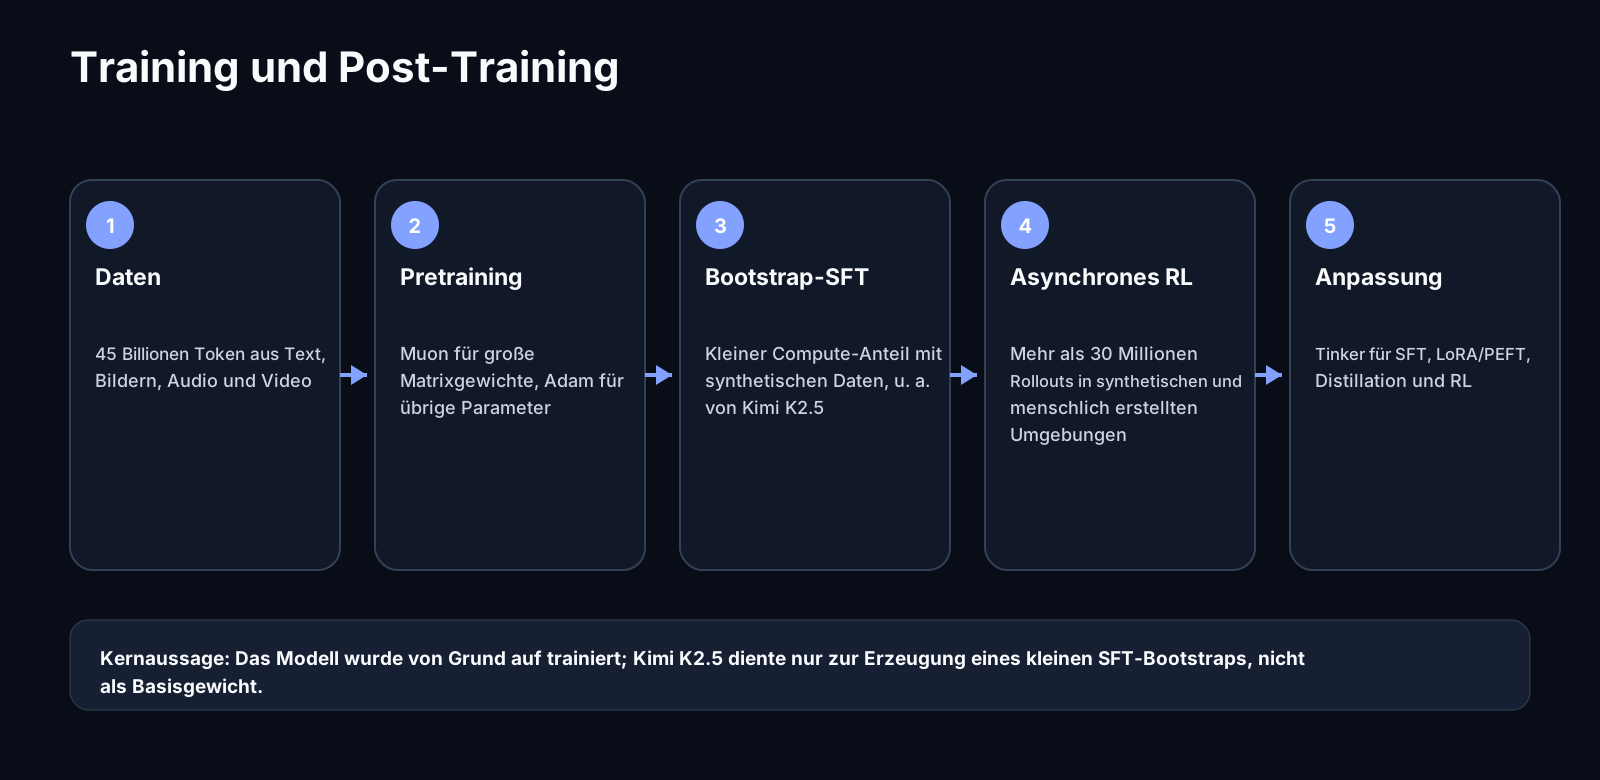
Inkling wurde laut Thinking Machines von Grund auf trainiert. Das Pretraining umfasste 45 Billionen Token aus Text, Bildern, Audio und Video. Die Daten stammen aus öffentlich verfügbaren Quellen, von Drittanbietern sowie aus synthetisch erzeugten oder erweiterten Datensätzen. Die veröffentlichte Trainingsdatendokumentation bleibt dabei auf einer hohen Ebene: Sie nennt Quellenklassen und allgemeine Bereinigungsschritte, aber keine vollständige Liste einzelner Datensätze oder Domänenanteile.
Für die Optimierung kombinierte das Team Muon für große Matrixgewichte mit Adam für andere Parameter. Die Stärke des Weight Decay wurde an das Quadrat der Lernrate gekoppelt, um die Größenordnung der Gewichte über lange Trainingsläufe stabil zu halten.
Im Post-Training deckte Thinking Machines Mathematik, agentisches Coding, Tool-Nutzung, Bild- und Audioaufgaben, Chat sowie Safety ab. Ein anfängliches Supervised Fine-Tuning nutzte synthetische Daten, die unter anderem von Kimi K2.5 erzeugt wurden. Dieser Bootstrap machte laut Anbieter nur einen kleinen Teil des gesamten Compute-Budgets aus. Der größere Anteil floss in großskaliges Reinforcement Learning.
Thinking Machines berichtet von mehr als 30 Millionen Rollouts in zwei langen, stabilen Trainingsläufen. Die aggregierte Reasoning-Leistung habe sich dabei über den gesamten Bereich näherungsweise logarithmisch-linear verbessert. Das Modell wurde auf NVIDIA-GB300-NVL72-Systemen trainiert.
Kontrollierbarer Denkaufwand
Inkling besitzt keinen einzigen starren Reasoning-Modus. Der Denkaufwand kann über Stufen wie none, minimal, low, medium, high, xhigh und max beziehungsweise in Tinker über einen Fließkommawert gesteuert werden. Mehr Effort erlaubt längere interne Lösungswege, erhöht aber Tokenverbrauch, Kosten und Latenz.
Thinking Machines vergleicht die gesamte Leistungs-/Token-Kurve statt nur den Maximalwert. Im eigenen Vergleich erreicht Inkling auf Terminal-Bench 2.1 ungefähr das Leistungsniveau von Nemotron 3 Ultra mit etwa einem Drittel der generierten Tokens. Diese Aussage stammt aus einem Anbieterbenchmark und sollte unabhängig reproduziert werden. Ein kontrollierbares Reasoning-Budget erlaubt es, je nach Workflow zwischen Geschwindigkeit und Qualität zu wählen.
Benchmarks: Ergebnisse nach Aufgabe und Vergleichsmodellen
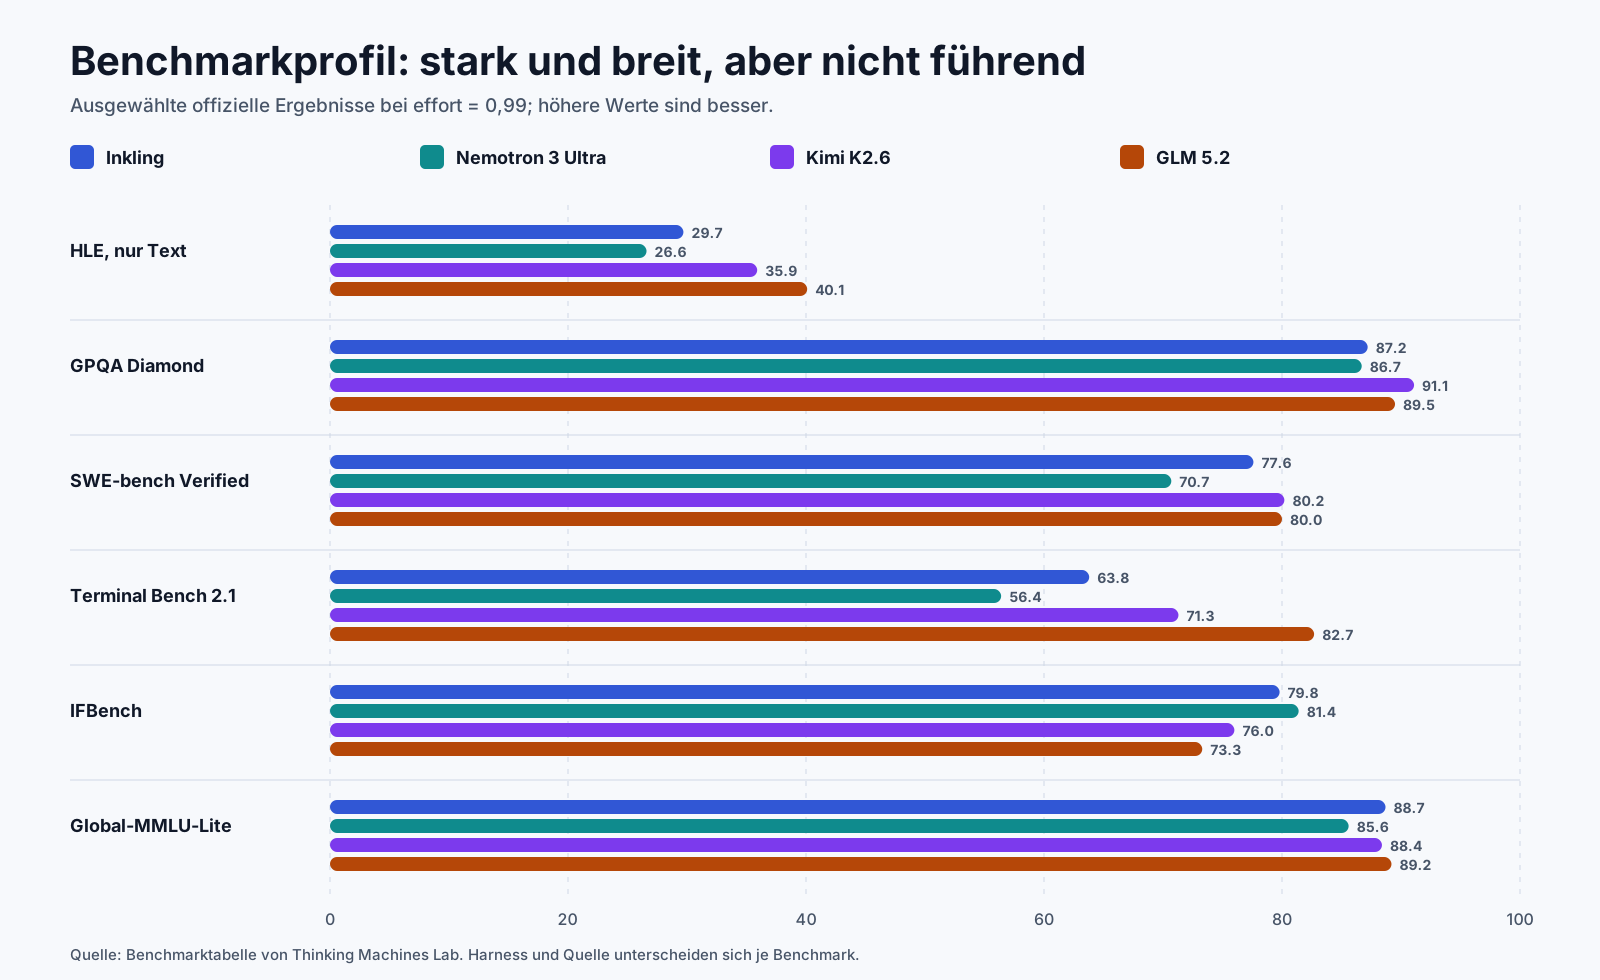
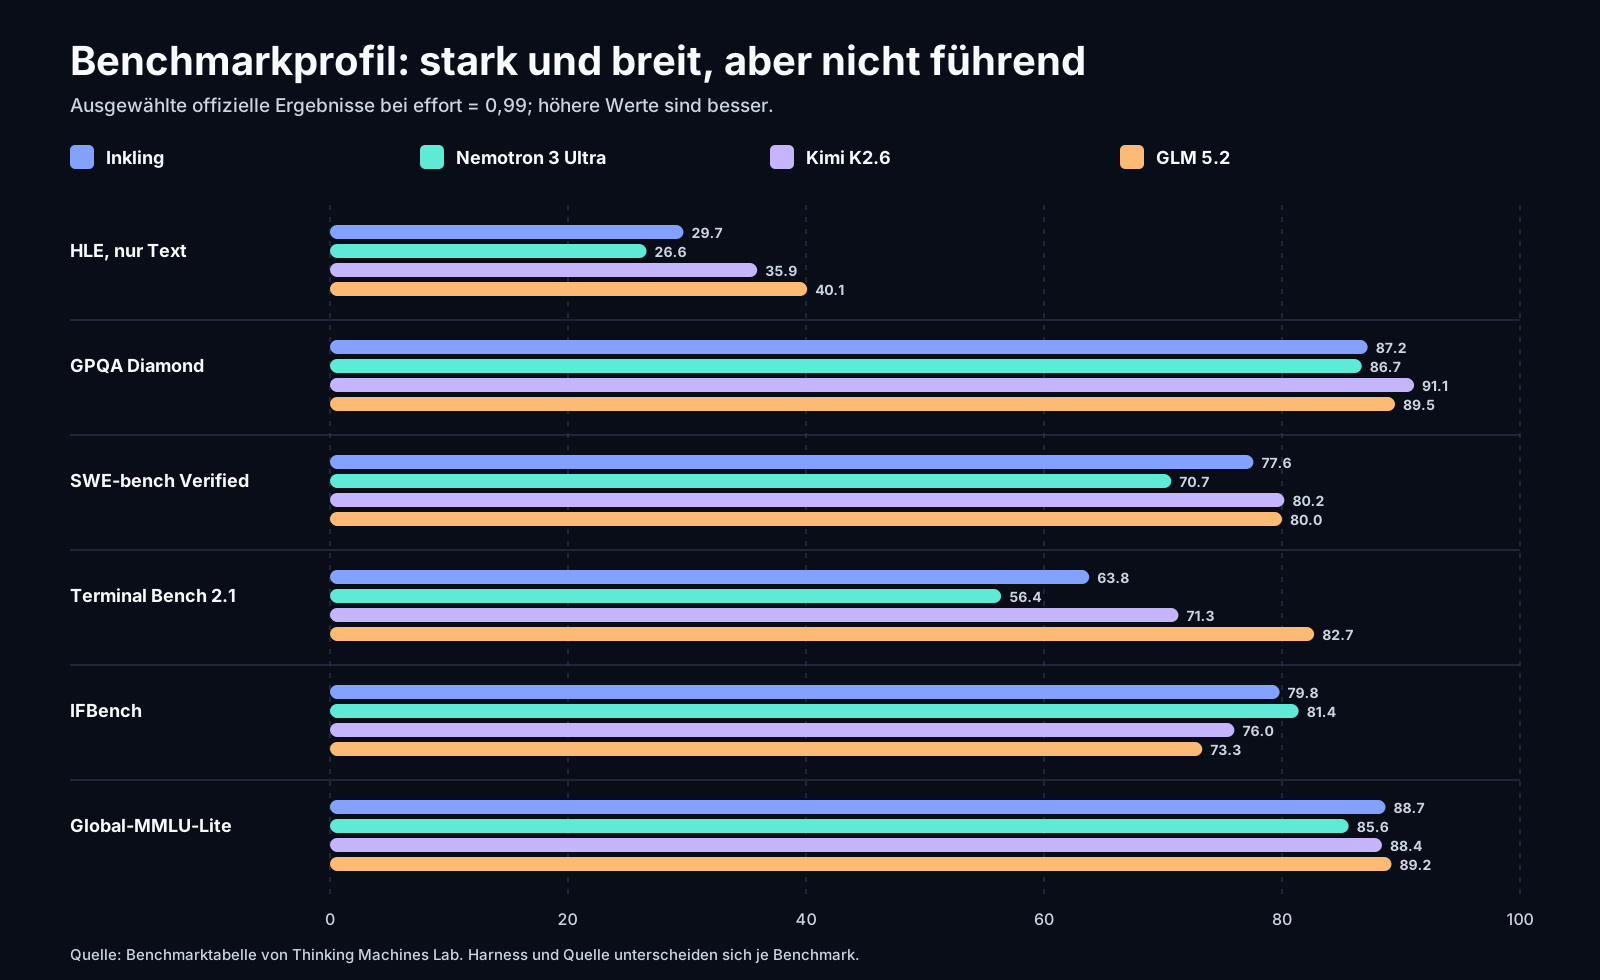
Die Ergebnisse unterscheiden sich je nach Test deutlich: Bei AIME 2026 erreicht Inkling 97,1 Prozent, bei GPQA Diamond 87,2 Prozent und bei Humanity’s Last Exam ohne Tools 29,7 Prozent. Auf HLE mit Tools steigt das Ergebnis auf 46,0 Prozent.
Im agentischen Coding erzielt Inkling 77,6 Prozent auf SWE-bench Verified, 54,3 Prozent auf SWE-bench Pro Public und 63,8 Prozent auf Terminal-Bench 2.1 mit dem jeweils besten Harness. Der offizielle Releasepost vom 30.07.2026 zeigt, dass die Schwester Inkling-Small Inkling bei Humanity’s Last Exam (31,6 % vs. 29,7 %), bei SWE-bench Verified (80,2 % vs. 77,6 %) und Terminal-Bench 2.1 (64,7 % vs. 63,8 %) übertrifft, während Inkling bei Wissensabdeckung und Faktentreue vorne liegt. Hinter Kimi K2.6, GLM 5.2 und den stärksten geschlossenen Systemen bleibt die Familie aber insgesamt zurück.
Auf IFBench erreicht Inkling 79,8 Prozent. Auf Global-MMLU-Lite erzielt es 88,7 Prozent. Die Werte zeigen breite Instruktions- und Wissensabdeckung, aber keine Spitzenposition.
Die Benchmarks sind nicht vollständig kontrolliert: Thinking Machines verwendet für mehrere Aufgaben extern berichtete Werte von Artificial Analysis, während andere Ergebnisse aus eigenen Harnesses stammen. Parallel dazu entstanden die Inkling-Werte unter den spezifischen Parametern effort = 0.99, Temperatur 1,0 und bei Coding-Evaluierungen mit bis zu 256.000 Trajectory-Tokens. Unterschiedliche Harnesses, Tokenbudgets und Modellmodi verhindern einen vollkommen sauberen Eins-zu-eins-Vergleich.
Bild- und Audiofähigkeiten
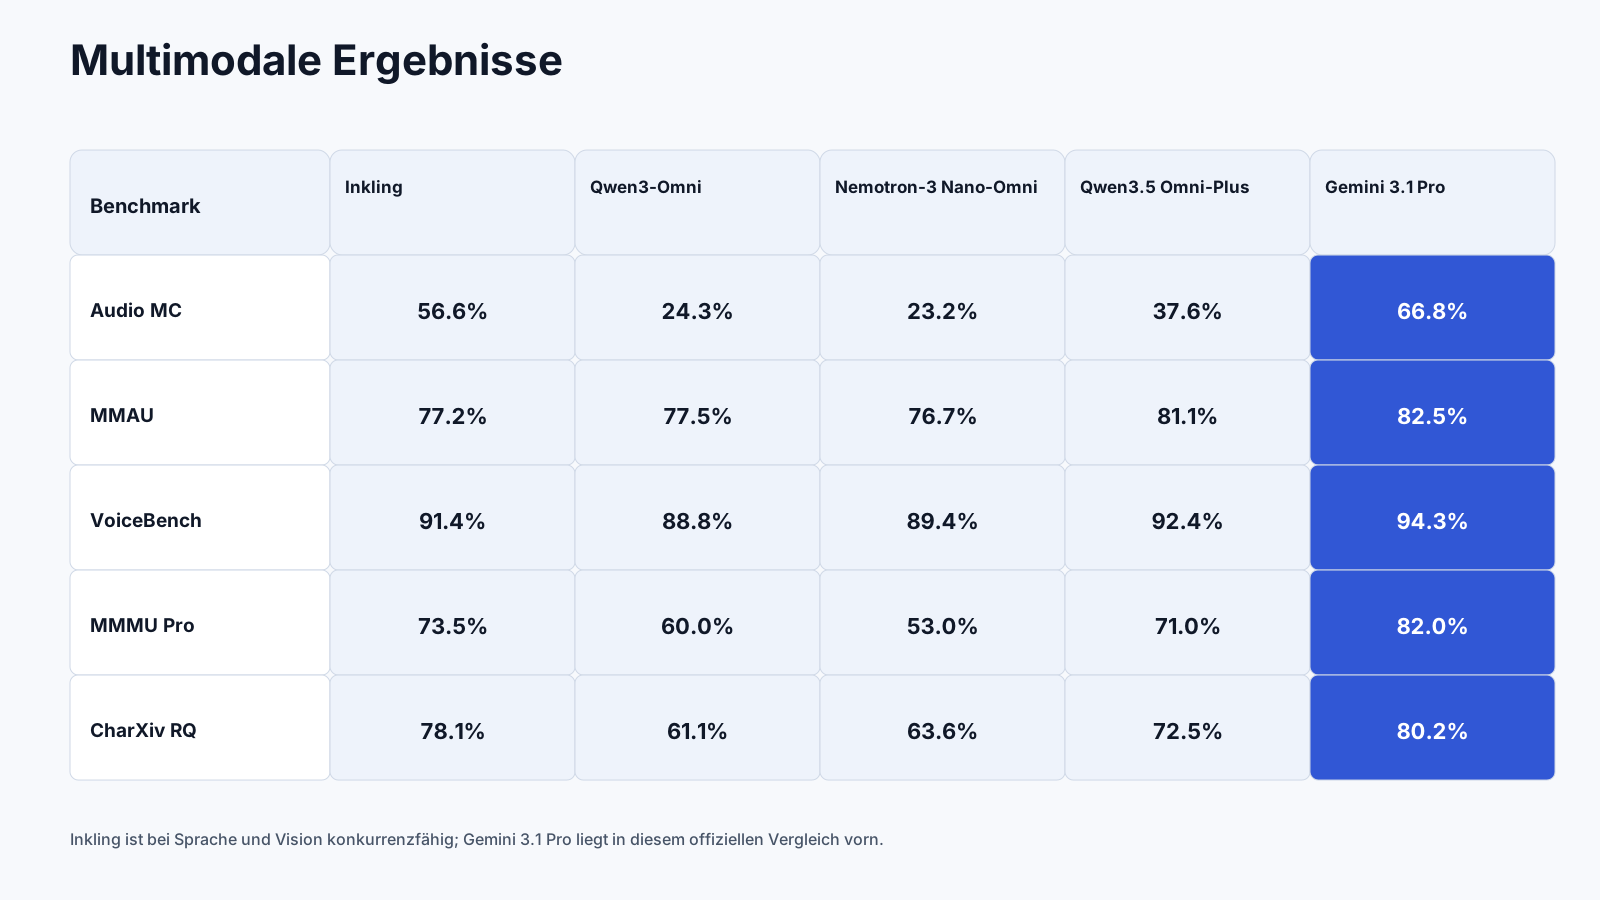
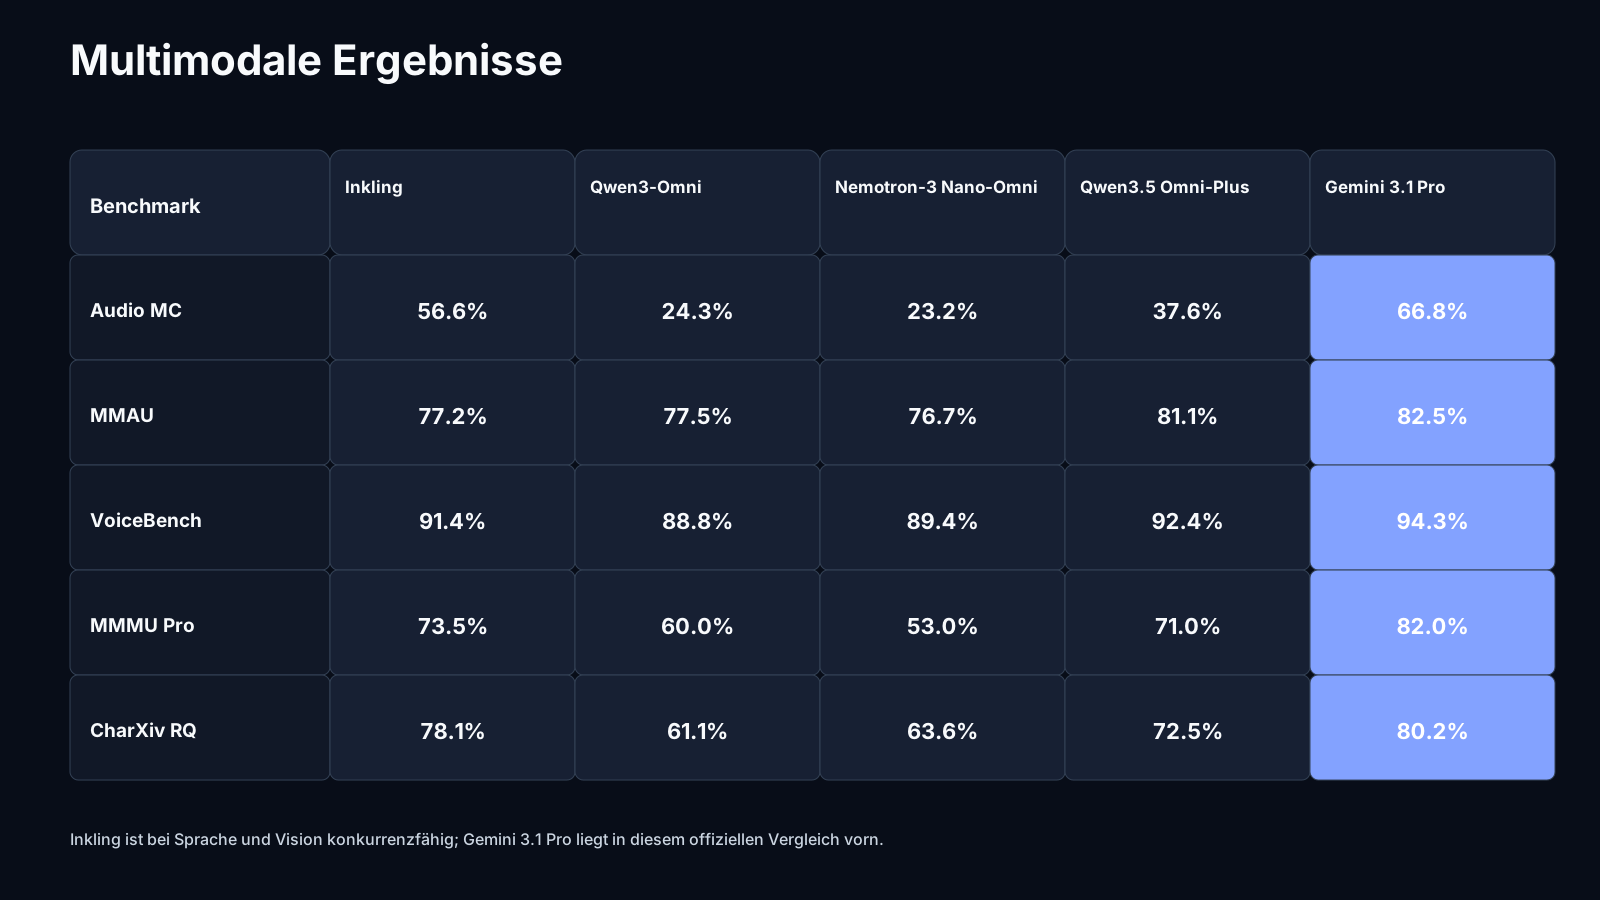
Inkling gehört zu den wenigen sehr großen Open-Weights-Modellen, die Text, Bilder und Audio in einem gemeinsamen Modell verarbeiten. Bei VoiceBench erreicht es 91,4 Prozent, bei MMAU 77,2 Prozent und bei Audio MC 56,6 Prozent. In der offiziellen Vergleichstabelle liegt es klar vor Qwen3-Omni und Nemotron-3 Nano-Omni bei Audio MC, aber hinter Gemini 3.1 Pro.
Im visuellen Reasoning erzielt Inkling 73,5 Prozent auf MMMU Pro Standard 10, 78,1 Prozent auf CharXiv RQ und 82,0 Prozent, wenn CharXiv mit Python-Werkzeugen gelöst wird. Die Ergebnisse betreffen visuelles Schlussfolgern und Diagrammverständnis; die stärksten geschlossenen Modelle bleiben vorne.
Inkling erzeugt ausschließlich Text. Es kann Audio und Bilder verstehen, aber weder Sprache noch Bilder direkt generieren. Video ist architektonisch berücksichtigt, wurde laut Hugging Face jedoch nicht als fertige Standardfähigkeit evaluiert.
Open Weights, Apache 2.0 und die zusätzliche AUP
Die Modellkarte nennt Apache 2.0 als Lizenz. Damit sind kommerzielle Nutzung, Veränderung, Weitergabe und Integration grundsätzlich möglich. Gleichzeitig bindet Thinking Machines den Zugriff und die Nutzung der Modellmaterialien an eine separate Model Acceptable Use Policy. Diese untersagt unter anderem bestimmte schädliche, betrügerische, überwachungsbezogene und hochriskante Anwendungen.
„Open Source“ beschreibt diese Kombination nur unvollständig: Die Gewichte sind offen verfügbar, doch die zusätzliche Nutzungsrichtlinie enthält Verhaltensbeschränkungen, die über die reine Apache-2.0-Lizenz hinausgehen. Für Unternehmen ist eine rechtliche Prüfung sinnvoll, insbesondere wenn abgeleitete Modelle oder öffentliche Dienste angeboten werden sollen.
Auch die Trainingsdaten sind nicht vollständig offen. Thinking Machines beschreibt Herkunftskategorien, mögliche personenbezogene und urheberrechtlich geschützte Inhalte sowie Bereinigung, Deduplication und Filterung. Eine datensatzgenaue Dokumentation, konkrete Mischungsverhältnisse oder vollständige Opt-out-Informationen fehlen jedoch.
Hardwareanforderungen und Self-Hosting
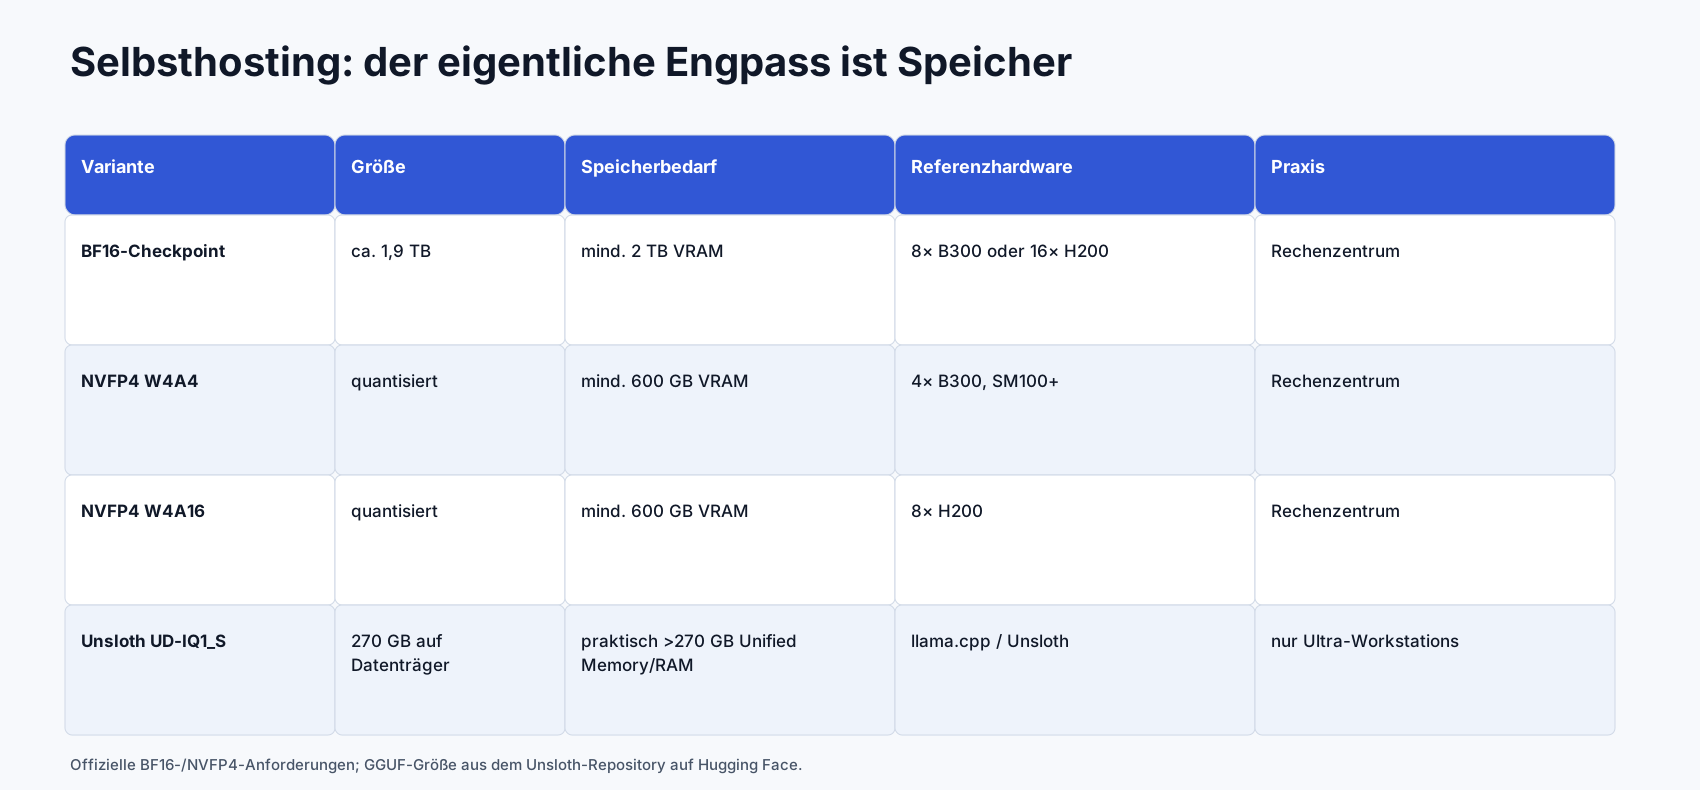
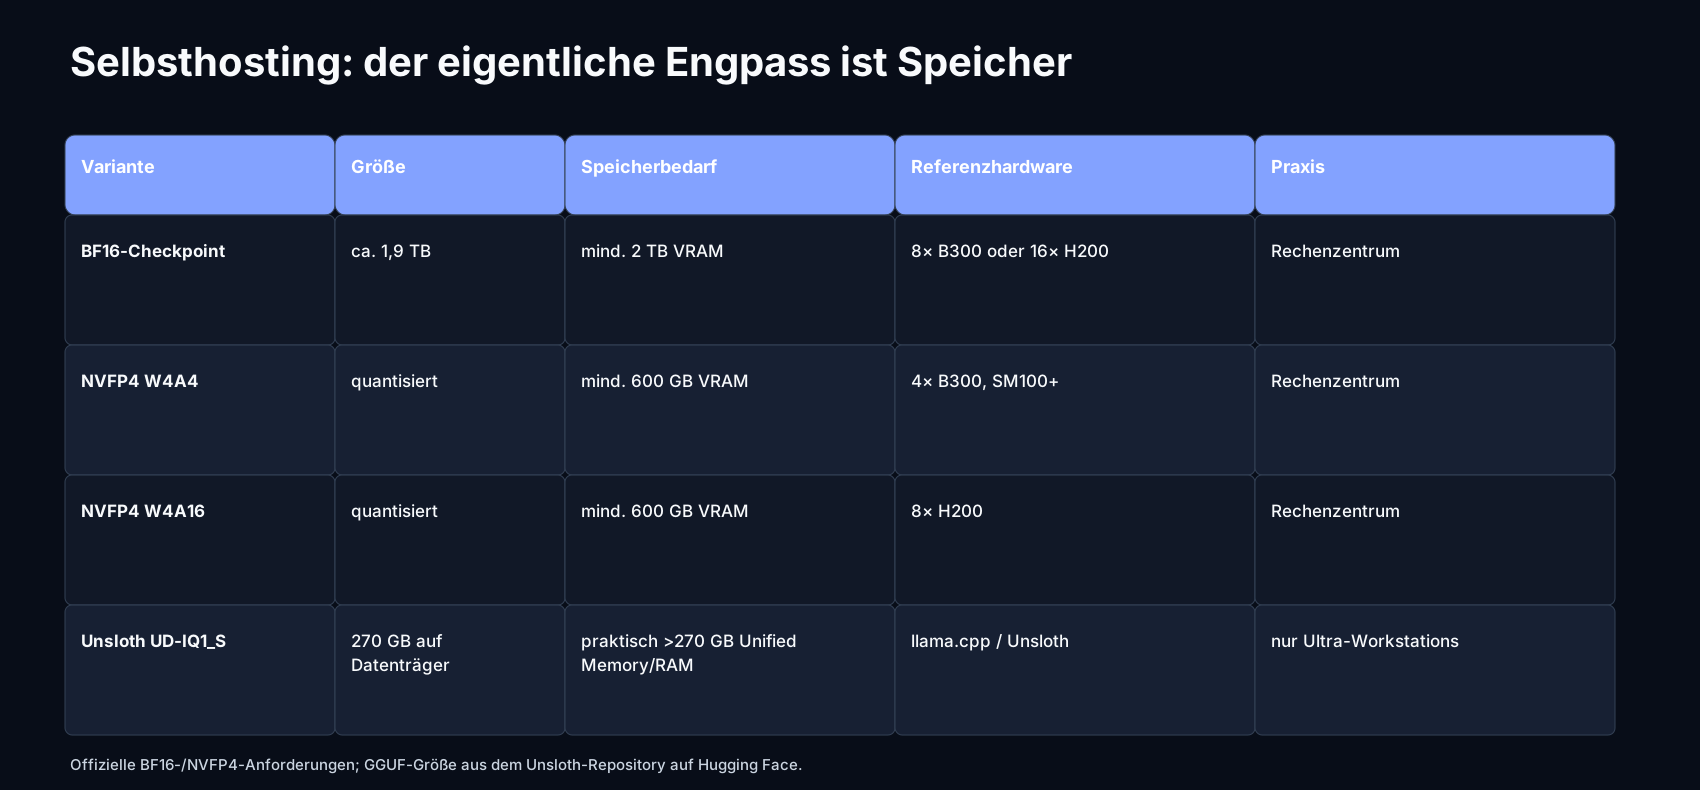
Der offizielle BF16-Checkpoint ist auf Hugging Face rund 1,9 Terabyte groß und benötigt mindestens 2 Terabyte aggregierten VRAM. Thinking Machines nennt acht NVIDIA B300 oder sechzehn H200 als mögliche Konfigurationen.
Die offizielle NVFP4-Variante senkt den Speicherbedarf auf mindestens 600 GB VRAM. W4A4 kann auf vier B300 laufen und erfordert eine SM100- oder neuere Architektur; W4A16 ist für acht H200 vorgesehen. Selbst diese Quantisierung bleibt damit klar im Rechenzentrumsbereich.
Unsloth hat zusätzlich GGUF-Quantisierungen veröffentlicht. Die aggressive UD-IQ1_S-Variante belegt 270 GB auf Datenträger. Sie macht Inkling erstmals für einzelne Hochspeicher-Workstations theoretisch erreichbar, ist aber kein normaler Consumer-Download. Neben den Gewichten werden Speicher für Runtime, Multimodalprojektoren, Kontext und KV-Cache benötigt. Bei einer dynamischen 1-Bit-Quantisierung ist prinzipbedingt mit deutlichen Qualitätsverlusten gegenüber BF16 oder NVFP4 zu rechnen.
Kann Inkling lokal auf einem Mac laufen?
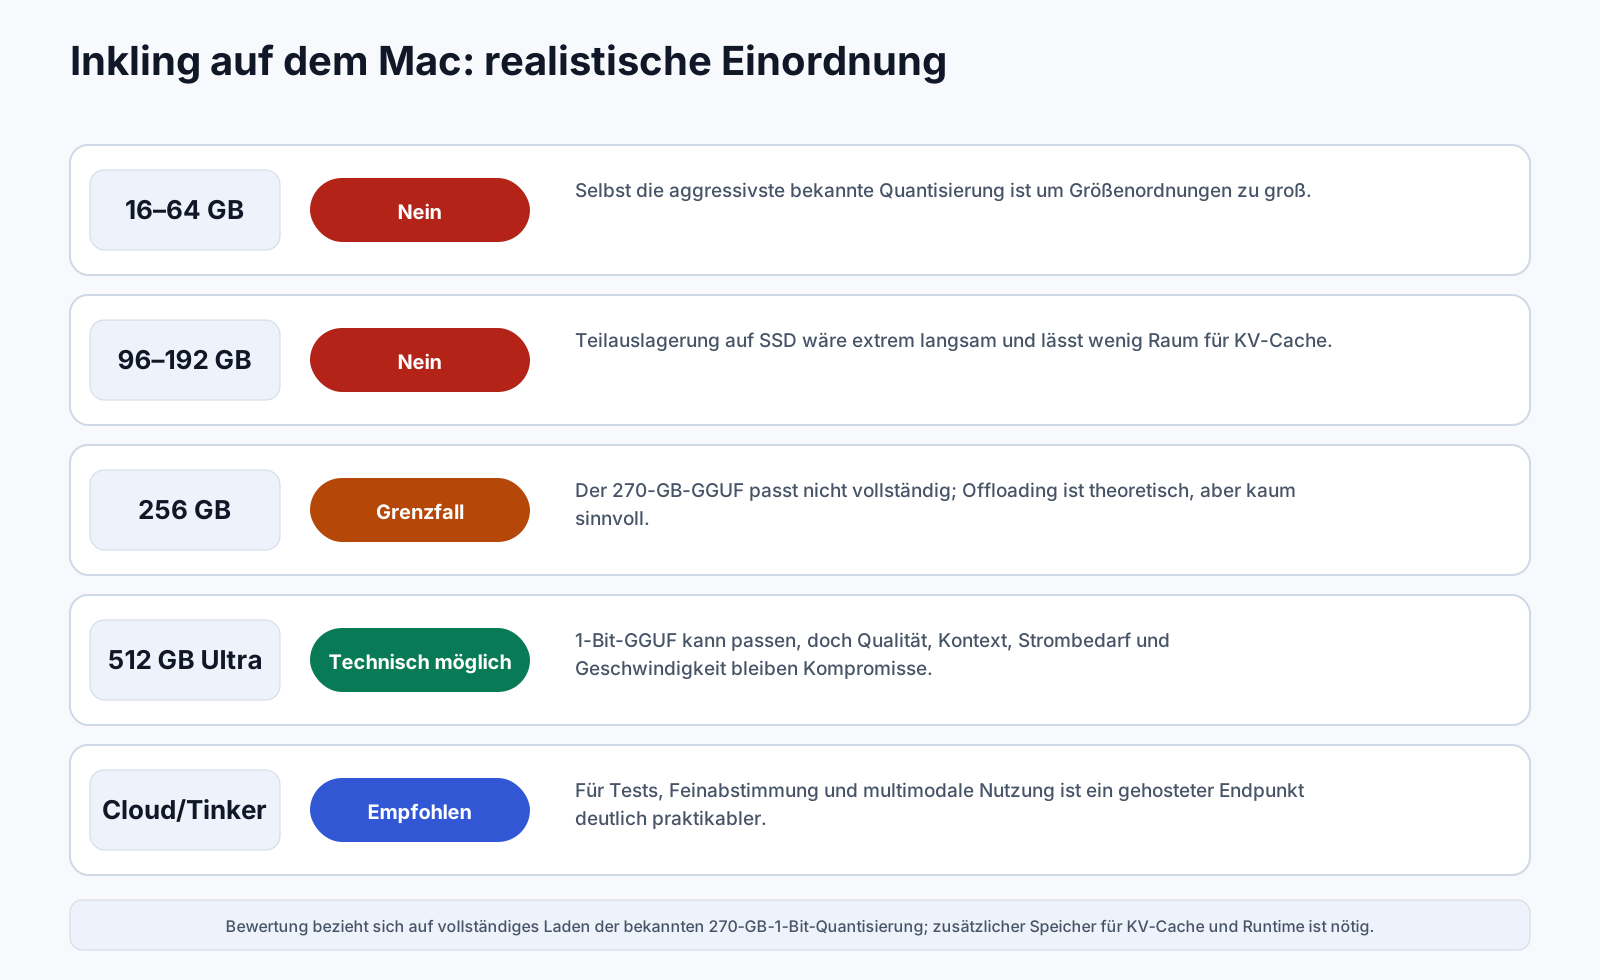
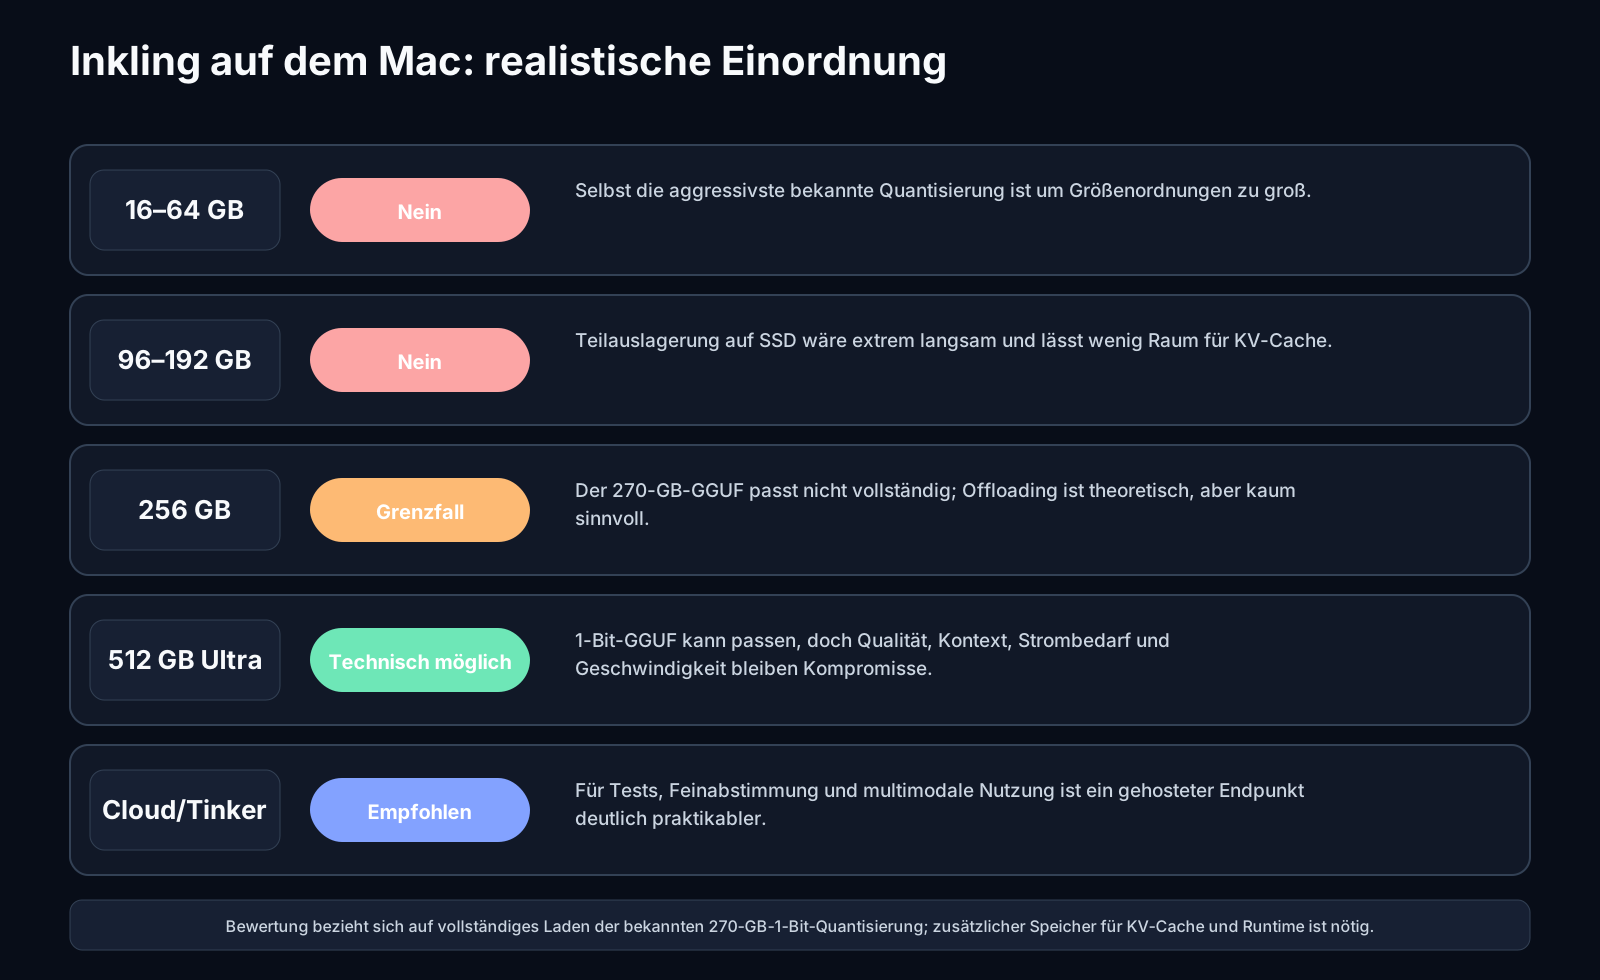
Für typische Macs lautet die Antwort klar: nein. Geräte mit 16, 32, 64, 96 oder 128 GB Unified Memory sind weit von der kleinsten bekannten vollständigen Quantisierung entfernt. Auch ein Mac Studio mit 192 GB kann den 270-GB-GGUF nicht vollständig im Unified Memory halten.
Bei 256 GB wäre starkes SSD-Offloading erforderlich. Mit SSD-Offloading wäre eine Ausführung in llama.cpp technisch möglich, aber bei einem Modell dieser Größe in der Praxis langsam und mit kaum Spielraum für lange Kontexte. Ein Mac mit 512 GB Unified Memory könnte die 1-Bit-Quantisierung theoretisch vollständig laden. Das macht die Konfiguration jedoch nicht automatisch wirtschaftlich: Der 1M-Kontext benötigt zusätzlich erheblichen KV-Cache, die Speicherbandbreite muss fast eine Billion Gesamtparameter bedienen, und die 1-Bit-Qualität liegt deutlich unter dem Original.
Auf Apple Silicon beschränkt sich der sinnvolle Zugriff daher auf Tinker, einen externen Inference Provider oder ein Teacher-Modell zur Distillation eines kleineren On-Device-Modells. Hugging Face nennt ausdrücklich die Möglichkeit, Inklings Dokumentverständnis zur Wissensdistillation in kompaktere Modelle zu verwenden.
Tinker: Nutzung, Fine-Tuning und Preise


Inkling ist in Thinking Machines’ Tinker-Plattform als 64K- und 256K-Variante verfügbar. Die veröffentlichten Gewichte unterstützen bis zu eine Million Tokens, Tinker stellt derzeit aber 64.000 beziehungsweise 256.000 Tokens bereit.
Tinker-Preise, geprüft am 10. Oktober 2026 (USD pro 1 Million Token): Für Inkling kosten Prefill (1,87 $), Cached Prefill (0,374 $) und Sampling (4,68 $) bei 64K und 256K gleich viel. Nur das Training ist mit 256K teurer: 11,23 $ statt 5,61 $ bei 64K. Ein erweitertes Kontextfenster verteuert hier also das Training, nicht diese Inferenz-Tokenarten. Diese Tinker-Training-/Sampling-Sätze sind keine Verbraucherabo-Preise und nicht die separate Serverless-Beta-Tabelle unten. Die 50-%-Aktion ist zeitlich begrenzt; ein festes Ablaufdatum wird nicht genannt. Primärquelle: Tinker-Preisliste als JSON.
Serverless Inference: getrennte Beta-Preise
Tinker bietet inzwischen auch Serverless Inference (Beta) für Inkling und Inkling-Small mit 256K Kontext an. Die API-Beta ist nicht derselbe Tarif wie die 64K-/256K-Trainingsmodelle oben. Die veröffentlichten Beta-Listenpreise pro 1 Million Tokens:
| Serverless Inference (Beta) | Input/Prefill | gecachtes Prefill | Output/Sample |
|---|---|---|---|
| Inkling, 256K | 1,00 $ | 0,17 $ | 4,05 $ |
| Inkling-Small, 256K | 0,30 $ | 0,06 $ | 1,20 $ |
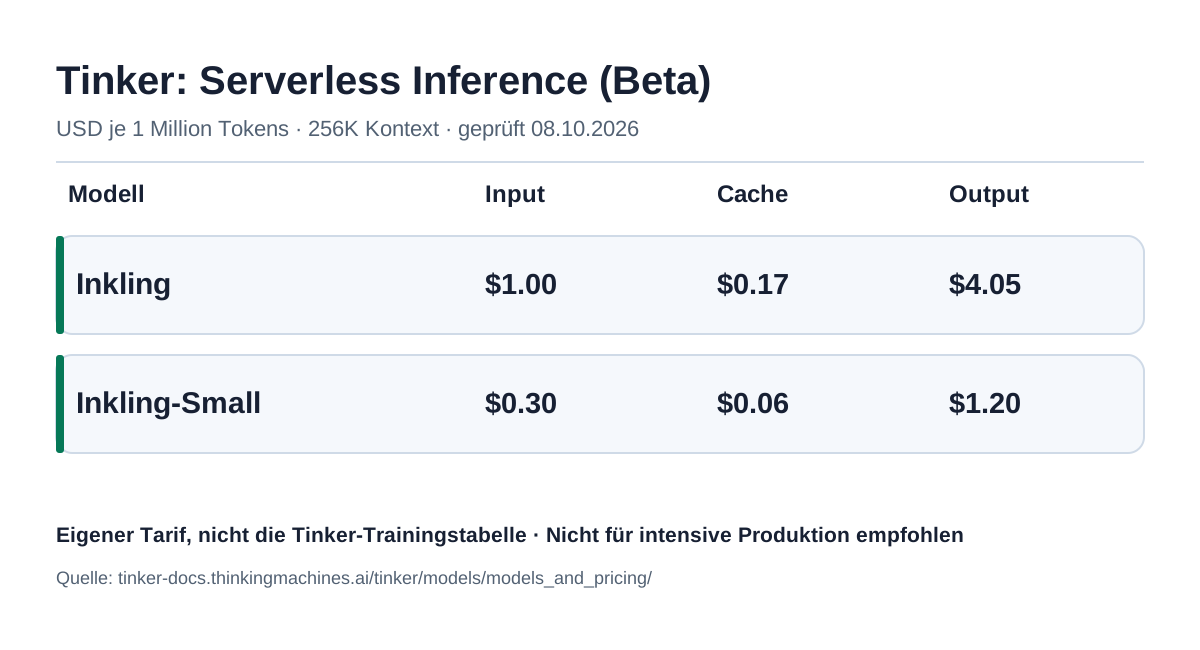
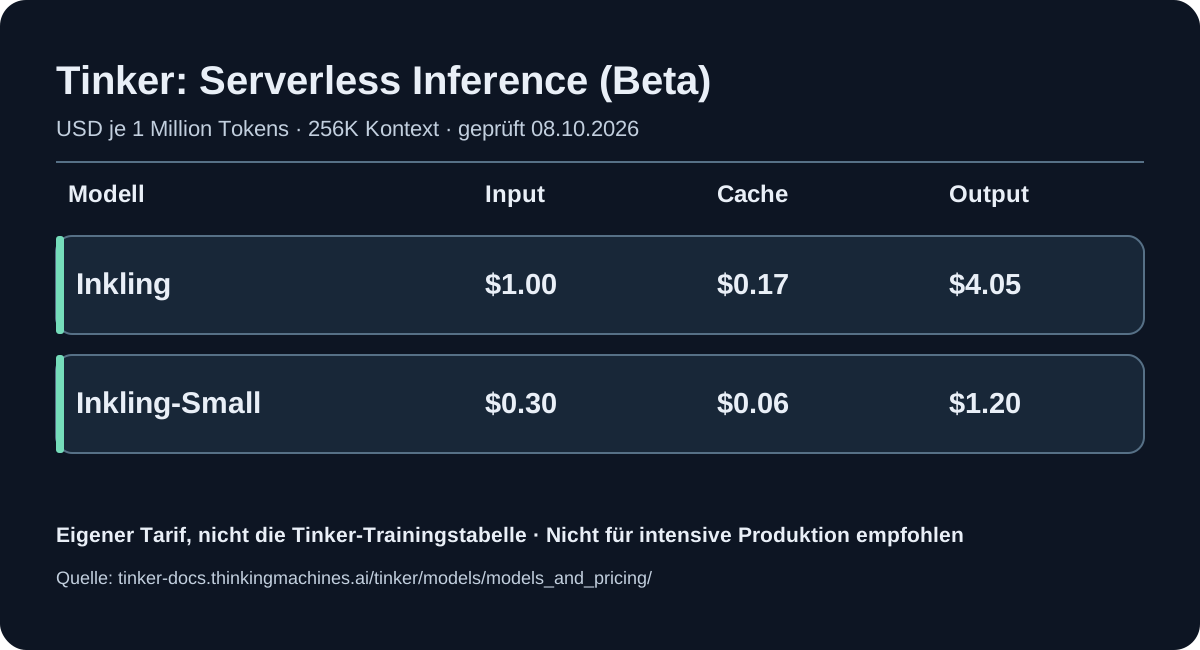
Keine Produktionsfreigabe: Thinking Machines empfiehlt die Serverless-Beta ausdrücklich noch nicht für hohe produktive Last und verweist dafür auf eine Warteliste. Verfügbarkeit, Durchsatz, Modell-ID und Preise vor einer Integration direkt in Tinker prüfen. Tinker-Preisdokumentation.
Tinker unterstützt Supervised Fine-Tuning, PEFT/LoRA, Reinforcement Learning und Distillation. Thinking Machines demonstrierte die Anpassbarkeit, indem Inkling selbst einen Fine-Tuning-Job schrieb, ausführte und evaluierte. Das Beispiel zeigt einen Agenten-Workflow, belegt aber nicht, dass autonome Selbstverbesserung ohne menschliche Kontrolle zuverlässig funktioniert.
Erste Schritte mit Transformers
Der folgende Einstieg entspricht dem Hugging-Face-Beispiel und setzt eine sehr große GPU-Infrastruktur voraus:
from transformers import pipeline

model_id = "thinkingmachines/Inkling"
pipe = pipeline("any-to-any", model=model_id)

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "diagram.png"},
            {"type": "text", "text": "Explain the diagram and identify possible errors."},
        ],
    }
]

result = pipe(
    messages,
    max_new_tokens=2_000,
    return_full_text=False,
    reasoning_effort="high",
)

print(result[0]["generated_text"])
Für eine gehostete Nutzung kann Inkling über Tinker oder kompatible Inference Provider angesprochen werden. Lokale GGUF-Ausführung ist mit llama.cpp möglich, sofern genügend Speicher vorhanden ist:
llama-server -hf unsloth/inkling-GGUF:UD-IQ1_SDas Beispiel startet einen OpenAI-kompatiblen lokalen Server. Auf normalen Macs wird der Download jedoch nicht sinnvoll ausführbar sein.
Safety und bekannte Grenzen
Thinking Machines berichtet für Inkling 78,0 Prozent auf FORTRESS Adversarial und 95,9 Prozent auf FORTRESS Benign. Laut Anbieter sollen die Werte schädliche Anfragen ablehnen und harmlose Anfragen seltener abweisen. StrongREJECT liegt laut Release über 98 Prozent.
Die Modellkarte warnt trotzdem vor typischen Foundation-Model-Risiken: Halluzinationen, ungenaue Befolgung komplexer Anweisungen, Leistungsabfall in langen Dialogen, ungleichmäßige Qualität zwischen Sprachen und Domänen sowie Verzerrungen aus Web- und synthetischen Trainingsdaten. Besonders role-play-basierte oder indirekt formulierte schädliche Anfragen können die eingebauten Schutzmaßnahmen umgehen.
Für öffentliche Produkte empfiehlt Thinking Machines deshalb Defense in Depth: Input- und Output-Klassifikatoren, Moderationsmodelle wie Llama Guard, Rate Limits, Monitoring und menschliche Kontrolle. Medizinische, juristische, finanzielle oder andere folgenreiche Entscheidungen sollten nicht ohne domänenspezifische Validierung und qualifizierte Aufsicht automatisiert werden.
Stärken, Schwächen und Zielgruppe
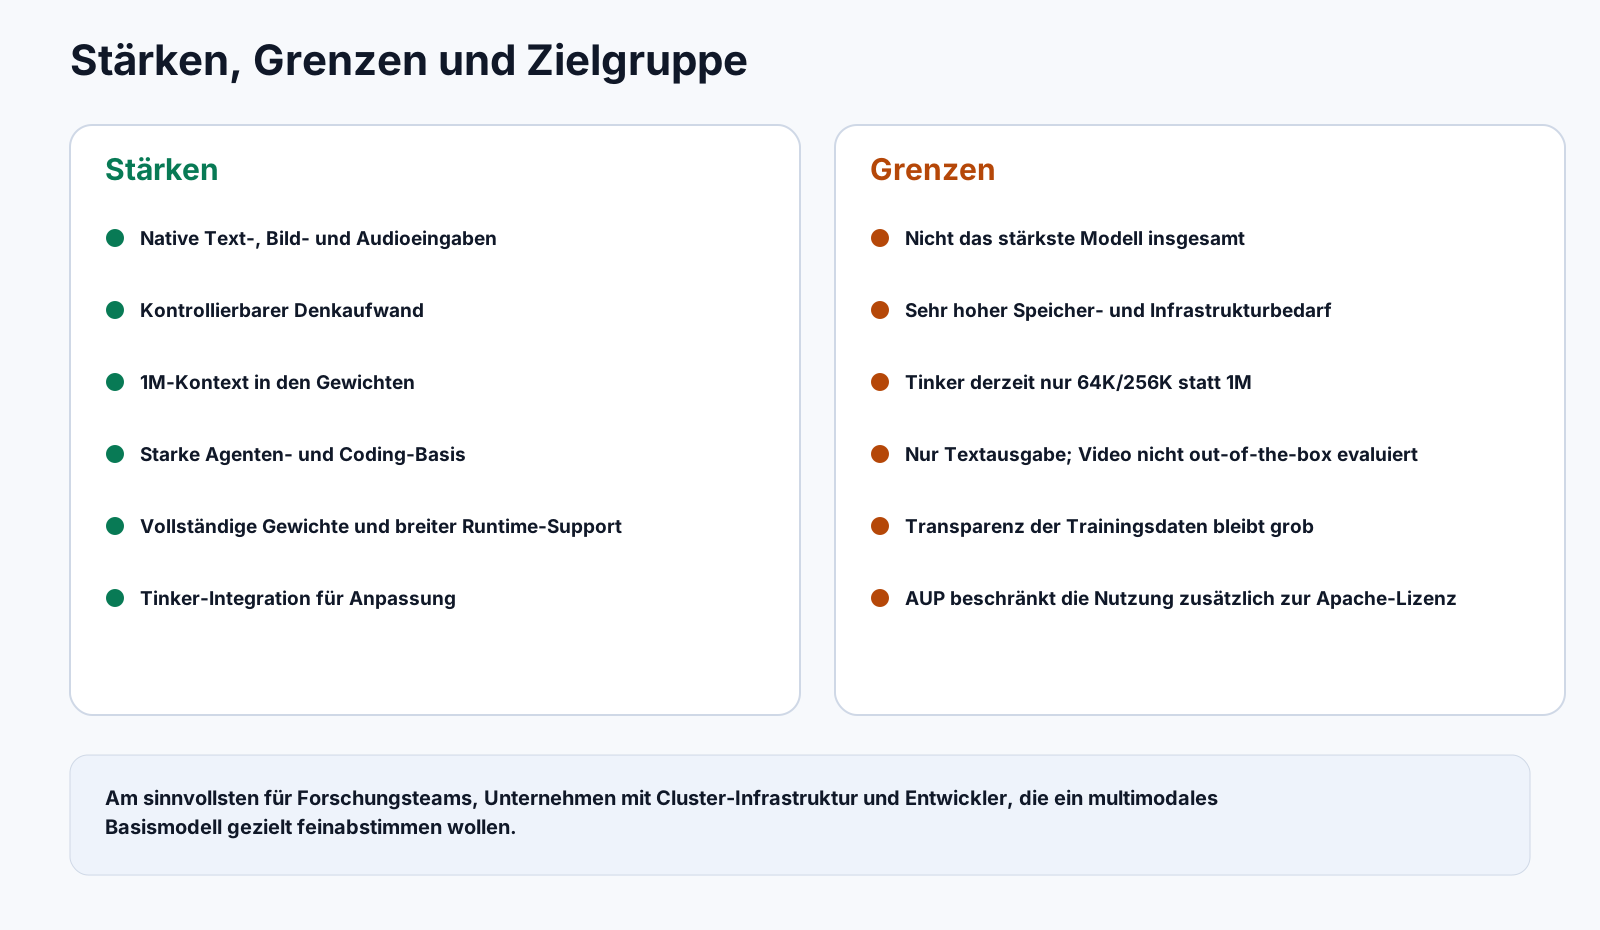
Entscheidend ist nicht die beeindruckende Gesamtparameterzahl: 41 Milliarden aktive Parameter reduzieren die Rechenarbeit pro Token, 975 Milliarden Gesamtparameter bestimmen aber weiterhin wesentlich den Gewichtsspeicher. Tinkers 64K-/256K-Grenzen decken sich keineswegs mit dem nominellen 1M-Kontext der Modellgewichte. Die veröffentlichten Benchmarkwerte sind keine Messungen auf Apple Silicon.
Entscheidung: Cloud-Evaluation oder lokale Inferenz?
| Ziel | Realistischer Weg | Vorher prüfen |
|---|---|---|
| Inkling mit eigenen Prompts evaluieren | Einen eindeutig benannten Hostinganbieter nutzen | Modell-ID und Revision, Kontextgrenze des Dienstes, Tokenkosten, Datenverarbeitung |
| Inkling fine-tunen | Tinker Training/PEFT einsetzen | Unterschied Training/Sampling, Checkpoint-Speicher, zusätzliche Nutzungsrichtlinie |
| Privates LLM auf einem Mac mit 16–128 GB betreiben | Ein kleineres Modell mit Apple-Silicon-Runtime wählen | Dateigröße und KV-Cache, Speicherdruck, tatsächlicher Offline-Pfad |
Ein vollständiges Inkling-Setup auf einem solchen Einzel-Mac lässt sich aus den aktiven Parametern nicht ableiten. Selbst veröffentlichte aggressive Quantisierungen brauchen deutlich mehr Speicher. Dass Modellgewichte auf eine SSD passen, beweist noch keine lauffähige GPU-Inferenz. Konkrete Alternativen stehen im Open-Weight-Roundup und die Speicherrechnung im Unified-Memory-Guide.
Quellen
- Thinking Machines Lab: Inkling – Our open-weights model
- Thinking Machines Lab: Inkling Model Card
- Thinking Machines Lab: Inkling product page
- Thinking Machines Lab: Model Acceptable Use Policy
- Thinking Machines Lab: Training Data Documentation
- Hugging Face: Welcome Inkling by Thinking Machines
- Hugging Face: thinkingmachines/Inkling
- Hugging Face: thinkingmachines/Inkling-NVFP4
- Tinker documentation: Using Inkling
- Tinker documentation: Models and pricing
- Unsloth: inkling-GGUF
- Thinking Machines Lab: Introducing Inkling-Small
- Thinking Machines Lab: Inkling-Small Model Card
Häufig gestellte Fragen
Läuft Inkling lokal auf einem Mac?
Nein. Mit 975 Milliarden Gesamtparametern bleibt Self-Hosting für normale Macs und Workstations praktisch ausgeschlossen. Inkling-Small braucht laut Model Card immer noch Rechenzentrums-Hardware; praktikable Wege sind Tinker oder Remote-Inferenz.
Was ist der Unterschied zwischen Inkling und Inkling-Small?
Inkling hat 975 Milliarden Gesamtparameter und 41 Milliarden aktive pro Token, Inkling-Small 276 Milliarden und 12 Milliarden. Beide verarbeiten Text, Bilder und Audio mit nominell bis zu 1 Million Kontexttokens.
Ist Inkling Open Source?
Teilweise. Die Modellkarte nennt Apache 2.0, zusätzlich bindet Thinking Machines die Nutzung an eine separate Acceptable Use Policy mit Verhaltensbeschränkungen, die über die Lizenz hinausgehen.
Kann Inkling besser als Kimi K2.6 oder GLM 5.2?
Insgesamt nein. Thinking Machines sagt selbst, dass das Modell weder unter offenen noch unter geschlossenen Modellen führend ist. Stärken liegen in Breite, Anpassbarkeit über Tinker und multimodaler Eingabe.