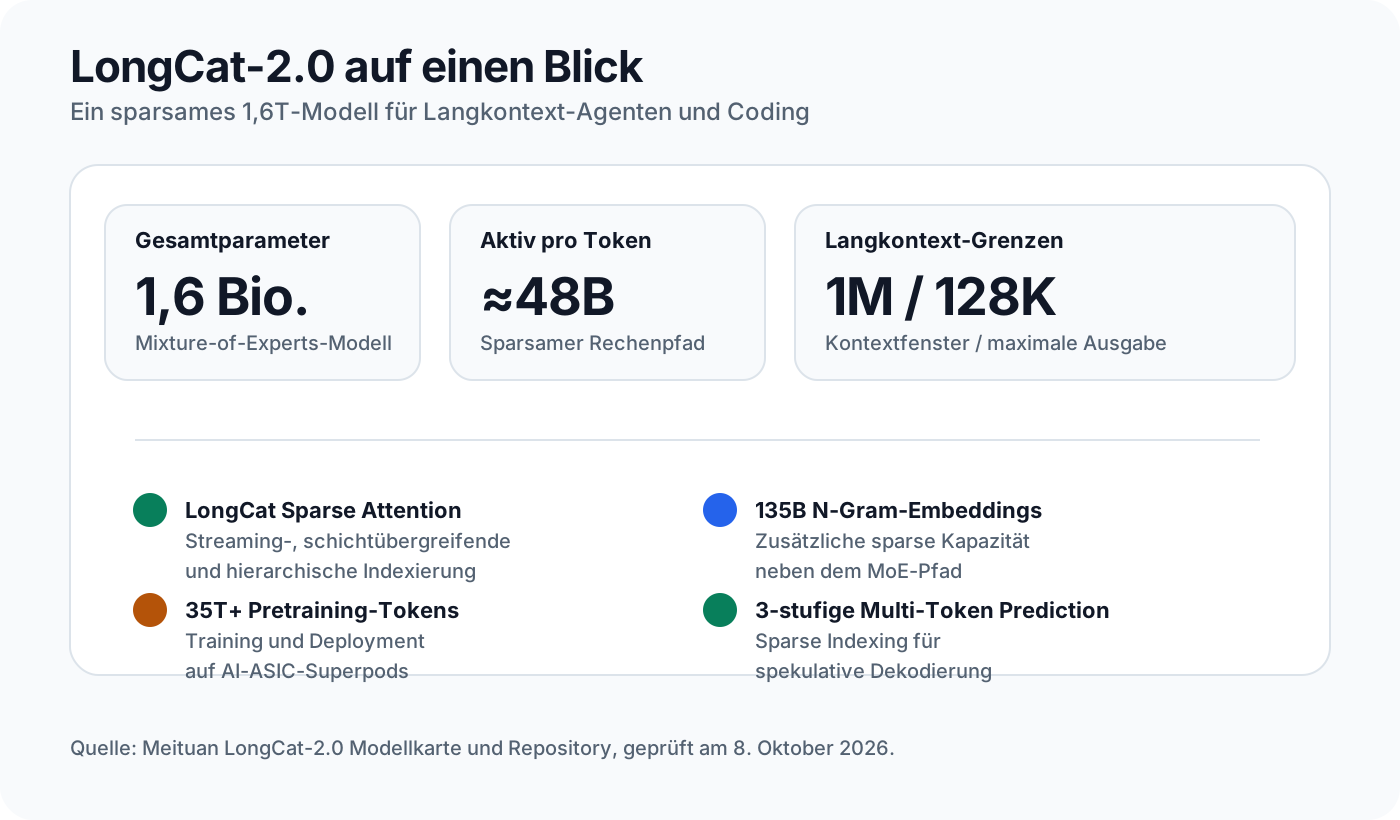
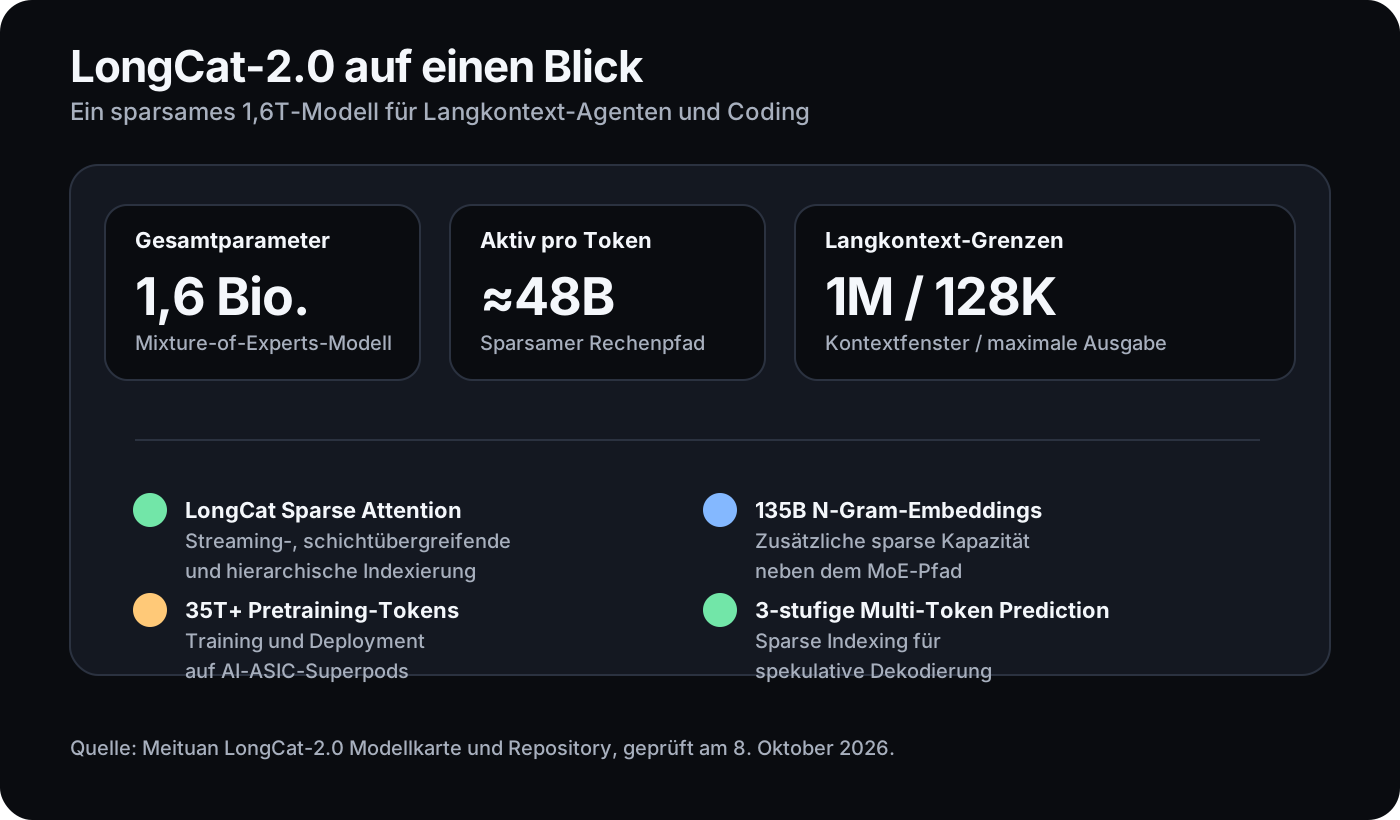
LongCat-2.0 ist Meituans neues Open-Weight-Sprachmodell für Coding, lang laufende Agenten und komplexe Tool-Workflows. Das Modell kombiniert eine Mixture-of-Experts-Architektur mit 1,6 Billionen Gesamtparametern, ungefähr 48 Milliarden aktivierten Parametern pro Token, einem Kontextfenster von bis zu einer Million Tokens und einer maximalen API-Ausgabe von 128.000 Tokens.12
Aktualisiert am 8. Oktober 2026. LongCat-2.0 ist Meituans öffentliches Open-Weight-Modell mit 1,6 Billionen Gesamtparametern, rund 48 Milliarden aktiven Parametern pro Token und einem API-Kontextfenster von 1 Million Tokens. Das Modell ist unter der MIT-Lizenz verfügbar, benötigt für vollständiges Selbsthosting aber Rechenzentrums-Hardware. Die LongCat-Plattform bietet inzwischen zusätzlich LongCat-2.5-Preview an – einen anderen API-Modellnamen mit Bildverständnis. Die beiden Versionen sind nicht gleichzusetzen.123
Die offiziellen Preislisten sind weiterhin öffentlich. Allerdings gelten Standard- und befristete Rabattpreise parallel; entscheidend ist die Abrechnung im eigenen Konto. Die konkreten Beträge und Cache-Rechnungen stehen weiter unten.4
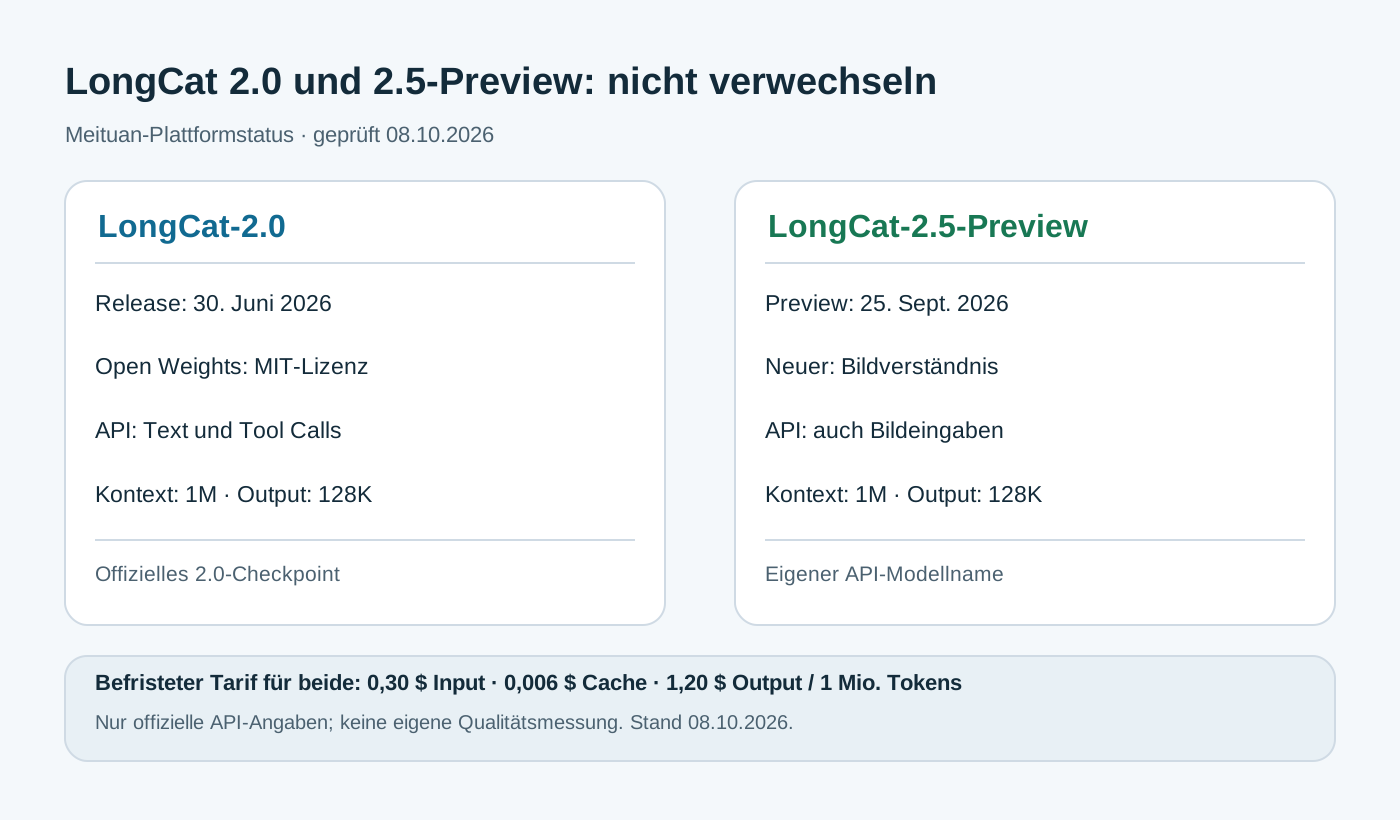
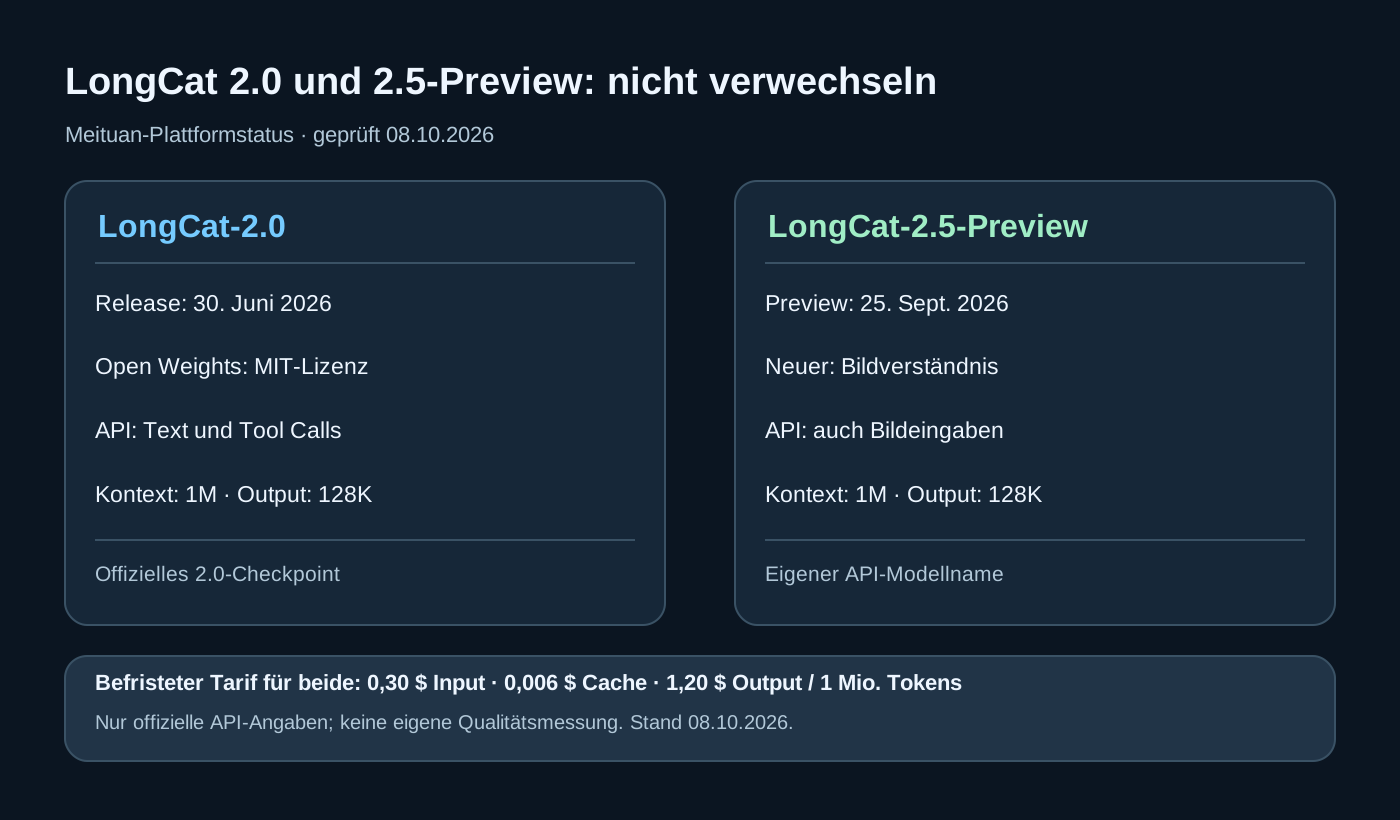
LongCat-2.0 oder LongCat-2.5-Preview? Aktueller Plattformstatus
Die offizielle Änderungshistorie dokumentiert die reguläre Freigabe von LongCat-2.0 am 30. Juni 2026 und den Start von LongCat-2.5-Preview am 25. September 2026. Beide Modell-IDs werden im aktuellen API-Quickstart aufgeführt.
| Entscheidungskriterium | LongCat-2.0 | LongCat-2.5-Preview |
|---|---|---|
| API-Modell-ID | LongCat-2.0 | LongCat-2.5-Preview |
| Status | reguläres API-Modell, offene 2.0-Gewichte | neueres Preview-API-Modell |
| Eingaben | textorientiertes Sprachmodell | zusätzlich Bildverständnis dokumentiert |
| API-Kontext / maximaler Output | 1M / 128K Tokens | 1M / 128K Tokens |
| Veröffentlichte Gewichte | 2.0-Checkpoint auf Hugging Face unter MIT | nicht identisch mit dem 2.0-Checkpoint; separat prüfen |
| Pay-as-you-go-Rabatt (USD/M) | 0,30 Input / 0,006 Cache / 1,20 Output | 0,30 Input / 0,006 Cache / 1,20 Output laut aktueller Preview-Preisliste |
Wichtig: Der 2.0-Artikel ist keine technische Modellkarte für 2.5. Vor einem Wechsel sollten Agenten die Tool-Calls, das Reasoning-Verhalten, die Latenz und das tatsächliche Prompt-Caching auf dem eigenen Harness testen. Die neuen multimodalen Fähigkeiten sind ein Grund, 2.5 separat zu prüfen – kein Beleg, dass jedes Coding-Benchmark-Ergebnis automatisch besser ist.35
LongCat-2.0 in Kürze
| Merkmal | Offizielle Angabe | Einordnung |
|---|---|---|
| Gesamtparameter | 1,6 Billionen | Mixture-of-Experts-Modell mit 1,6 Billionen Gesamtparametern |
| Aktivierte Parameter | ca. 48 Milliarden pro Token | Rechenaufwand deutlich kleiner als der gesamte Parameterbestand |
| Kontextfenster | 1.000.000 Tokens | Für große Repositories, lange Dokumente und Agentenverläufe |
| Maximale Ausgabe | 128.000 Tokens | Maximal dokumentierte API-Ausgabe |
| Pretraining | mehr als 35 Billionen Tokens | Laut Meituan auf AI-ASIC-Superpods |
| N-Gram-Embedding | 135 Milliarden Parameter | Zusätzliche sparse Kapazität |
| Lizenz | MIT | Breite Verwendung unter den Lizenzbedingungen |
| API-Formate | OpenAI und Anthropic | Einfache Integration in bestehende Anwendungen |
| Schwerpunkt | Coding und Agenten | Tool Calls, mehrstufige Aufgaben, Repository-Änderungen |
Was ist LongCat-2.0?
LongCat-2.0 gehört zur LongCat-Modellfamilie von Meituan. Der Vorgänger LongCat-Flash nutzte ebenfalls eine Mixture-of-Experts-Architektur, war mit 560 Milliarden Gesamtparametern und durchschnittlich rund 27 Milliarden aktivierten Parametern pro Token jedoch deutlich kleiner. LongCat-2.0 erweitert sowohl den Modellumfang als auch das Langkontext-Design.6
Die API-Vorschau von LongCat-2.0 erschien im April 2026. Am 30. Juni 2026 dokumentierte Meituan die reguläre Freigabe und den Start des kostenpflichtigen API-Angebots. Parallel stellte die Plattform mehrere ältere LongCat-Dienste zurück, um Ressourcen auf LongCat-2.0 zu konzentrieren.3
Der zentrale Unterschied zu einem klassischen dichten Modell lautet: Nicht alle 1,6 Billionen Parameter werden für jedes Token berechnet. Ein Router wählt für jeden Verarbeitungsschritt relevante Experten aus. Rund 48 Milliarden Parameter werden aktiviert. Dadurch bleibt der Rechenpfad wesentlich kleiner als das vollständige Modell, obwohl alle Gewichte gespeichert oder über ein verteiltes System verfügbar sein müssen.
Architektur: Warum 1,6 Billionen Parameter nicht 1,6 Billionen aktive Parameter bedeuten
Bei einem dichten Transformer nehmen alle Modellparameter an jeder Vorwärtsrechnung teil. Ein Mixture-of-Experts-Modell verteilt dagegen Teile der Feedforward-Berechnung auf viele spezialisierte Experten. Für ein Token wird nur eine Auswahl davon aktiviert.
LongCat-2.0 meldet ungefähr 48 Milliarden aktive Parameter je Token. Das entspricht nur etwa drei Prozent der angegebenen 1,6 Billionen Gesamtparameter. Daraus ergeben sich zwei unterschiedliche Anforderungen:
- Rechenaufwand: Pro Token muss nur der aktive Pfad berechnet werden.
- Speicher- und Infrastrukturbedarf: Die vollständigen Expertengewichte müssen trotzdem verfügbar sein, typischerweise verteilt über viele Beschleuniger.
Die Zahl der aktiven Parameter ist deshalb kein Maß für die Dateigröße des Modells. Sie erklärt, warum LongCat-2.0 trotz seiner enormen Gesamtkapazität effizienter als ein dichtes 1,6T-Modell inferiert werden kann. Sie macht es aber nicht zu einem gewöhnlichen lokalen 48B-Modell.
LongCat Sparse Attention
Normale Self-Attention vergleicht bei langen Sequenzen sehr viele Tokenpaare. Die Kosten wachsen in einer naiven Implementierung quadratisch mit der Sequenzlänge. Bei einer Million Tokens wird dieser Ansatz praktisch unbrauchbar. LongCat-2.0 führt deshalb LongCat Sparse Attention (LSA) ein.1
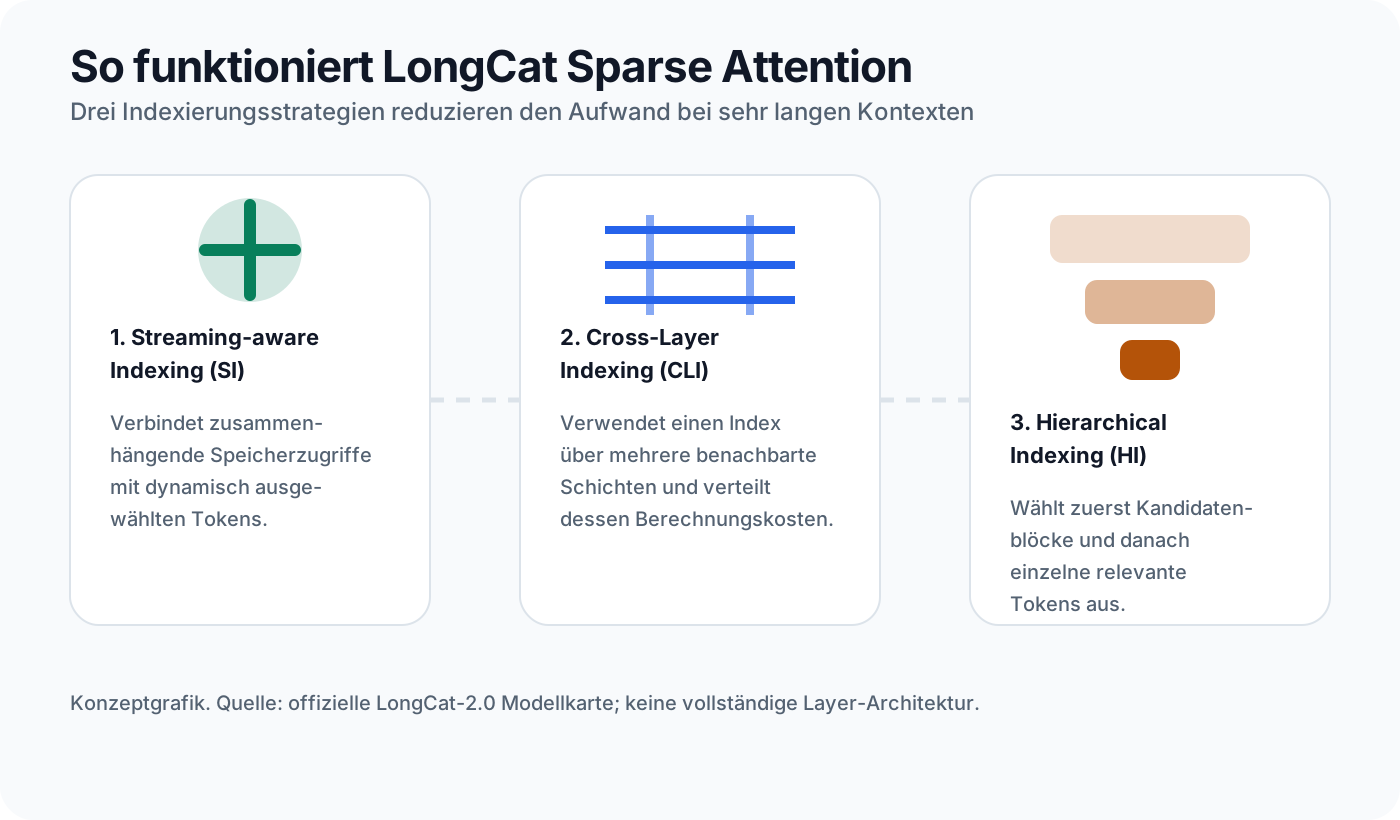
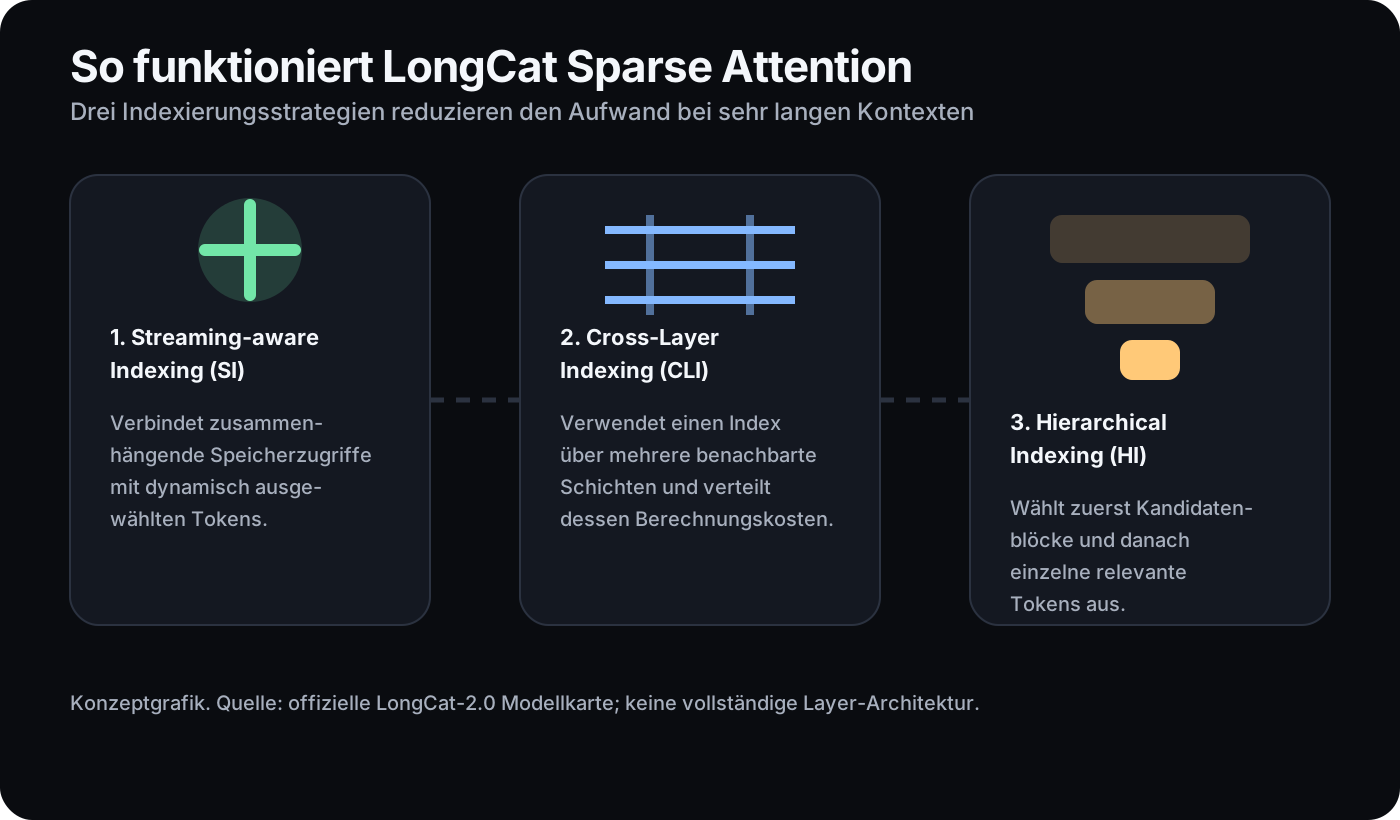
LSA kombiniert drei Verfahren:
Streaming-aware Indexing (SI) verbindet zusammenhängende, hardwarefreundliche Speicherzugriffe mit dynamisch ausgewählten Tokens. Statt vieler kleiner und schlecht planbarer Zugriffe sollen größere, sequenzielle HBM-Leseoperationen entstehen.
Cross-Layer Indexing (CLI) nutzt die Beobachtung, dass wichtige Attention-Positionen in benachbarten Schichten oft ähnlich bleiben. Ein berechneter Index kann deshalb für mehrere aufeinanderfolgende Layer wiederverwendet werden. Meituan nennt Cross-Layer-Distillation als Trainingsmechanismus, der diese Wiederverwendung ermöglicht.
Hierarchical Indexing (HI) führt eine zweistufige Auswahl durch. Zuerst werden auf Blockebene aussichtsreiche Kandidaten grob bestimmt. Danach erfolgt innerhalb dieser Blöcke die feinere Tokenauswahl. Der teure Feinscore muss dadurch nur noch auf einem kleineren Kandidatenraum arbeiten.
Meituan verbindet diese Verfahren zudem mit einem dreistufigen Multi-Token-Prediction-Modul für spekulative Dekodierung. Mehrere kommende Tokens werden vorgeschlagen, während Indexinformationen teilweise gemeinsam genutzt werden.1
135 Milliarden Parameter für N-Gram-Embeddings
LongCat-2.0 übernimmt N-Gram-Embeddings aus LongCat-Flash-Lite. Insgesamt sollen 135 Milliarden Parameter in diesen Embeddings stecken. Sie erweitern die Modellkapazität in einer anderen sparsamen Dimension als die MoE-Experten.1
Vereinfacht gesagt können häufige Tokenfolgen zusätzliche gelernte Repräsentationen erhalten. Das kann lokale Muster effizienter abbilden, ohne sämtliche zusätzliche Kapazität in immer mehr Experten zu investieren. Meituan behauptet, dass die gewählte Mischung robuster skaliert als ein gleich großes reines MoE-Modell. Unabhängige Ablationen speziell für LongCat-2.0 sind zum Veröffentlichungszeitpunkt jedoch noch begrenzt.
Eine Million Tokens Kontext: Was das praktisch bedeutet
Die LongCat-API dokumentiert ein Kontextfenster von 1.000.000 Tokens und eine maximale Ausgabe von 128.000 Tokens.2 Das unterstützt folgende Aufgaben:
- Analyse großer Software-Repositories
- Verarbeitung langer Log- und Terminalverläufe
- Zusammenführung zahlreicher Dokumente
- agentenbasierte Workflows mit vielen Zwischenschritten und Tool-Ergebnissen
- umfangreiche Code-Migrationen mit vielen abhängigen Dateien
- lange Recherche- und Automatisierungsworkflows
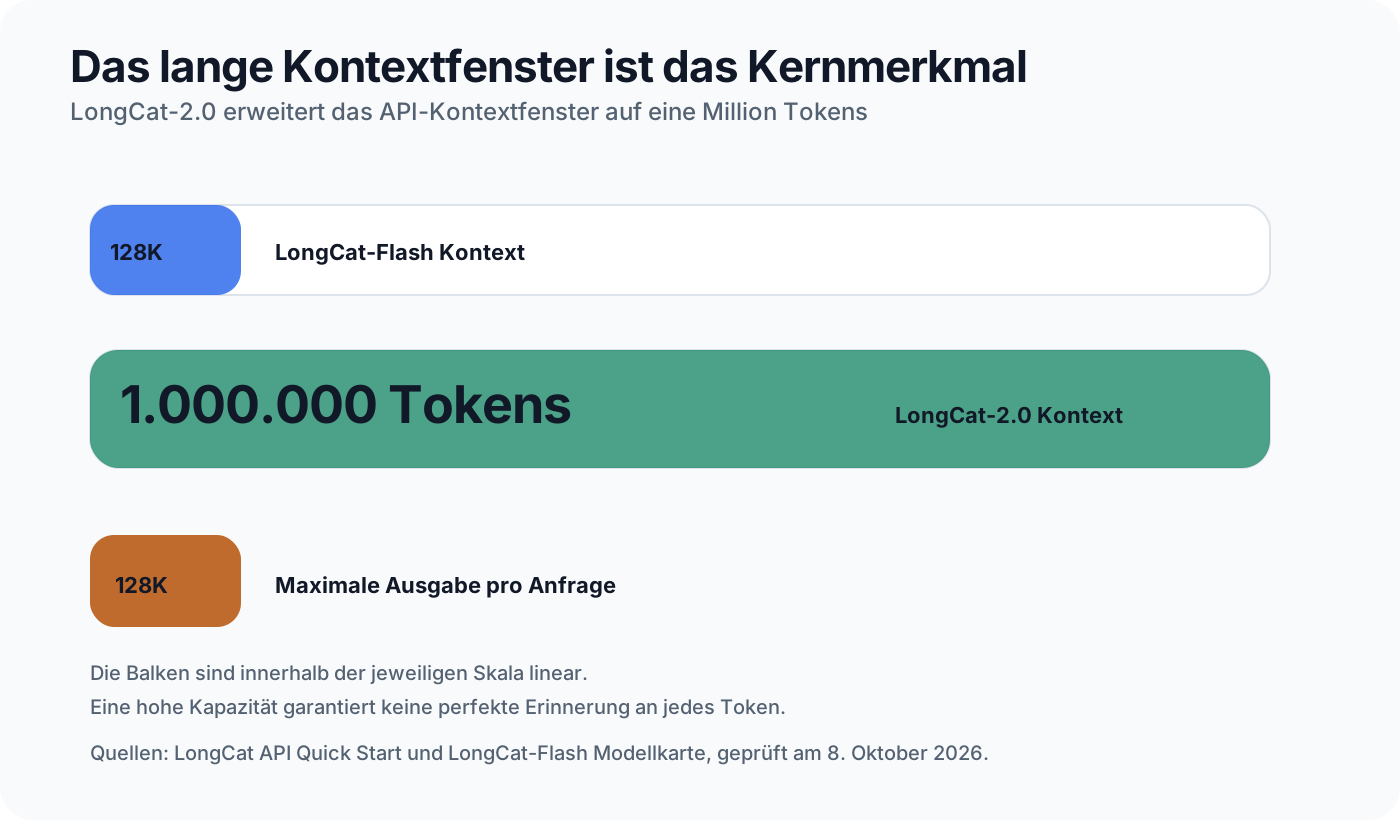
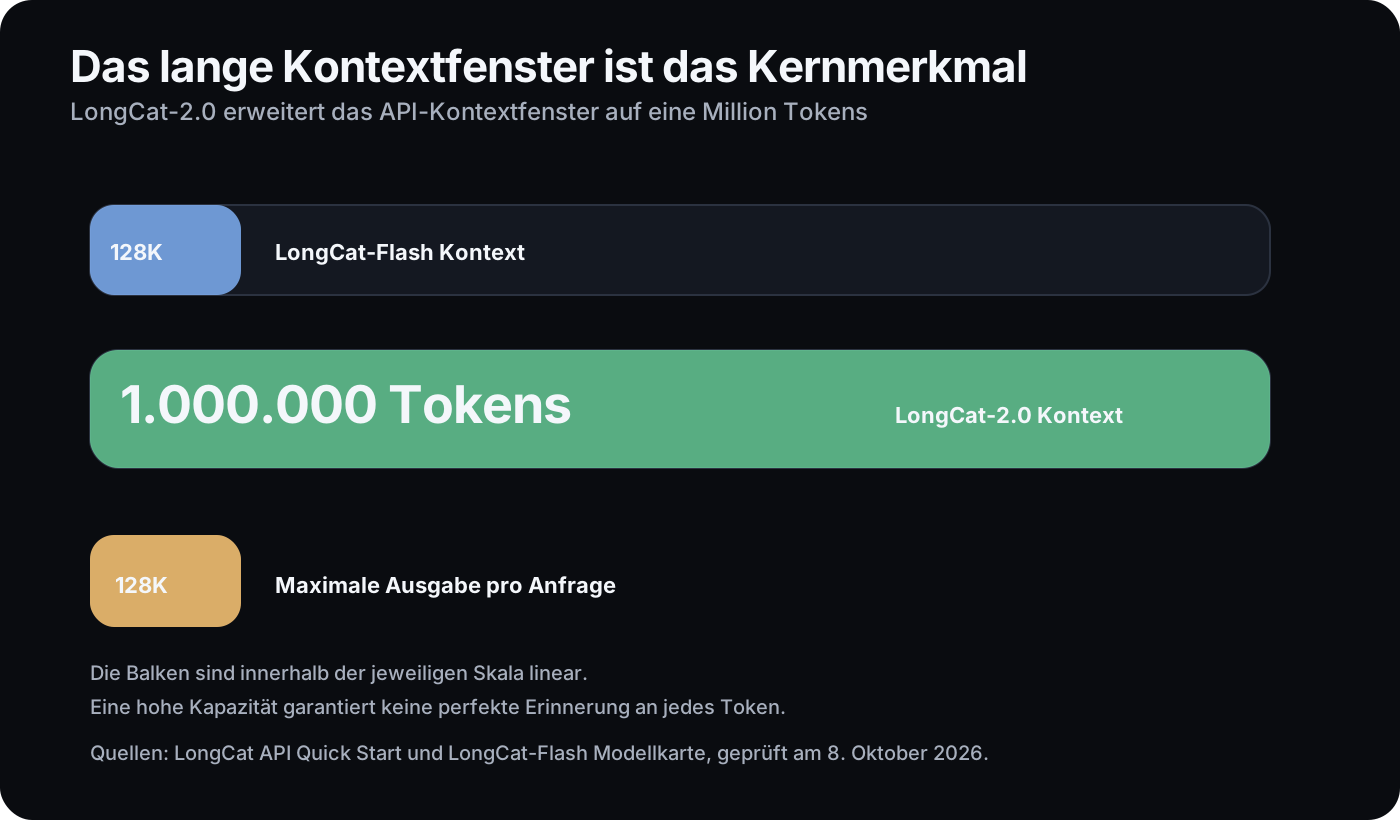
Ein großes Kontextfenster ist nicht gleichbedeutend mit perfekter Nutzung jedes Tokens. Entscheidend sind auch Retrieval-Qualität, Positionsrobustheit, Ablenkung durch irrelevante Inhalte, Prompt-Struktur, Latenz und Kosten. Für produktive Systeme bleibt es sinnvoll, große Datenmengen zu segmentieren, relevante Teile vorzuselektieren und Resultate zu überprüfen.
Wie viel Text ist eine Million Tokens?
Eine exakte Umrechnung in Wörter oder Seiten ist nicht möglich, weil Tokenisierung von Sprache, Code, Sonderzeichen und Formatierung abhängt. Als grobe Größenordnung kann eine Million englische Tokens mehreren hunderttausend Wörtern entsprechen. Quellcode kann aufgrund kurzer Bezeichner, Satzzeichen und Einrückung deutlich anders tokenisiert werden.
Für Agenten zählt neben der Eingabemenge auch der Verlauf der Sitzung: Tool-Ausgaben, Terminal-Logs, Patches und interne Zwischenstände sammeln sich an. Ein großes Fenster reduziert den unmittelbaren Zwang zur Komprimierung, ersetzt aber keine gute Kontextverwaltung.
Training auf AI-ASIC-Superpods
Meituan gibt an, dass sowohl das vollständige Training als auch die großskalige Bereitstellung auf AI-ASIC-Superpods durchgeführt wurden. Das Pretraining habe mehr als 35 Billionen Tokens und Millionen Beschleunigertage umfasst. Zudem meldet Meituan keine Rollbacks oder nicht wiederherstellbaren Loss-Spikes während des Trainings.1
Meituan stellt LongCat-2.0 als Beispiel für Frontier-Training auf einer alternativen Beschleunigerplattform dar. Die Modellkarte nennt allerdings keine vollständige Hardwarestückliste, keine unabhängig überprüfte Energieaufnahme und keine detaillierte Gesamtkostenrechnung. Aussagen zur Effizienz sollten daher auf die veröffentlichten Fakten begrenzt bleiben.
LongCat-2.0 Benchmarks
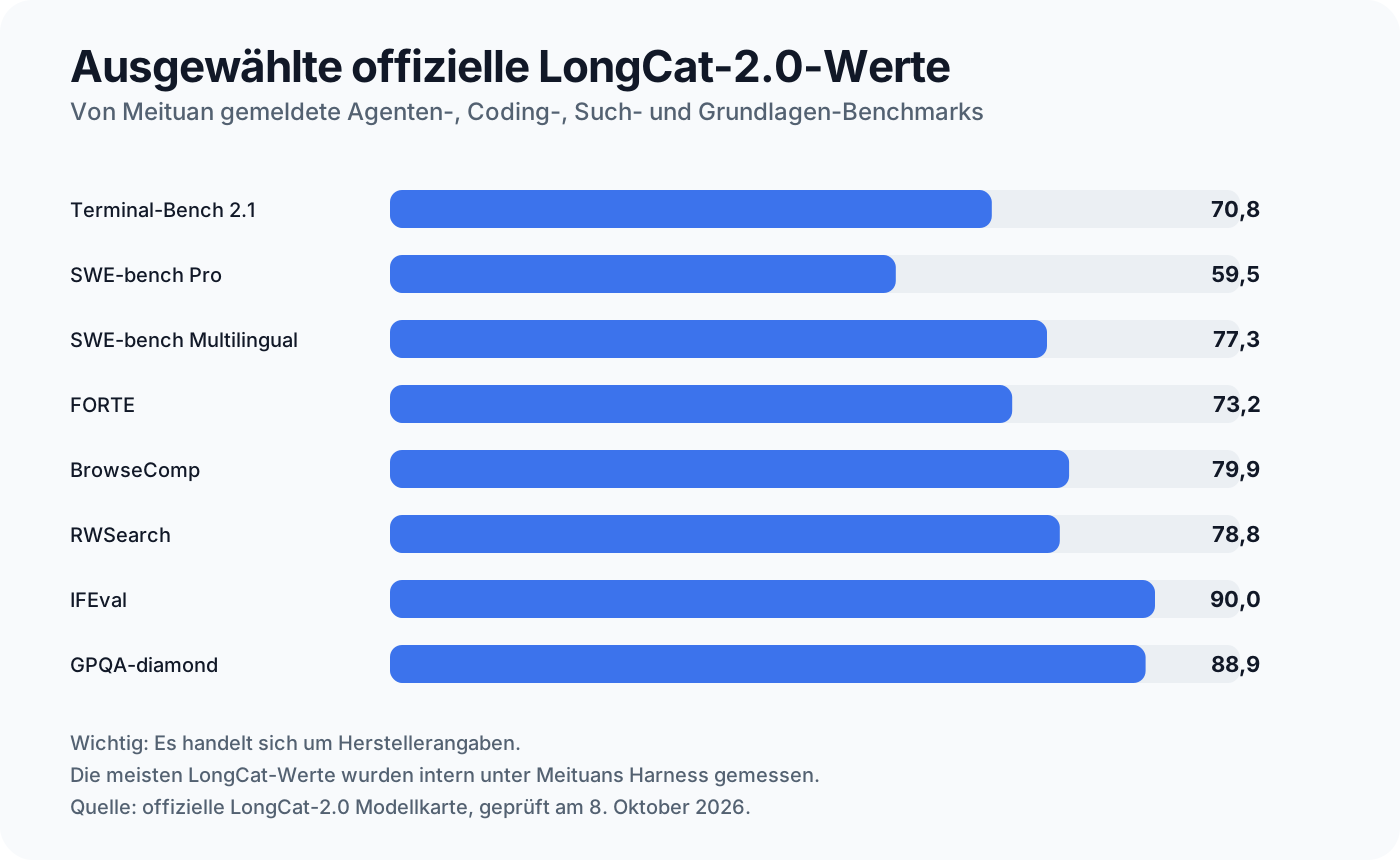
Meituan veröffentlicht Ergebnisse für Coding-Agenten, allgemeine Agenten, Suche, Instruction Following, Schreiben, Mathematik und wissenschaftliches Schlussfolgern. Die wichtigsten gemeldeten LongCat-2.0-Werte sind:
| Benchmark | LongCat-2.0 |
|---|---|
| Terminal-Bench 2.1 | 70,8 |
| SWE-bench Pro | 59,5 |
| SWE-bench Multilingual | 77,3 |
| FORTE | 73,2 |
| BrowseComp | 79,9 |
| RWSearch | 78,8 |
| IFEval | 90,0 |
| WritingBench | 83,8 |
| IMO-AnswerBench | 81,8 |
| GPQA Diamond | 88,9 |
Wie gut sind diese Werte einzuordnen?
Die Ergebnisse unterscheiden sich je nach Benchmark:
- Bei SWE-bench Pro meldet LongCat-2.0 59,5 Punkte und liegt in Meituans Tabelle über den dort aufgeführten Werten von Gemini 3.1 Pro, GPT-5.5 und Claude Opus 4.6, aber unter Claude Opus 4.7 und 4.8.
- Bei SWE-bench Multilingual liegt LongCat-2.0 mit 77,3 nahe an Claude Opus 4.6 und oberhalb des aufgeführten Gemini-Werts, aber unter Opus 4.7 und 4.8.
- Bei Terminal-Bench 2.1 ist LongCat-2.0 mit 70,8 etwa auf dem Niveau des angegebenen Gemini-Werts, aber hinter GPT-5.5 und Opus 4.8.
- IFEval 90,0 liegt in der Tabelle unter Gemini 3.1 Pro, GPT-5.5 und Claude Opus 4.6.
- GPQA Diamond 88,9 bleibt unter mehreren Vergleichsmodellen.
Diese Vergleiche sind nicht vollständig unabhängig. Meituan weist darauf hin, dass nicht mit Stern markierte Werte intern unter einem eigenen, einheitlichen Harness erhoben wurden, während Sternwerte aus offiziellen Berichten der jeweiligen Anbieter stammen. Unterschiedliche Agentengerüste, Toolsets, Budgets, Sampling-Einstellungen und Bewertungszeitpunkte können Ergebnisse beeinflussen.1 Die Tabelle ist daher ein Signal für Wettbewerbsfähigkeit, kein endgültiges Rangsystem.
Warum Agenten-Benchmarks schwer vergleichbar sind
Bei klassischen Wissensfragen ist der Bewertungsablauf relativ überschaubar. Agenten-Benchmarks hängen stärker von der gesamten Laufzeitumgebung ab:
- Welche Tools stehen zur Verfügung?
- Wie viele Schritte oder Tokens darf das Modell verwenden?
- Darf es Fehler korrigieren und Tests wiederholen?
- Welche Container-, Netzwerk- oder Dateirechte besitzt der Agent?
- Wird mit einem einzelnen Sample oder mehreren Versuchen bewertet?
- Welche Version des Benchmarks und des Agenten-Harnesses wurde genutzt?
Deshalb sollte ein Team LongCat-2.0 zusätzlich auf eigenen Repositories, Tickets und Automatisierungen testen.
LongCat-2.0 API: OpenAI- und Anthropic-kompatibel
Die LongCat API Platform bietet zwei Schnittstellen:
- OpenAI-kompatible Chat Completions
- Anthropic-kompatible Messages API
Dadurch lässt sich LongCat-2.0 in viele vorhandene Programme integrieren, ohne das komplette Anwendungskonzept neu zu schreiben.2
Python-Beispiel mit dem OpenAI-SDK
import os
from openai import OpenAI

api_key = os.environ.get("LONGCAT_API_KEY")
if not api_key:
    raise RuntimeError("Setze zuerst LONGCAT_API_KEY.")

client = OpenAI(
    api_key=api_key,
    base_url="https://api.longcat.chat/openai",
)

response = client.chat.completions.create(
    model="LongCat-2.0",
    messages=[
        {
            "role": "system",
            "content": (
                "Du bist ein sorgfältiger Coding-Assistent. "
                "Prüfe Annahmen und nenne alle geänderten Dateien."
            ),
        },
        {
            "role": "user",
            "content": (
                "Analysiere dieses Repository und plane eine sichere "
                "Migration auf Python 3.14."
            ),
        },
    ],
    max_tokens=4000,
)

print(response.choices[0].message.content)
Der API-Schlüssel sollte ausschließlich über eine Umgebungsvariable oder einen Secret Manager eingebunden werden. Er gehört nicht in ein Repository oder in clientseitigen JavaScript-Code.
Robuste Requests für lange Agentenläufe
Bei langen Ausgaben empfiehlt die API-Dokumentation Streaming. Anwendungen sollten außerdem sinnvolle Timeouts, exponentielles Backoff bei HTTP 429 und eine Protokollierung von Tokenverbrauch, Laufzeit und Fehlerquote implementieren.7
Ein produktiver Agent sollte zusätzlich:
- vor Änderungen einen Plan erzeugen,
- Dateien gezielt statt pauschal laden,
- Änderungen in kleinen Schritten durchführen,
- Tests nach jedem logischen Abschnitt ausführen,
- Patches und Tool-Ergebnisse validieren,
- bei Unsicherheit stoppen oder menschliche Freigabe verlangen.
Claude Code mit LongCat-2.0
Meituan dokumentiert eine direkte Konfiguration über die Anthropic-kompatible Basis-URL. In ~/.claude/settings.json können unter anderem ANTHROPIC_AUTH_TOKEN, ANTHROPIC_BASE_URL und die LongCat-Modellnamen gesetzt werden.8
Das macht LongCat-2.0 technisch zu einer Alternative innerhalb des Claude-Code-Harness. Die Modellantworten stammen dann von LongCat, nicht von einem Claude-Modell. Kompatibilität mit dem API-Format garantiert außerdem nicht, dass alle proprietären Modellverhaltensweisen identisch sind.
LongCat-2.0 API-Preise: Liste, Rabatt und reale Cache-Kosten
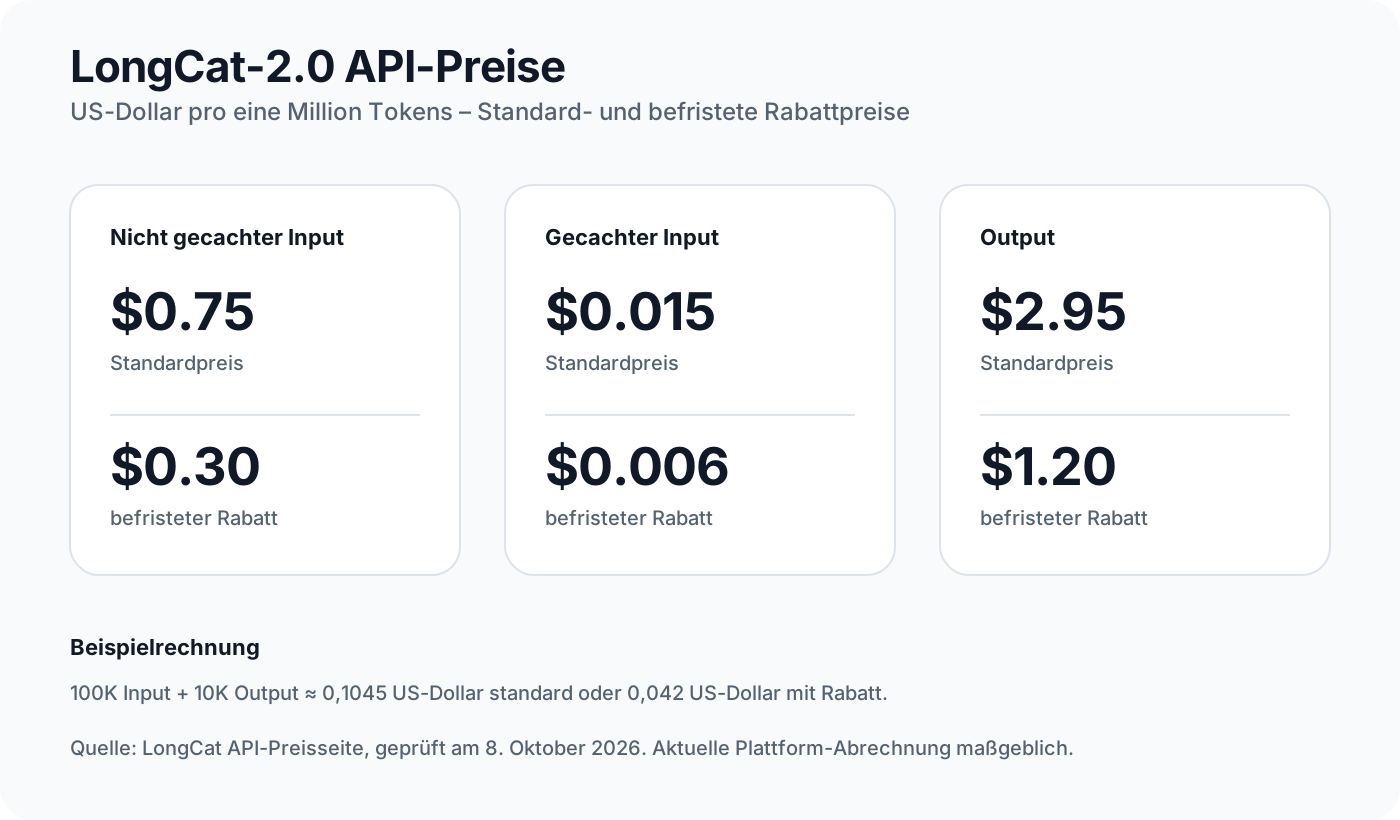
Die offizielle 2.0-Preisliste zeigt am 8. Oktober 2026 weiterhin zwei Spalten: normale API-Sätze und befristete Rabattpreise, jeweils USD pro 1 Million Tokens. Das sind keine EUR-Endpreise inklusive deutscher Umsatzsteuer. Meituan erklärt ausdrücklich, dass die Werte in der eigenen API-Konsole und auf der tatsächlichen Rechnung maßgeblich sind.4
| API-Tokentyp | Standard-Listenpreis | Befristeter Rabattpreis |
|---|---|---|
| Uncached Input | 0,75 USD | 0,30 USD |
| Cached Input | 0,015 USD | 0,006 USD |
| Output | 2,95 USD | 1,20 USD |
Kostenbeispiele ohne doppelte Cache-Abrechnung
Fall A: 100.000 nicht gecachte Input-Tokens und 10.000 Output-Tokens kosten 0,1045 USD Standard oder 0,042 USD zum angegebenen Rabatt.
Fall B – Agentensitzung: 50 Mio. Input-Tokens, davon bereits enthalten 40 Mio. Cache-Hits, plus 5 Mio. Output-Tokens:
| Berechnung | Standard | Rabatt |
|---|---|---|
| 10 Mio. uncached Input | 7,50 USD | 3,00 USD |
| 40 Mio. cached Input | 0,60 USD | 0,24 USD |
| 5 Mio. Output | 14,75 USD | 6,00 USD |
| Gesamt | 22,85 USD | 9,24 USD |
Formel: (Input gesamt − Cache-Hits) × Uncached-Tarif + Cache-Hits × Cached-Tarif + Output × Output-Tarif. Ein Cache-Treffer ist nicht garantiert: Nur tatsächlich als cached verbuchte Tokens dürfen zum Cache-Tarif gerechnet werden.
Meituan bietet separat 30 Tage gültige Token Packs. Für verifizierte internationale Unternehmenskonten listet die FAQ darüber hinaus verbrauchsabhängige Pay-as-you-go-Staffelrabatte bis 40 %, ab 75 / 300 / 1.200 / 6.000 USD monatlichem Verbrauch. Diese Konditionen sind nicht automatisch zusätzlich mit Aktionspreisen kombinierbar und keine Standardkonditionen für Privatkonten.7
Kostenfalle: Das maximale Kontextfenster vollschreiben
Ein Kontextfenster von 1 Mio. Tokens bedeutet keine Pflicht, es auszunutzen. Lange Historys erhöhen Netzwerk- und Prefill-Zeit, Cache-Miss-Risiko und Agentenwiederholungen. Das offiziell dokumentierte Limit von 128.000 Output-Tokens ist eine Obergrenze, keine garantierte Antwortlänge. Der Quickstart empfiehlt bei HTTP 429 exponentiellen Backoff mit retry_after; context_length_exceeded verlangt einen kürzeren Request.27
Kann LongCat-2.0 lokal auf einem Mac laufen?
Für einen gewöhnlichen Mac lautet die praktische Antwort: nicht als vollständiges Modell.
Die offizielle Angabe von 1,6 Billionen Parametern ergibt bereits theoretisch folgende reine Gewichtsmengen:
| Format | Theoretische Mindestgröße der Gewichte |
|---|---|
| BF16 / FP16 | ca. 3,2 TB |
| 8 Bit | ca. 1,6 TB |
| 4 Bit | ca. 800 GB |
Dazu kommen Quantisierungsmetadaten, Laufzeitpuffer, KV-Cache, Routing, temporäre Aktivierungen und Framework-Overhead. Die rund 48 Milliarden aktiven Parameter reduzieren die Berechnung pro Token, nicht automatisch den benötigten Speicher für sämtliche Experten.
Selbst ein Mac Studio mit sehr großem Unified Memory reicht daher nicht für eine komfortable vollständige lokale Bereitstellung. Starke Offloading-Lösungen könnten theoretische Experimente ermöglichen, wären aber langsam und weit entfernt von der vorgesehenen Superpod-Infrastruktur. Für Mac-Nutzer ist die LongCat-API der realistische Zugangsweg.
Die Modellkarte nennt GPU- und NPU-Bereitstellung über SGLang beziehungsweise SGLang-FluentLLM. Hugging Face zeigt zudem Hinweise für vLLM, SGLang und verfügbare Quantisierungen. Das bedeutet nicht, dass ein durchschnittlicher Rechner die vollständigen Gewichte sinnvoll hosten kann.1
Warum „48B aktiv“ nicht heißt: „passt wie ein 48B-Modell“
Bei jeder einzelnen Tokenberechnung wird nur ein Teil der Experten verwendet. Der Router kann für das nächste Token jedoch andere Experten auswählen. Damit die Auswahl flexibel bleibt, muss das System Zugriff auf den gesamten Expertenbestand haben. Ein lokaler Rechner kann die ungenutzten Gewichte nicht einfach dauerhaft löschen.
Stärken von LongCat-2.0
1. Sehr großes Langkontextfenster
Eine Million Tokens ermöglichen Aufgaben, bei denen klassische 32K- oder 128K-Fenster schnell an Grenzen stoßen. Für große Repositories und lange Agentenverläufe ist das ein relevantes Produktmerkmal.
2. Fokus auf echte Agenten-Harnesses
Meituan nennt nicht nur abstraktes Tool Calling, sondern konkrete Integrationen mit Claude Code, Hermes, OpenClaw, OpenCode und Kilo Code. Dadurch lässt sich das Modell in existierenden Workflows testen.
3. Offene Gewichte unter MIT-Lizenz
Die Modellgewichte werden laut Modellkarte unter der MIT-Lizenz veröffentlicht. Das ist deutlich freier als viele Community-Lizenzen mit Nutzungs- oder Umsatzgrenzen. Marken- und Patentrechte von Meituan werden dadurch allerdings nicht automatisch eingeräumt.1
4. Flexible API-Kompatibilität
OpenAI- und Anthropic-kompatible Endpunkte verringern den Integrationsaufwand. Anwendungen können oft durch Austausch von Basis-URL, Schlüssel und Modellnamen angepasst werden.
5. Veröffentlichte API-Preise
Der veröffentlichte Preis für gecachten Input liegt deutlich unter dem Preis für nicht gecachten Input. Das kann LongCat-2.0 für lange, wiederverwendete Kontexte relevant machen, sofern Latenz, Zuverlässigkeit und Qualität zum jeweiligen Workflow passen.
Grenzen und offene Fragen
Unabhängige Evaluationen fehlen noch
LongCat-2.0 ist neu. Viele öffentlich diskutierte Ergebnisse stammen direkt von Meituan. Externe Reproduktionen auf identischen Agentenbudgets und Harness-Versionen sind für eine belastbare Marktpositionierung entscheidend.
1M Kontext ist nicht gleich 1M zuverlässige Erinnerung
Maximale Eingabelänge, effektive Informationswiedergewinnung und stabile Schlussfolgerung über den gesamten Kontext sind unterschiedliche Eigenschaften. Praktische Needle-in-a-Haystack-, Multi-Hop- und Repository-Tests bleiben wichtig.
Selbsthosting erfordert massive Infrastruktur
Die MIT-Lizenz macht die Gewichte zugänglich; sie reduziert nicht deren Speicherbedarf. Für die meisten Entwickler ist API-Nutzung realistischer als lokales Hosting.
Sprach- und Sicherheitsleistung kann variieren
Meituan weist selbst darauf hin, dass Leistung zwischen Sprachen und Anwendungen schwanken kann. Vor Einsätzen in Medizin, Recht, Finanzen, Personalentscheidungen oder kritischer Infrastruktur sind eigene Tests und menschliche Kontrolle erforderlich.1
Daten- und Betriebsfragen
Wer die gehostete API verwendet, sollte Datenschutzbestimmungen, Datenstandorte, Logging, Aufbewahrung, Vertragsbedingungen und Compliance-Anforderungen prüfen. API-Kompatibilität allein beantwortet diese Fragen nicht.
LongCat-2.0 vs. LongCat-Flash
| Merkmal | LongCat-Flash | LongCat-2.0 |
|---|---|---|
| Gesamtparameter | 560B | 1,6T |
| Aktivierte Parameter | 18,6B–31,3B, Ø ca. 27B | ca. 48B |
| Kontext | bis 128K in der Flash-Generation | bis 1M |
| Hauptfokus | effiziente allgemeine und agentische Nutzung | lange Agentenaufgaben, Coding und Repository-Arbeit |
| Aufmerksamkeit | frühere LongCat-Architektur | LongCat Sparse Attention |
| N-Gram-Embedding | bei Flash-Lite eingeführt | 135B Parameter |
| Lizenz | MIT bei veröffentlichten Modellen | MIT |
LongCat-2.0 vergrößert die Gesamt- und die aktive Kapazität und baut den Kontextpfad neu aus. Dadurch steigt auch der Infrastrukturbedarf.
Für wen passt LongCat-2.0?
LongCat-2.0 passt zu folgenden Szenarien:
- Entwickler, die lange Coding-Agenten testen
- Teams mit sehr großen Repositories
- Anbieter von Agentenplattformen und Tool-Harnesses
- Forschung zu Sparse Attention und MoE-Skalierung
- Unternehmen, die OpenAI- oder Anthropic-kompatible APIs austauschbar halten
- Nutzer von Hermes oder OpenClaw, die eine neue Modelloption evaluieren
- Entwickler, die offene Gewichte benötigen, aber Inferenz auf Serverinfrastruktur auslagern können
Weniger geeignet ist das Modell für Anwender, die ein schnelles lokales LLM auf einem MacBook, Mac mini oder normalen Desktop suchen. Dafür sind kleinere dichte Modelle oder kompakte MoE-Modelle erheblich realistischer.
Fazit: Große offene Gewichte, für Macs praktisch die API
LongCat-2.0 kombiniert 1,6 Billionen Gesamtparameter, rund 48 Milliarden aktive Parameter, eine Million Kontexttokens, eine offene MIT-Lizenz und eine direkte Ausrichtung auf Coding-Agenten. LongCat Sparse Attention, N-Gram-Embeddings und Multi-Token Prediction erweitern den Langkontext- und Inferenzpfad über eine reine Vergrößerung des Modells hinaus.
Die Benchmarks sind größtenteils Herstellerergebnisse, nicht unabhängig replizierte Praxiswerte. Für die meisten Macs ist LongCat-2.0 ein Cloud-API-Modell trotz offener MIT-Gewichte. Seit September 2026 existiert außerdem die separate LongCat-2.5-Preview mit Bildverständnis; sie ist ein Anlass für einen eigenen Test, nicht rückwirkend dasselbe Modell. Entscheidend für die Wahl bleiben Tool-Zuverlässigkeit, Latenz, tatsächliche Cache-Hits, Kosten und Sicherheit auf eigenen Aufgaben.
Wie viel Unified Memory ein so großes Modell real braucht, erklärt der RAM-Guide; realistische offene Alternativen listet das Open-Weight-Roundup.
Quellen
Weitere offizielle Links: GitHub Repository · Technischer Blog
Footnotes
Häufig gestellte Fragen
Steht LongCat-2.0 unter einer Open-Source-Lizenz?
Die Modellgewichte und Repository-Beiträge stehen laut offizieller Modellkarte unter der MIT-Lizenz. Präziser ist häufig der Begriff Open Weight, da nicht automatisch alle Trainingsdaten, Datenpipelines und internen Trainingssysteme vollständig veröffentlicht sind.
Wie viele Parameter hat LongCat-2.0?
Meituan nennt 1,6 Billionen Gesamtparameter und ungefähr 48 Milliarden aktivierte Parameter pro Token.
Wie groß ist das Kontextfenster?
Die LongCat API dokumentiert bis zu 1.000.000 Kontexttokens und maximal 128.000 Ausgabetokens.
Kann LongCat-2.0 auf einem Mac laufen?
Nicht sinnvoll als vollständiges Modell auf gewöhnlicher Mac-Hardware. Bereits vierbitquantisierte Gewichte würden theoretisch ungefähr 800 GB benötigen, bevor zusätzlicher Laufzeitbedarf berücksichtigt wird.
Unterstützt LongCat-2.0 Tool Calling?
Ja. Meituan beschreibt native Tool Calls, mehrstufiges Reasoning und Integrationen mit Claude Code, Hermes, OpenClaw, OpenCode und weiteren Agentenwerkzeugen.
Wie teuer ist die LongCat-2.0 API?
Am 8. Oktober 2026 nennt Meituan 0,75 / 0,015 / 2,95 USD je Million Tokens als regulären Uncached-/Cache-/Output-Tarif. Der befristete Rabatt lautet 0,30 / 0,006 / 1,20 USD. Ob der Rabatt noch gilt, entscheidet die aktuelle Plattformabrechnung.
Was ist der Unterschied zu LongCat-2.5-Preview?
LongCat-2.5-Preview ist seit 25. September 2026 als separate API-Modell-ID mit Bildverständnis verfügbar. LongCat-2.0 bleibt gelistet; seine veröffentlichten MIT-Gewichte sind nicht automatisch die Gewichte der 2.5-Preview.
Welche API-Formate werden unterstützt?
Die Plattform bietet OpenAI-kompatible Chat Completions und eine Anthropic-kompatible Messages API.