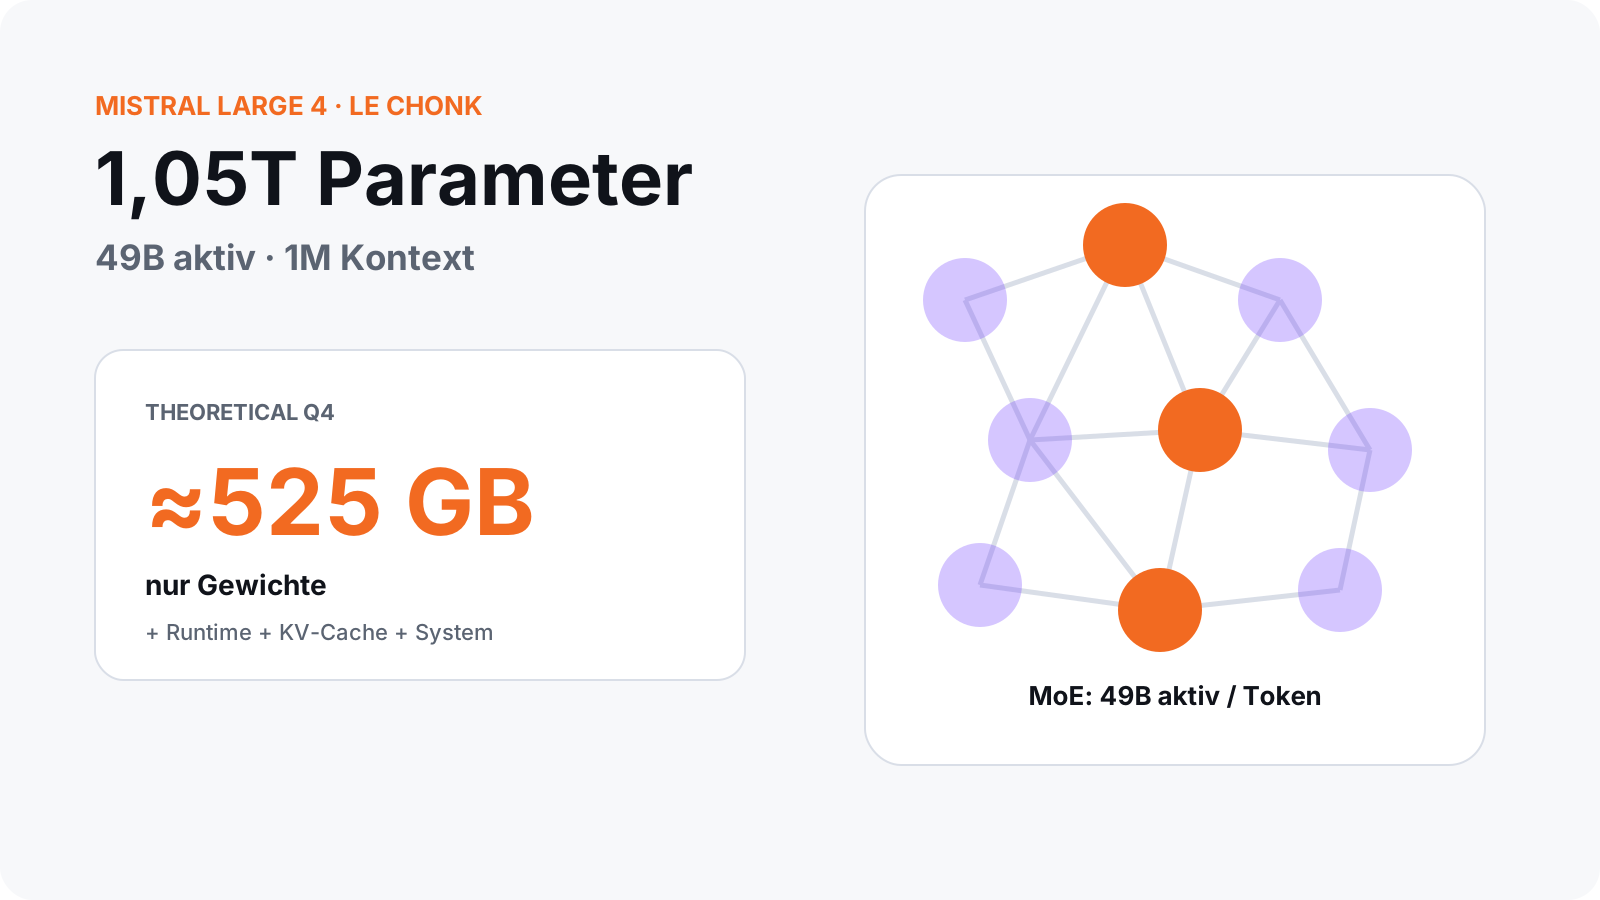
Geprüft am 6. Oktober 2026. Mistral AI hat Mistral Large 4 als Public Preview veröffentlicht. Die offizielle Modellkarte nennt 1,05 Billionen Gesamtparameter, 49 Milliarden aktive Parameter pro Token, einen 1,6-Milliarden-Parameter-Vision-Encoder und auf Mistrals eigenem Modellprofil ein Kontextfenster von 1 Million Tokens.[S01] Der auffälligste Punkt für lokale Nutzer ist aber ein anderer: 49B aktive Parameter machen das Modell nicht zu einem 49B-Download. Rein mathematisch benötigen 1,05T Parameter selbst bei 4 Bit ungefähr 525 GB nur für die Gewichte – noch ohne Runtime, Quantisierungsmetadaten, KV-Cache oder macOS.
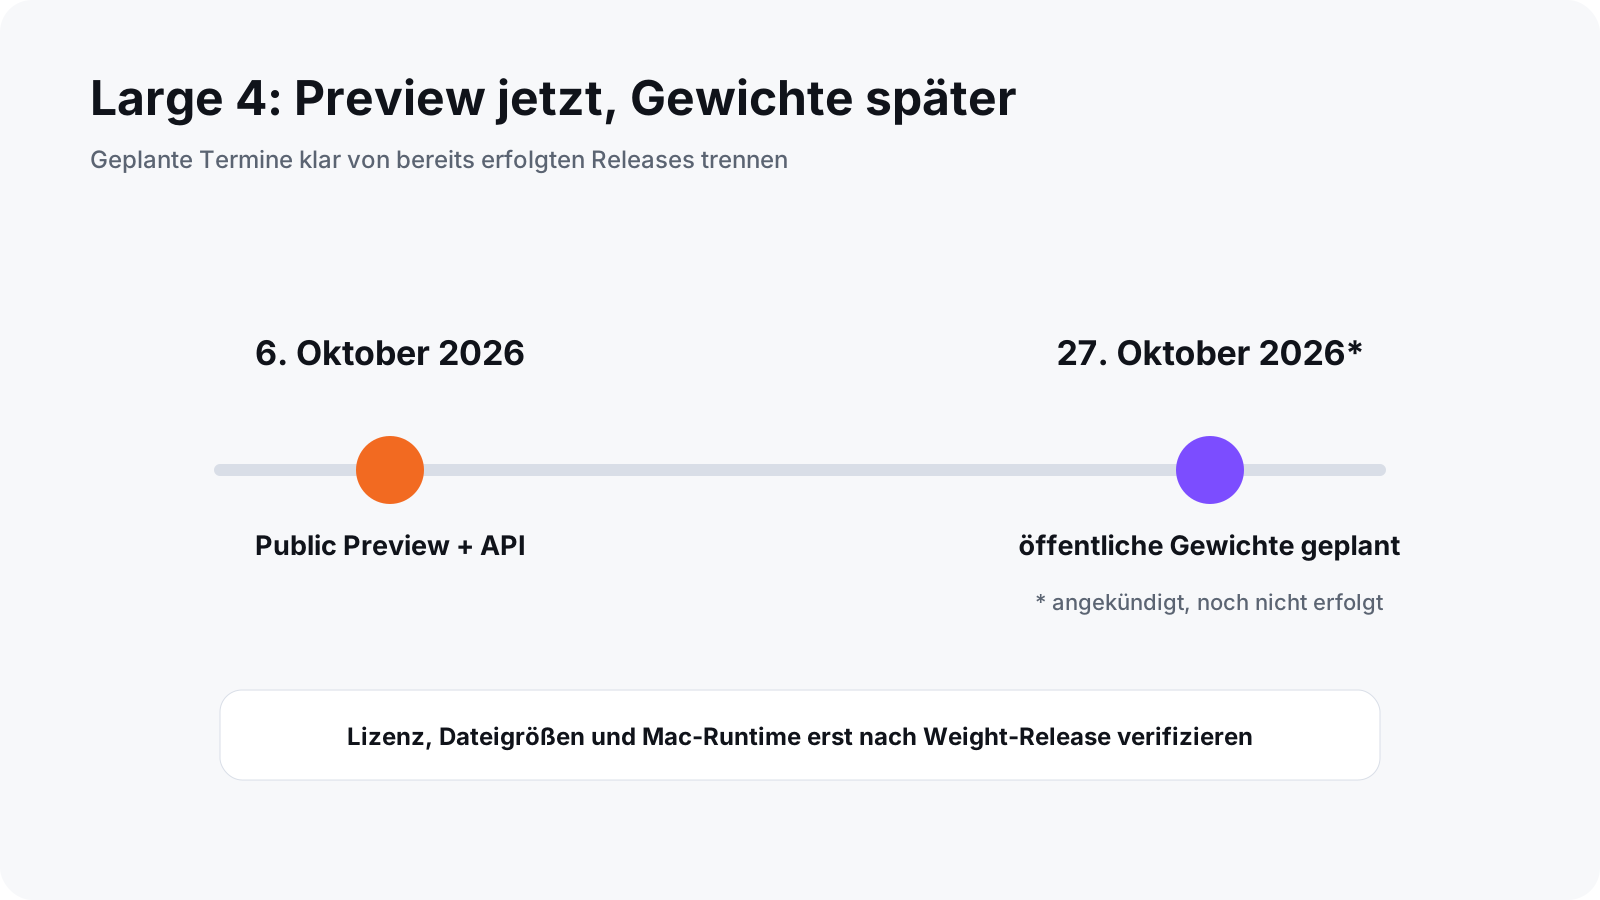
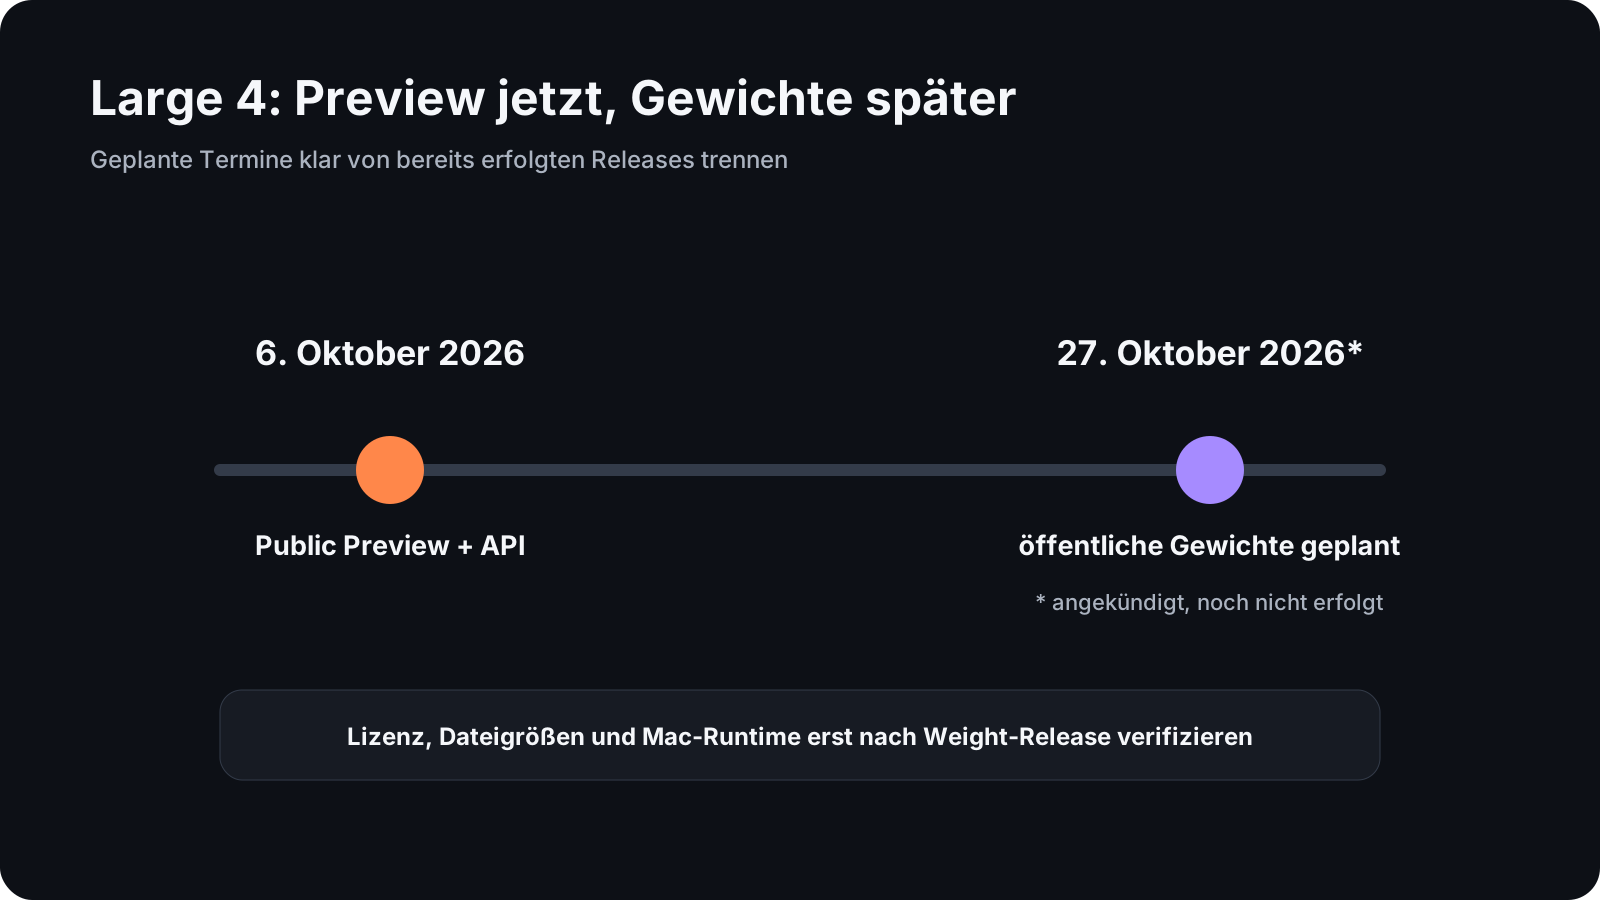
Large 4 ist am 6. Oktober bereits als API-Preview nutzbar. Die öffentlichen Modellgewichte sind für 27. Oktober 2026 angekündigt.[S09][S10][S11] Für normale Macs ist das vollständige Modell wegen seiner Gesamtgröße nicht realistisch. Selbst eine theoretische 4-Bit-Darstellung liegt bei rund 525 GB Gewichtsdaten.
Mistral Large 4 auf einen Blick
| Merkmal | Stand 6. Oktober 2026 |
|---|---|
| Offizieller Name | Mistral Large 4 |
| Version | v26.10 |
| Status | Public Preview |
| Architektur | granulares Mixture-of-Experts-Modell, nativ multimodal |
| Gesamtparameter | 1,05T |
| aktive Parameter | 49B |
| Vision-Encoder | 1,6B |
| Mistral-Kontext | 1M Tokens |
| OpenRouter-Kontext | 524.288 Tokens |
| aktueller Mistral-Endpunkt: Input | $0,68 / 1 Mio. Tokens |
| Cached Input | $0,07 / 1 Mio. Tokens |
| Output | $2,09 / 1 Mio. Tokens |
| öffentliche Gewichte | für 27. Oktober angekündigt |
| endgültige Weight-Lizenz | am 6. Oktober noch nicht belastbar bestätigt |
Die technische Basis der Tabelle stammt primär aus Mistrals aktueller Modellkarte.[S01] OpenRouter führt dasselbe Modell unter mistralai/mistral-large-4-0, setzt dort aber ein Provider-Limit von 524.288 Kontexttokens und bis zu 256K Output an.[S16] Das ist ein wichtiger Unterschied zwischen Modellfähigkeit und konkretem Deployment.
Was bedeutet 1,05T gesamt, aber nur 49B aktiv?
Large 4 ist ein Mixture-of-Experts-Modell (MoE). Ein Router aktiviert pro Token nur einen Teil des Netzes. Dadurch kann der Rechenaufwand pro Token deutlich näher an einem wesentlich kleineren Modell liegen, obwohl der komplette Parameterbestand sehr viel größer ist.
Für lokale Inferenz werden zwei Größen deshalb leicht verwechselt:
- aktive Parameter beeinflussen vor allem den Rechenaufwand pro Token;
- Gesamtparameter bestimmen wesentlich mit, wie viele Gewichte gespeichert und für die Experten verfügbar gehalten werden müssen.
Mistral nennt 49B aktive und 1,05T Gesamtparameter.[S01] Für die Frage „Passt das auf meinen Mac?“ ist deshalb 1,05T die entscheidendere Zahl.
Wie viel RAM würde Mistral Large 4 lokal brauchen?
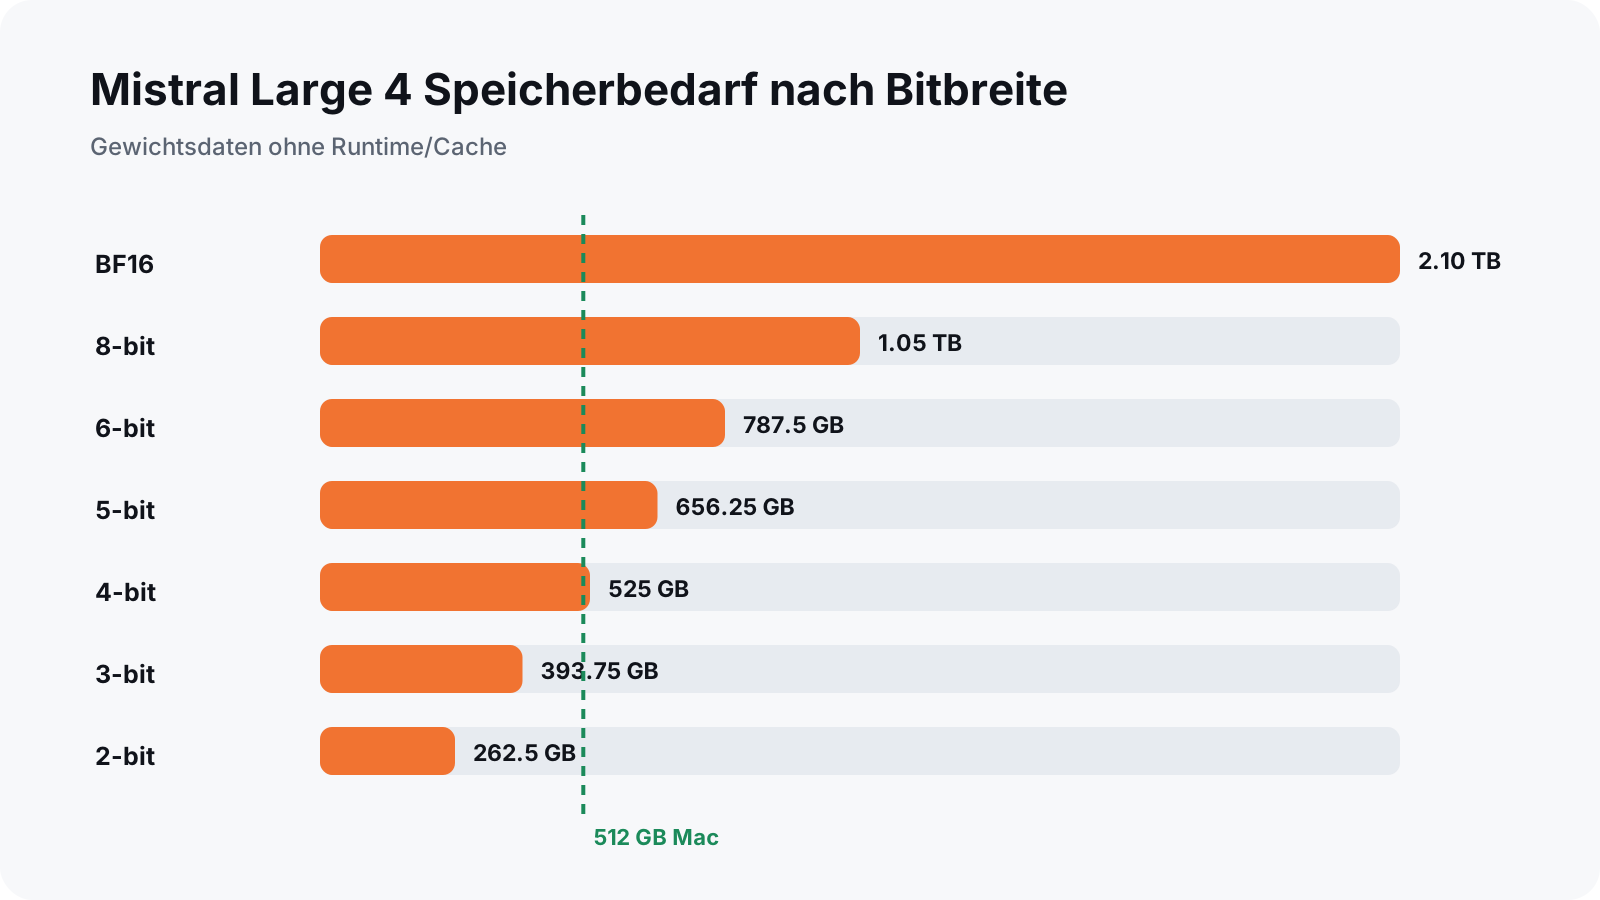
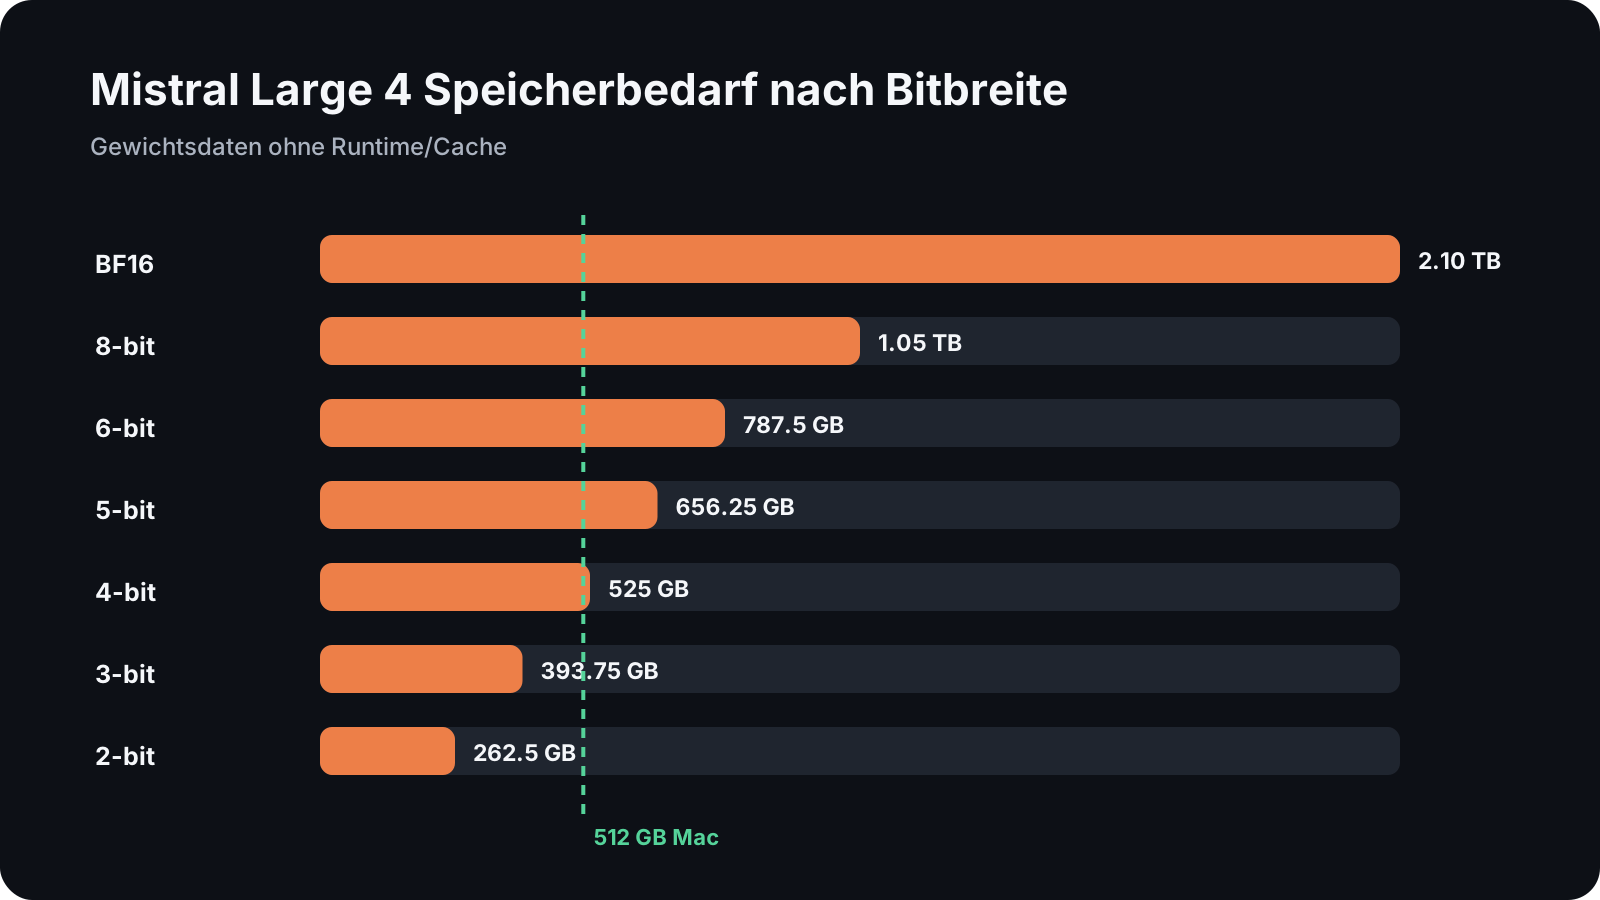
Die folgende Rechnung ist keine gemessene Large-4-Runtime, sondern eine transparente Gewichtsschätzung auf Basis der offiziellen 1,05T Parameter:[S01]
| Darstellung | Formel | reine Gewichtsdaten |
|---|---|---|
| BF16 | 1,05T × 2 Byte | 2,10 TB |
| 8 Bit | 1,05T × 1 Byte | 1,05 TB |
| 6 Bit | 1,05T × 0,75 Byte | 787,5 GB |
| 5 Bit | 1,05T × 0,625 Byte | 656,25 GB |
| 4 Bit | 1,05T × 0,5 Byte | 525 GB |
| 3 Bit | 1,05T × 0,375 Byte | 393,75 GB |
| 2 Bit | 1,05T × 0,25 Byte | 262,5 GB |
Das sind dezimale GB/TB und ausschließlich die nackten Parameterbits. Reale Quantisierungen enthalten zusätzliche Metadaten und Laufzeitstrukturen. Außerdem brauchen macOS, die Runtime, temporäre Tensoren und der KV-Cache eigenen Speicher.
Passt Large 4 auf einen 512-GB-Mac?
Eine gewöhnliche vollständige Q4-Variante wäre schon in der Theorie zu groß, weil 525 GB reine Gewichte oberhalb von 512 GB Unified Memory liegen. Selbst wenn eine Runtime extrem effizient wäre, bliebe kein Platz für das System und den Rest der Inferenz.
Eine aggressive 3-Bit-Quantisierung läge rechnerisch bei 393,75 GB und könnte damit auf dem Papier unter 512 GB liegen. Ob eine solche Quantisierung tatsächlich veröffentlicht wird, welche Qualitätsverluste sie bringt und ob MLX, llama.cpp oder eine andere Runtime das Large-4-MoE effizient unterstützt, ist am 6. Oktober nicht verifiziert. Die Gewichte selbst sollen erst am 27. Oktober öffentlich erscheinen.[S09][S10]
Praktische Konsequenz: Für 16, 24, 32, 64, 96, 128 oder 256 GB Unified Memory ist das vollständige Large 4 kein realistisches lokales Standardmodell. Bei 512 GB sollte man ebenfalls auf echte Checkpoint-Größen und Runtime-Overhead warten, statt allein aus „49B aktiv“ auf Lauffähigkeit zu schließen.
Für kleinere lokale Modelle kannst du stattdessen den bestehenden Unified-Memory-Guide und den RAM-Rechner verwenden.[S19][S20]
1M Kontext oder 512K? Beide Angaben können gleichzeitig stimmen
Mistrals aktuelle Modellkarte nennt für Large 4 1M Kontexttokens.[S01] Vercels Mistral-Provider zeigt ebenfalls 1M.[S17] OpenRouter beschreibt sein aktuelles Deployment dagegen mit 524.288 Tokens und maximal 256K Output.[S16] Vals dokumentiert für die evaluierte Konfiguration 512K Kontext.[S15]
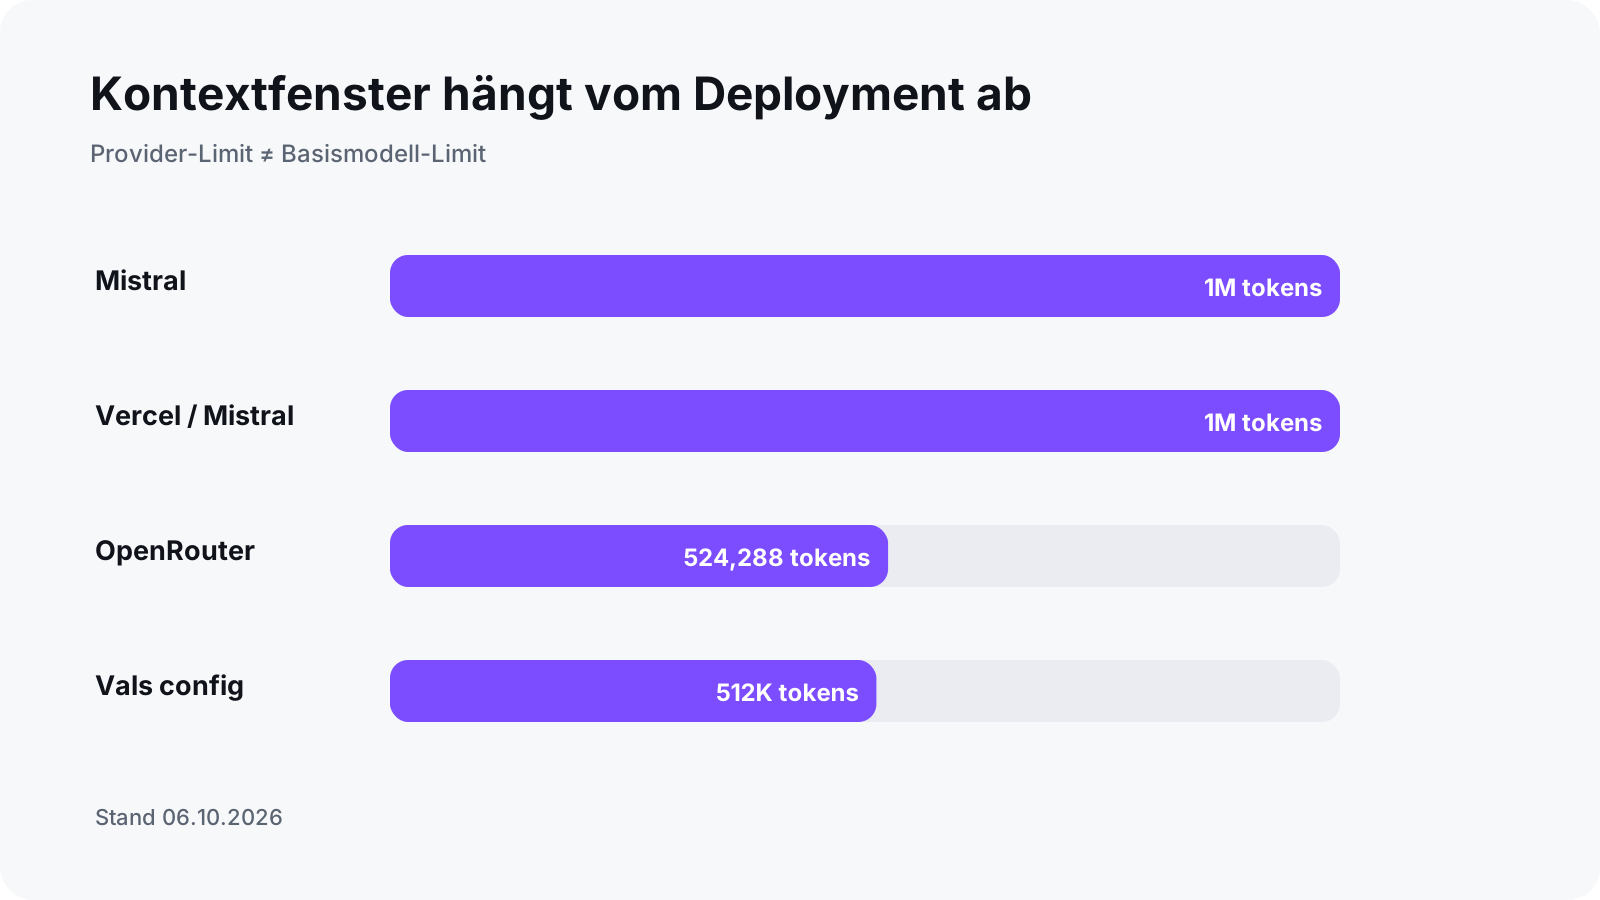
Das sollte im Artikel nicht als „Mistral sagt 1M, OpenRouter liegt falsch“ formuliert werden. Provider dürfen ein Basismodell mit engeren Limits anbieten. Für lange Agentenläufe oder große Repositories ist deshalb das Limit des konkreten Endpunkts entscheidend.
Was kostet die Mistral-Large-4-API?
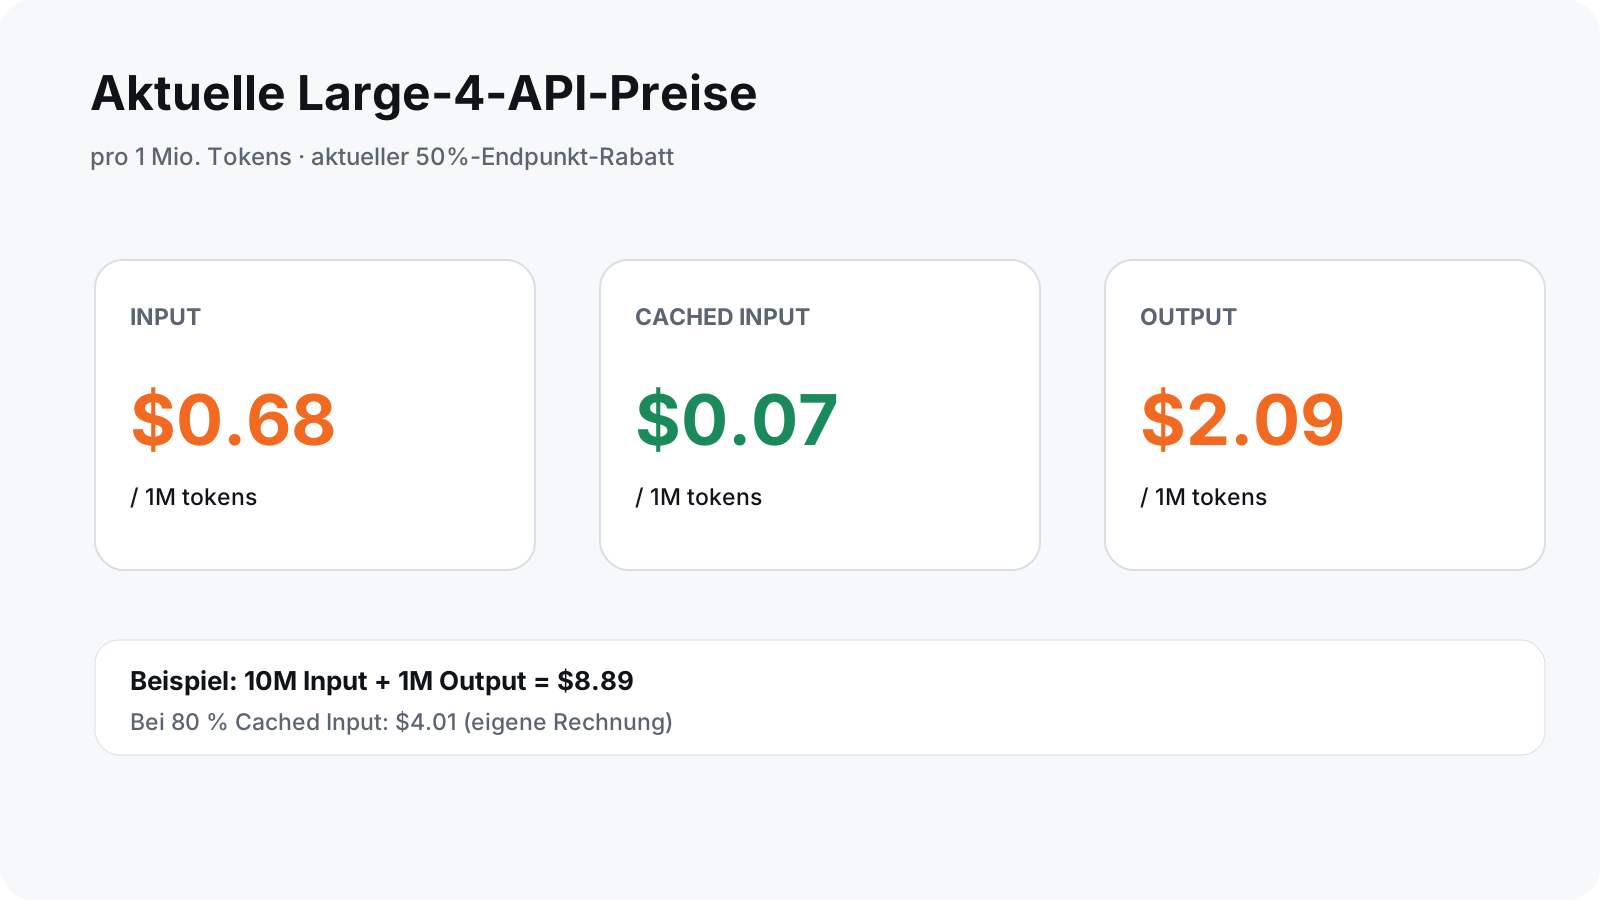
Die offizielle Modellkarte zeigt am 6. Oktober folgende aktuellen Werte:[S01]
- Input: $0,68 pro 1 Mio. Tokens
- Cached Input: $0,07 pro 1 Mio. Tokens
- Output: $2,09 pro 1 Mio. Tokens
OpenRouter markiert den Mistral-Endpunkt ausdrücklich als 50 % reduziert und zeigt daneben $1,36 / $0,14 / $4,18 als höhere Vergleichswerte.[S16] Diese Promotion ist zeitabhängig; für einen späteren Artikel-Refresh sollten die Preise neu geprüft werden.
Eigene Kostenrechnung
10 Mio. Input + 1 Mio. Output, ohne Cache:
10 × $0,68 + 1 × $2,09 = $8,89
Dasselbe Volumen bei 80 % Cached Input:
2 × $0,68 + 8 × $0,07 + $2,09 = $4,01
100 Mio. Input + 10 Mio. Output: $88,90 ohne Cache bzw. $40,10 bei derselben 80-%-Cache-Annahme.
Das sind eigene Beispielrechnungen, keine typische Monatsrechnung eines bestimmten Nutzers. Ob 80 % Cache-Hit-Rate erreichbar sind, hängt vom Workflow ab.
EU-Regionalinferenz
Mistral bietet getrennte EU- und US-Endpunkte. Regional Inference wird laut Dokumentation mit 1,1× der Standard-Listenpreise abgerechnet.[S03] Gleichzeitig sind dort nicht alle Funktionen des globalen Endpunkts verfügbar: Mistral nennt Function Calling als unterstütztes regionales Tool; stateful Features wie Agents, Batch und Files API sind dort aktuell eingeschränkt.[S03]
Für Datenschutz- und Compliance-Workflows ist diese Unterscheidung wichtiger als ein pauschales „Mistral läuft in Europa“.
Mistral Large 4 vs. Large 3
Large 3 wurde im Dezember 2025 mit 675B Gesamtparametern, 41B aktiven Parametern, 256K Kontext und Apache-2.0-Gewichten veröffentlicht.[S07][S08]
| Mistral Large 3 | Mistral Large 4 Preview | |
|---|---|---|
| Gesamtparameter | 675B | 1.050B |
| aktive Parameter | 41B | 49B |
| offizieller Kontext | 256K | 1M |
| Input-Preis | $0,50/M | $0,68/M aktuell |
| Output-Preis | $1,50/M | $2,09/M aktuell |
| Status | GA | Public Preview |
| Gewichte | veröffentlicht | für 27.10. angekündigt |
| Lizenz | Apache 2.0 | noch nicht bestätigt |
Large 4 hat damit rund 55,6 % mehr Gesamtparameter, aber nur etwa 19,5 % mehr aktive Parameter als Large 3. Genau dieser Unterschied erklärt, warum das Modell compute-seitig sparsamer wirkt als seine enorme Checkpoint-Größe vermuten lässt.
Wichtig: Large 3s Apache-2.0-Lizenz darf nicht automatisch auf Large 4 übertragen werden. Frandroid weist beim angekündigten Large-4-Weight-Release ausdrücklich darauf hin, dass die Lizenz noch nicht spezifiziert war.[S12]
Wie gut ist Mistral Large 4 wirklich?
Launch-Benchmarks und unabhängige Benchmarks müssen getrennt bleiben.
Mistral zeigt vorläufige Resultate unter anderem für DeepSWE v1.1, Finch/FinWorkBench, Harvey Legal Agent, Dense200 und DIOR-RSVG. Frandroid, The Next Web, Numerama und VentureBeat geben diese Herstellerwerte wieder.[S12][S13][S14][S18] VentureBeat weist allerdings darauf hin, dass nicht alle exakten Konkurrentenwerte in den öffentlichen Originalleaderboards nachvollzogen werden konnten.[S14]
Unabhängiger Check: Vals
Vals führt die Large-4-Preview am 6. Oktober mit 48,05 % ±1,11 im Vals Index auf Rang 32 von 44 getesteten Konfigurationen.[S15] Einzelwerte zeigen ein gemischtes Profil:
| Benchmark | Large 4 Preview bei Vals |
|---|---|
| Harvey Legal Agent | 15,83 % ±2,96 |
| Finance Agent v2 | 54,68 % ±0,58 |
| Vibe Code Bench v1.1 | 78,40 % ±3,55 |
| BioMysteryBench | 67,04 % ±2,67 |
| IOI | 45,28 % ±3,78 |
| Terminal-Bench 4.0 | 22,73 % ±0,88 |
Vals dokumentiert für sein Profil unter anderem Temperature 1, Top-p 0,95, 256K maximale Ausgabe und „reasoning effort: high“ und warnt selbst davor, dass einzelne Benchmarks andere Provider oder Parameter verwenden können.[S15]
Einordnung: Die bisher verfügbaren unabhängigen Resultate belegen ein leistungsfähiges Modell, aber noch keinen pauschalen Sieg über alle offenen oder geschlossenen Konkurrenten. Genau deshalb sollte der Artikel nicht aus einem einzelnen Mistral-Balkendiagramm die Aussage „bestes Open-Weight-Modell“ als eigene Tatsache übernehmen.
Was bedeutet Public Preview praktisch?
Mistrals Lifecycle-Dokumentation definiert Public Preview als eine nahe am finalen Stand liegende, aber noch nicht stabile GA-Phase. Preview-Modelle dürfen stille Updates erhalten und haben keinen garantierten Übergang zu General Availability.[S02]
Das ist bei Large 4 entscheidend. Axios berichtet, dass vor dem geplanten Weight-Release am 27. Oktober noch Reinforcement Learning und Sicherheitstests stattfinden.[S11] Ein Benchmark vom 6. Oktober sollte deshalb immer als Large 4 Preview beschriftet bleiben.
Sind die Large-4-Gewichte schon herunterladbar?
Nein – nicht als final veröffentlichter öffentlicher Checkpoint, den dieser Artikel am 6. Oktober verifizieren konnte. Reuters, WSJ, Axios und Frandroid nennen den 27. Oktober 2026 als geplanten Termin.[S09][S10][S11][S12]
Deshalb enthält dieser Artikel bewusst keinen erfundenen ollama run, MLX-Befehl oder GGUF-Link. Erst nach dem Weight-Release lassen sich seriös beantworten:
- Welche Checkpoints veröffentlicht Mistral tatsächlich?
- Welche Lizenz gilt?
- Gibt es offizielle oder Community-Quantisierungen?
- Unterstützen llama.cpp, MLX-LM, Ollama oder vLLM die Architektur korrekt?
- Wie hoch ist der reale Host-/Unified-Memory-Bedarf?
- Lassen sich Experten sinnvoll offloaden oder streamen?
- Welche Tokens/s liefert Apple Silicon bei realen Quantisierungen?
Für wen ist Large 4 heute interessant?
API- und Agenten-Nutzer: ja. Die Kombination aus langem Kontext, multimodaler Eingabe, Function Calling, Structured Outputs und Agents ist bereits dokumentiert.[S01][S04][S05][S06]
Unternehmen mit EU-Datenlokationsanforderungen: potenziell ja, aber Regional Inference hat eigene Preise und Funktionsgrenzen.[S03]
Lokale Mac-Nutzer: noch nicht als vollständiges Standardmodell. Die entscheidenden Dateien fehlen bis zum angekündigten Weight-Release, und die reine Parametergröße liegt weit über typischen Mac-Konfigurationen.
Benchmark-Jäger: mit Vorsicht. Die Preview kann sich still ändern; Herstellerwerte und unabhängige Evaluierungen sollten getrennt betrachtet werden.[S02][S15]
Fazit: Le Chonk ist für den Mac vor allem ein Speicherproblem
Mistral Large 4 ist technisch interessanter als die einfache Zahl „49B aktiv“ vermuten lässt. Die Sparse-MoE-Architektur reduziert den Rechenaufwand pro Token, aber nicht auf magische Weise die Größe des gesamten Expert-Pools. 1,05T Parameter entsprechen bei 4 Bit theoretisch rund 525 GB nackten Gewichten.
Für Cloud-Nutzer ist Large 4 deshalb schon heute relevant: Die API-Preview ist verfügbar, der aktuelle Aktionspreis ist niedrig und Mistral dokumentiert Multimodalität, Tools und lange Kontexte.[S01] Für lokale Macs ist dagegen der 27. Oktober der wichtigere Termin. Erst dann lassen sich Lizenz, echte Checkpoint-Größen, Quantisierungen und Runtime-Kompatibilität statt nur theoretischer Grenzen prüfen.
Nächster Schritt: Wenn du wissen willst, welche heute verfügbaren Modelle tatsächlich in deinen Mac passen, nutze den Unified-Memory-Rechner. Nach dem Large-4-Weight-Release sollte diese Seite mit den realen Dateigrößen und einem reproduzierbaren Mac-Test aktualisiert werden.
Häufig gestellte Fragen
Hat Mistral Large 4 wirklich 1 Billion Parameter?
Ja. Mistral nennt **1,05 Billionen Gesamtparameter** und 49 Milliarden aktive Parameter.
Ist Mistral Large 4 ein 49B-Modell?
Nicht im Sinn von Checkpoint- oder Speichergröße. 49B bezeichnet die pro Token aktiven Parameter. Der gesamte Expert-Pool umfasst 1,05T Parameter.
Wie viel RAM braucht Mistral Large 4 bei 4 Bit?
Die reine theoretische Gewichtsrechnung ergibt etwa **525 GB**. Der reale Bedarf wäre höher, weil Runtime, Metadaten und Cache hinzukommen.
Läuft Mistral Large 4 auf einem Mac Studio mit 512 GB?
Eine normale Q4-Darstellung passt rechnerisch bereits nicht vollständig in 512 GB. Ob spätere 3-Bit-Quantisierung, Expert-Offloading oder andere Verfahren praktikabel sind, lässt sich vor Veröffentlichung der Gewichte nicht seriös behaupten.
Hat Mistral Large 4 1M oder 512K Kontext?
Mistrals Modellkarte nennt **1M**. OpenRouter begrenzt sein aktuelles Deployment auf **524.288 Tokens**, Vals evaluiert eine 512K-Konfiguration.
Wann erscheinen die Open Weights?
Mistral plant die öffentliche Bereitstellung laut mehreren aktuellen Berichten für **27. Oktober 2026**.
Ist Large 4 Apache 2.0?
Am 6. Oktober ist das für die angekündigten Large-4-Gewichte **nicht belastbar bestätigt**. Large 3 war Apache 2.0; das darf nicht automatisch auf Large 4 übertragen werden.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- docs.mistral.ai models / mistral-large-4-0
- docs.mistral.ai inference / model-lifecycle
- docs.mistral.ai inference / regional-inference
- docs.mistral.ai conversations / structured-output
- docs.mistral.ai agents / introduction
- docs.mistral.ai agents / agents-api
- mistral.ai news / mistral-3
- docs.mistral.ai models / mistral-large-3-25-12
- reuters.com china / mistral-ceo-says-new-ai-model-beats-chinese-ones-some-areas-2026-10-06
- wsj.com ai / mistral-to-release-new-ai-model-to-better-compete-with-u-s-rivals-3f7c8a3d
- axios.com 06 / reflection-mistral-open-weight-ai-models-china
- frandroid.com intelligence-artificielle / 3274547_mistral-annonce-large-4-le-grand-retour-face-aux-cadors-chinois
- thenextweb.com news / mistral-releases-large-4-a-1-trillion-parameter-open-weight-ai-model
- venturebeat.com technology / mistral-debuts-large-4-le-chonk-a-1-trillion-parameter-text-output-model-with-high-benchmarks-planned-for-open-weights-release
- vals.ai models / mistralai_mistral-large-4
- openrouter.ai mistralai / mistral-large-4-0
- vercel.com models / mistral-large-4
- numerama.com tech / 2347595-mistral-relance-la-france-dans-la-course-a-lia-et-devoile-le-chonk-un-modele-de-frontiere-a-1000-milliards-de-parametres.html
- ai-on-mac.com artikel / unified-memory-mac
- ai-on-mac.com hardware / matchmaker