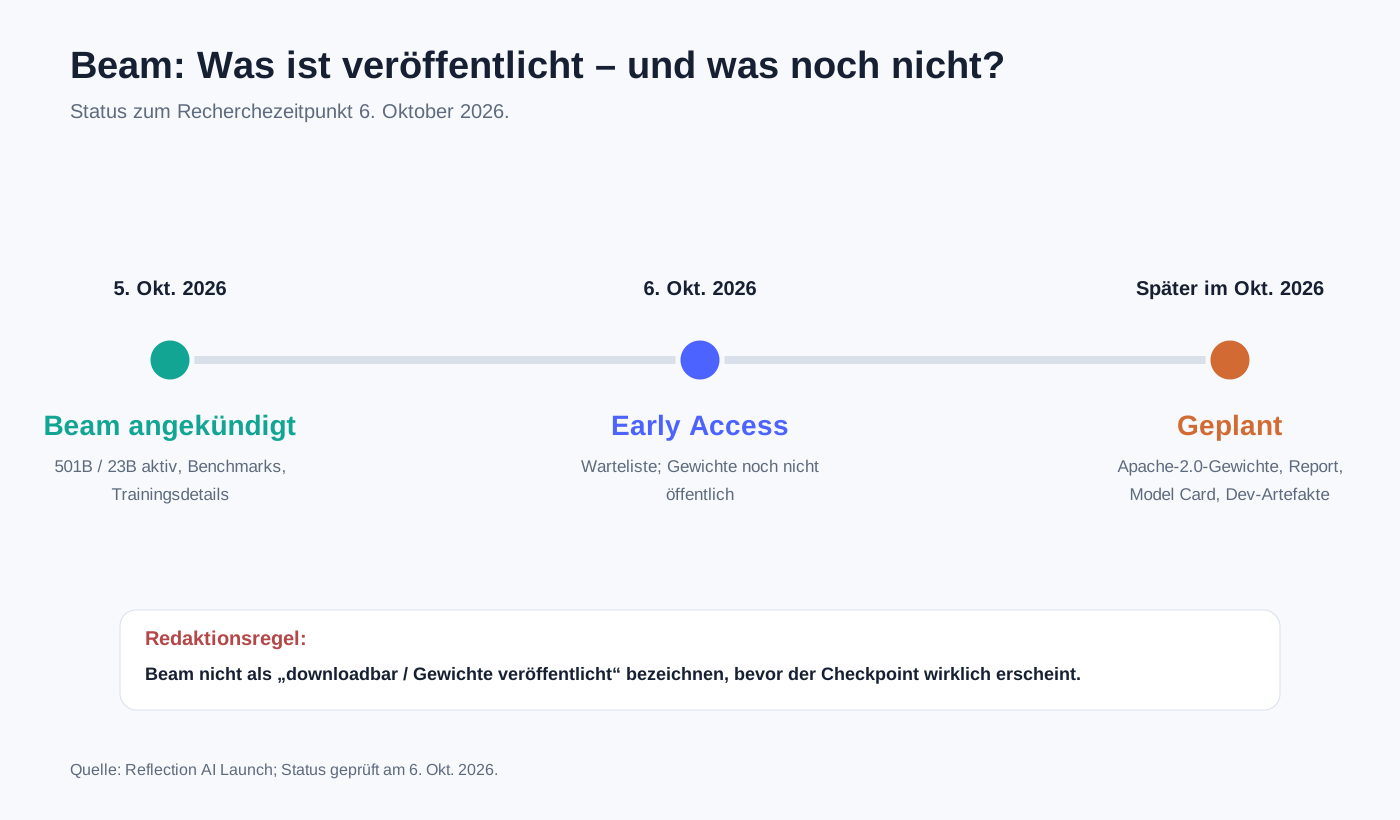
Stand der Recherche: 6. Oktober 2026. Reflection AI hat Beam am 5. Oktober 2026 vorgestellt. Das Modell ist ein sparsames Mixture-of-Experts-Modell mit 501 Milliarden Gesamtparametern und 23 Milliarden aktiven Parametern pro Token. Es wurde vor allem für Coding, Reasoning und agentische Workloads trainiert. Die entscheidende Einschränkung: Die Gewichte sind noch nicht öffentlich verfügbar. Reflection stellt sie zusammen mit Technical Report, Model Card und Entwicklerwerkzeugen erst für später im Oktober 2026 in Aussicht. Bis dahin ist Beam ein Early-Access-Modell und kein frei herunterladbarer lokaler LLM-Release. [S01][S03]
Beam ist technisch interessant, weil Reflection hohe Agenten- und Coding-Leistung mit nur 23B aktiven Parametern erreichen will. Die veröffentlichten Resultate sind jedoch bislang überwiegend Herstellerwerte. Wer Beam lokal, auf Apple Silicon oder in einer reproduzierbaren eigenen Benchmark-Pipeline testen will, muss auf die Gewichte und die vollständige technische Dokumentation warten. [S01][S12]
Beam auf einen Blick
| Merkmal | Stand am 6. Oktober 2026 |
|---|---|
| Entwickler | Reflection AI |
| Ankündigung | 5. Oktober 2026 |
| Architektur | Sparse Mixture of Experts (MoE) |
| Gesamtparameter | 501B |
| Aktive Parameter | 23B pro Token |
| Aktivierungsanteil | ca. 4,59 % |
| Layer | 52 |
| Pretraining | 23,8 Billionen Token |
| Effektive Kontextlänge im Training | 1M Token |
| RL-Skalierung | >100 Mio. Rollouts |
| RL-Hardware | 10.500 NVIDIA GB300 über vier Wochen |
| Pretraining-Hardware | 6.144 NVIDIA GB300 NVL72; unter vier Wochen |
| Modalität | derzeit als Textmodell beschrieben |
| Gewichte | noch nicht veröffentlicht |
| Geplante Lizenz | Apache 2.0 |
| Preis | kein belastbarer öffentlicher Tokenpreis gefunden |
Quellen: Reflection AI [S01], Reuters [S03], Business Insider [S08]. API-spezifische Beta-Grenzen werden von mehreren Sekundärquellen anhand von Reflection-Dokumentation beschrieben, sind aber während der Beta veränderlich. [S11][S12][S15]
Was ist Reflection AI Beam?
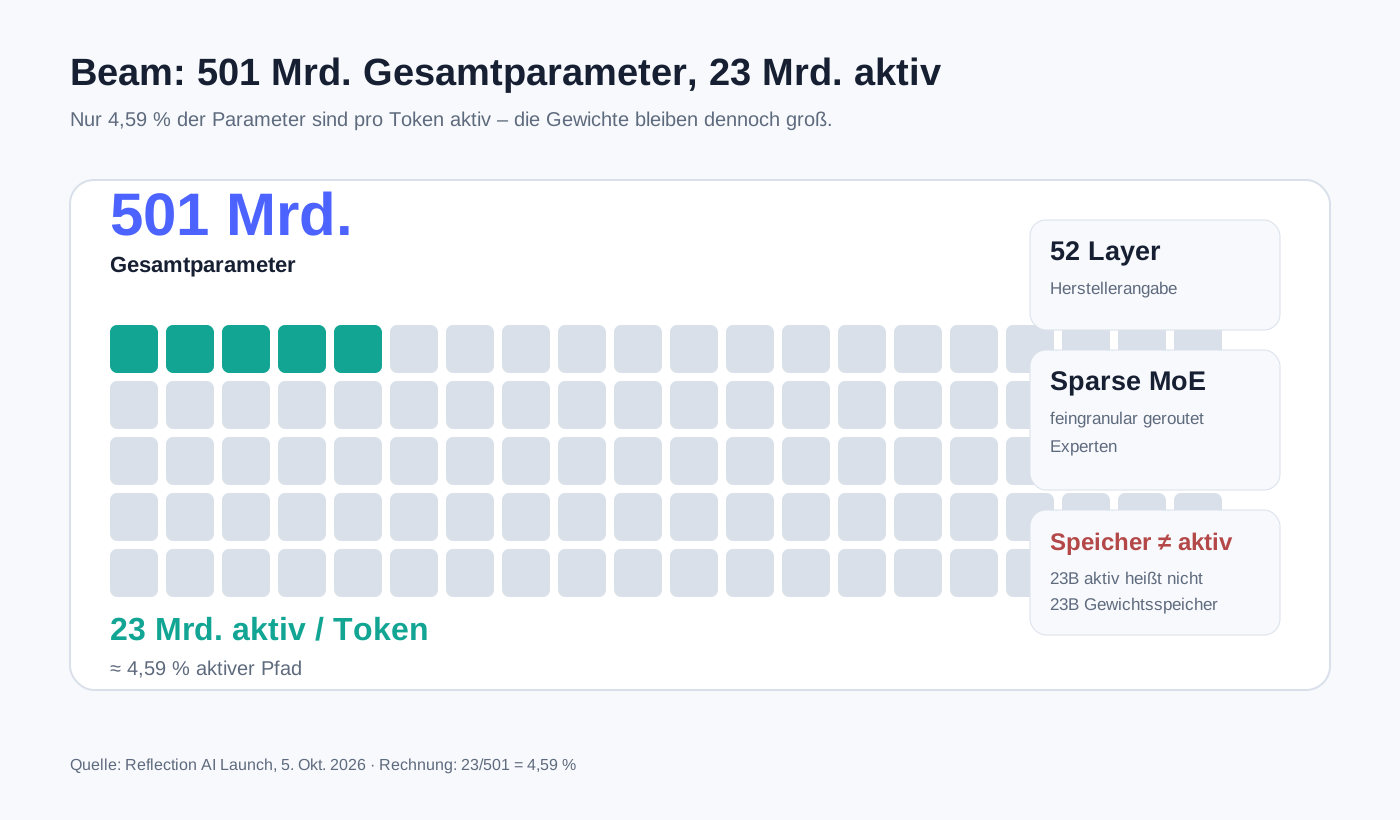
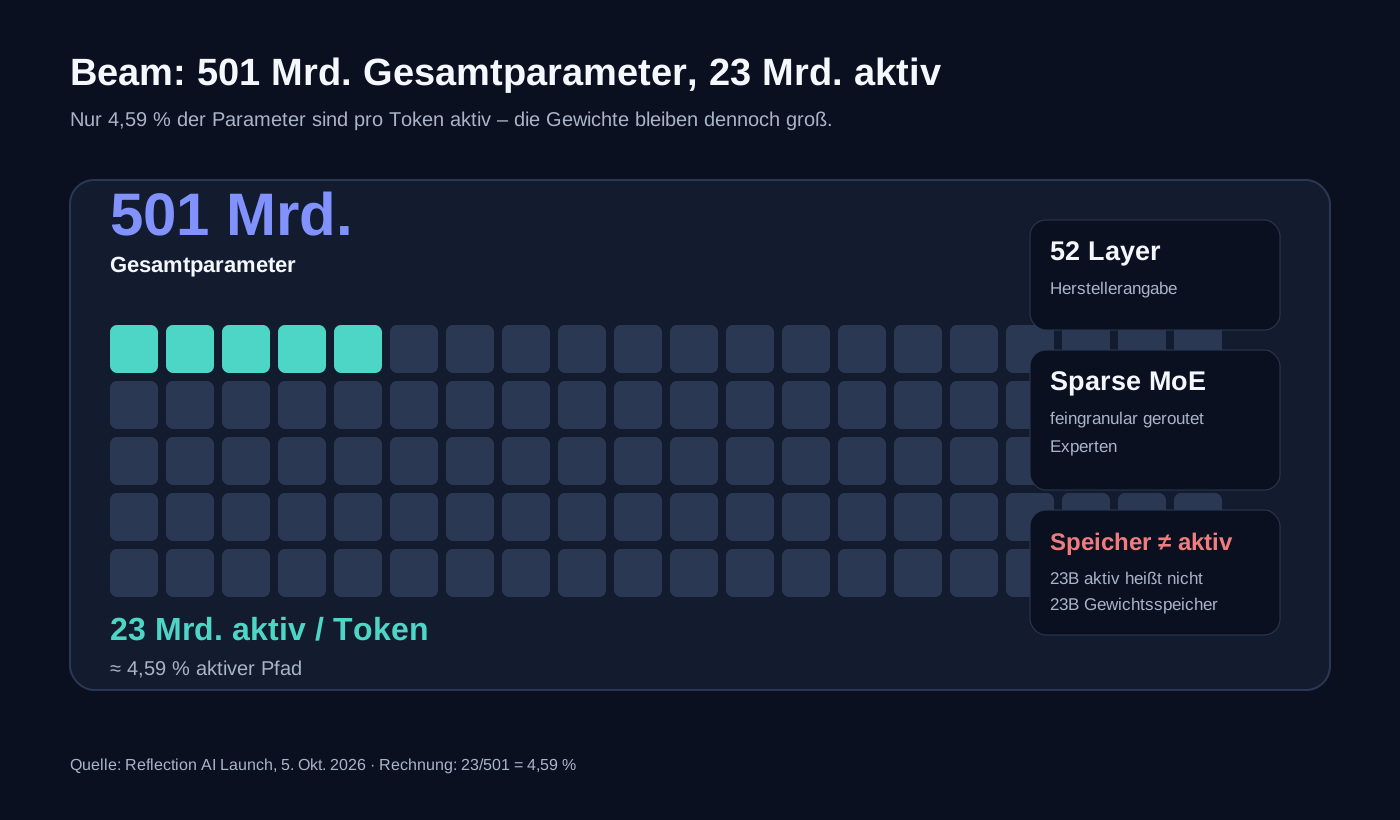
Beam ist Reflection AIs erstes angekündigtes Open-Weight-Modell. Anders als ein dichtes 501B-Modell aktiviert ein sparsames MoE nicht alle Parameter für jeden Token. Bei Beam werden laut Reflection ungefähr 23B von 501B Parametern pro Token genutzt. Das entspricht rechnerisch rund 4,59 Prozent der Gesamtparameter. [S01]
Das ist für die Inferenz relevant: Weniger aktive Parameter können die Rechenarbeit pro generiertem Token deutlich reduzieren. Gleichzeitig darf man daraus nicht schließen, dass Beam nur so viel Speicher wie ein 23B-Modell benötigt. Ein lokaler Inferenz-Stack muss weiterhin Zugriff auf die Expertengewichte des Gesamtmodells haben. Genau dieser Unterschied ist für lokale Systeme und besonders für Macs mit Unified Memory wichtig.
Reflection positioniert Beam nicht als universellen Sieger über alle offenen Modelle. Das Unternehmen sagt selbst, dass Kimi K3 bei der Rohleistung weiterhin vorne liegt, während Beam vor allem mit Inference-Effizienz punkten soll. [S01] Das ist eine sinnvollere Lesart als Schlagzeilen wie „DeepSeek des Westens“: Beam versucht derzeit eher, einen attraktiven Punkt auf der Kurve aus Qualität, aktiven Parametern, Laufzeit und Kontrollierbarkeit zu treffen. [S05][S08]
Architektur: Warum 501B Gesamtparameter und 23B aktive Parameter zusammenpassen
Reflection beschreibt Beam als 52-schichtiges MoE mit interleaved local and global attention, fein granular gerouteten Experten und mehreren Mechanismen zur Lastverteilung. Das Unternehmen baut dabei auf auxiliary-loss-free load balancing auf und ergänzt unter anderem einen Cosine Decay für Expert-Bias-Updates sowie sequence-level balancing. Laut Reflection lag die Last des am stärksten genutzten Experten am Ende des Pretrainings nur bei etwa 1,04× des Durchschnitts. [S01]
Die technische Idee dahinter ist wichtig: Ein MoE kann eine sehr große Zahl spezialisierter Gewichte besitzen, ohne alle bei jedem Token durchzurechnen. Beam versucht dadurch, eine deutlich größere Wissens- und Kapazitätsbasis mit einer vergleichsweise kleinen aktiven Rechenmenge zu kombinieren.
Das ist allerdings keine Garantie für niedrige Gesamtkosten. Prompt-Prefill, Attention über lange Kontexte, KV-Cache, Routing, Speicherbandbreite und Serving-Overhead bleiben relevant. Reflection weist selbst darauf hin, dass seine FLOP-Schätzung für den Effizienzvergleich diese Faktoren teilweise ausklammert. [S01]
Training: 23,8 Billionen Token und eine ungewöhnlich große RL-Phase
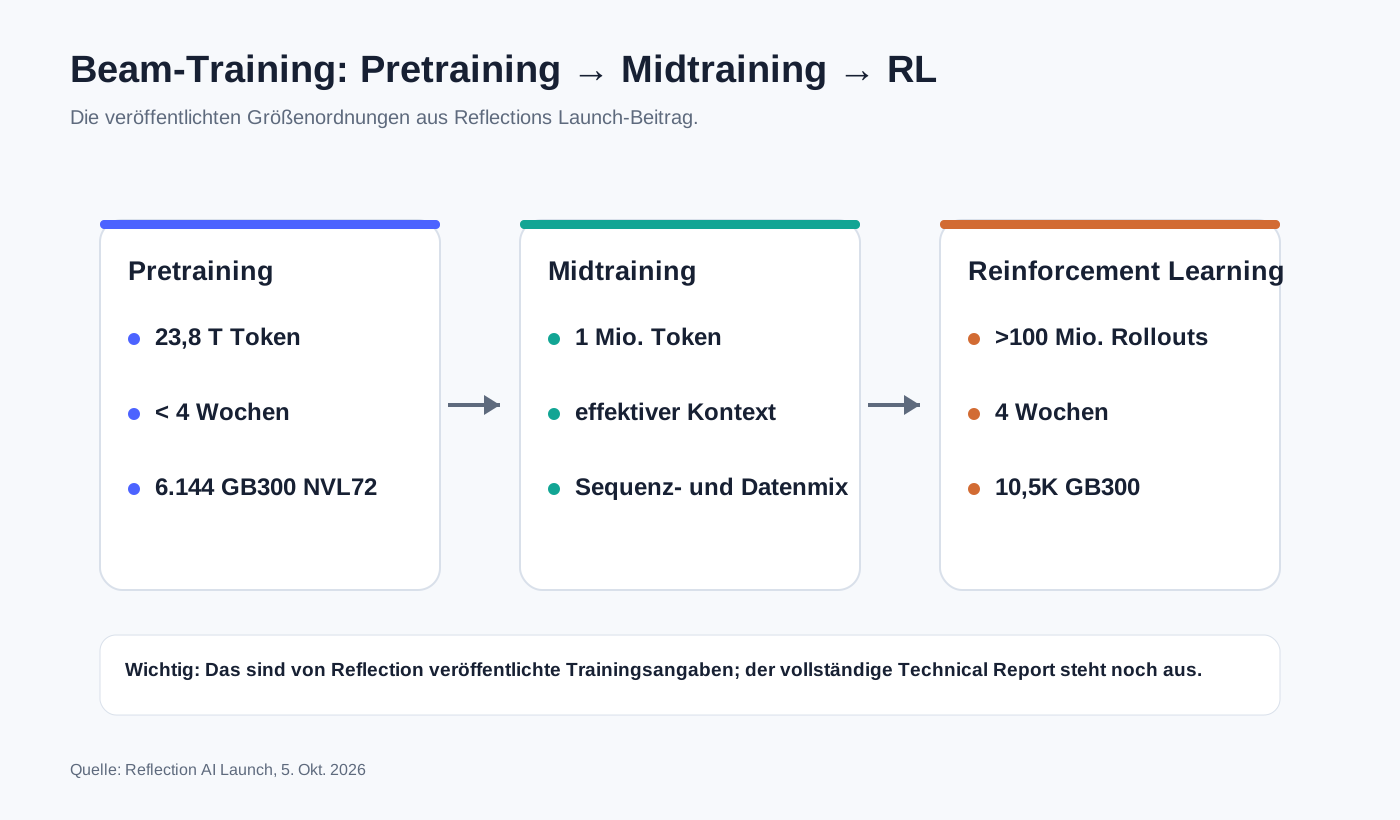
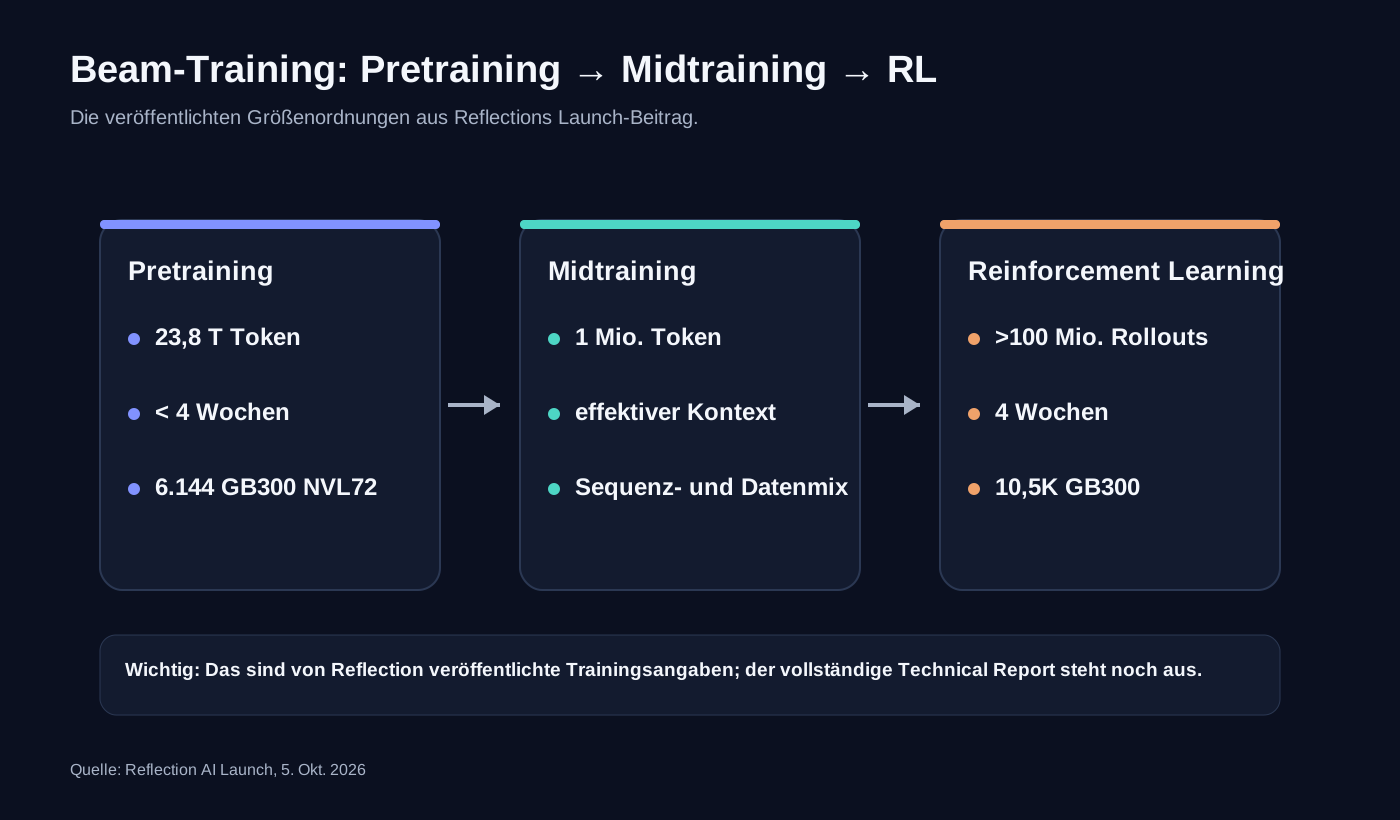
Beam wurde laut Reflection auf 23,8 Billionen kuratierten Token aus Webdaten, öffentlichen Quellen und proprietär lizenzierten Datensätzen vortrainiert. Das Unternehmen gibt an, rund 95 Prozent der rohen Internet-Token durch Parsing, Deduplizierung und Qualitätsfilter zu verwerfen. [S01]
Das Pretraining lief laut Reflection in weniger als vier Wochen auf 6.144 NVIDIA GB300 NVL72 GPUs. Danach folgte eine sehr große Reinforcement-Learning-Phase: Mehr als 100 Millionen Rollouts auf 10.500 GB300 GPUs über vier Wochen, mit rund 1,3 Milliarden Sandboxes und ungefähr einer Million Coding-, Agenten- und STEM-Umgebungen. [S01]
Diese Zahlen sind bemerkenswert, aber sie stammen vom Hersteller. Der noch ausstehende Technical Report wird entscheidend dafür sein, Details zur Datenmischung, Reproduzierbarkeit, Safety-Evaluation, Reward-Struktur und zu den konkreten Trainings- und Eval-Harnesses zu prüfen.
Kontextlänge: 1M ist offiziell – aber nicht mit einer garantierten 1M-API gleichzusetzen
Reflection schreibt, dass Midtraining die effektive Kontextlänge von Beam auf 1 Million Token erweitert habe. Gleichzeitig nennt das Unternehmen für die RL-Rollouts eine maximale Kontextlänge von 256K. [S01]
Mehrere technische Sekundärquellen, die Reflection-Dokumentation am 5. und 6. Oktober geprüft haben, berichten für die aktuelle Beta-API eine kombinierte Grenze von rund 262.144 Token und maximal ungefähr 131.072 Ausgabetoken. Diese Werte sind ausdrücklich als Beta-Grenzen beschrieben und können sich ändern. [S11][S12][S15]
Daher sollte eine veröffentlichte Spezifikation heute sauber unterscheiden:
- 1M Token: offiziell genannte effektive Kontextfähigkeit aus dem Training.
- 256K/262K: derzeit berichtete Beta-Serving-Grenze, nicht die theoretische Modellgrenze.
- 128K/131K Output: berichtete Beta-Ausgabegrenze, ebenfalls veränderlich.
Benchmarks: stark, aber noch kein unabhängiger Sieg
Reflection hat Beam in einer breiten Benchmarktabelle gegen Inkling, Nemotron 3 Ultra, GLM-5.2, GLM-5.3, Kimi K3, Qwen3.8-Max und DeepSeek V4.1 Flash gestellt. [S01]
Eine Auswahl der vom Hersteller veröffentlichten Werte:
| Benchmark | Beam | GLM-5.2 | GLM-5.3 | Kimi K3 | Qwen3.8-Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 44,4 | 44,0 | 61,0 | 68,0 | 51,0 | 74,2 |
| SWE-bench Pro v1 | 65,5 | 62,1 | n. a. | n. a. | 67,7 | n. a. |
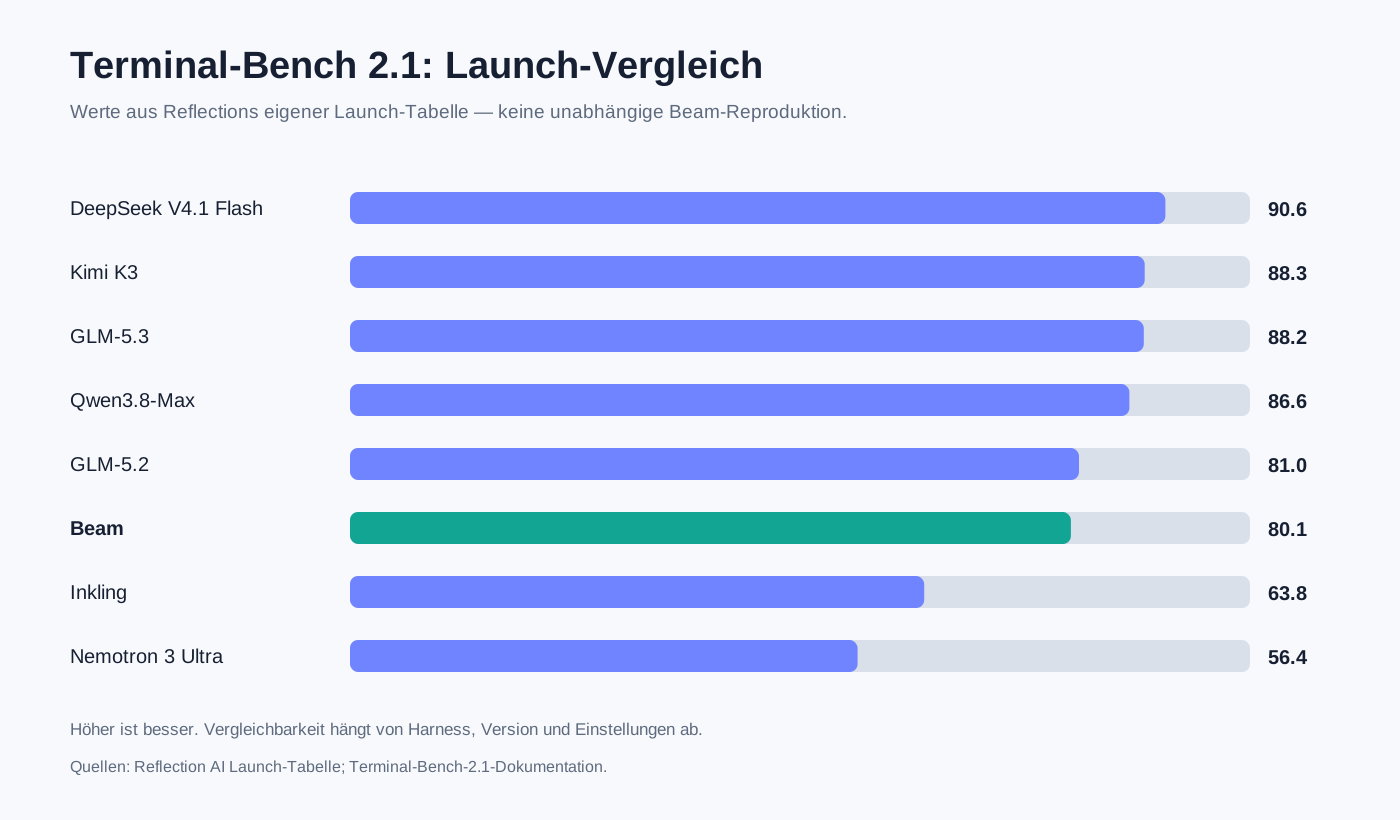
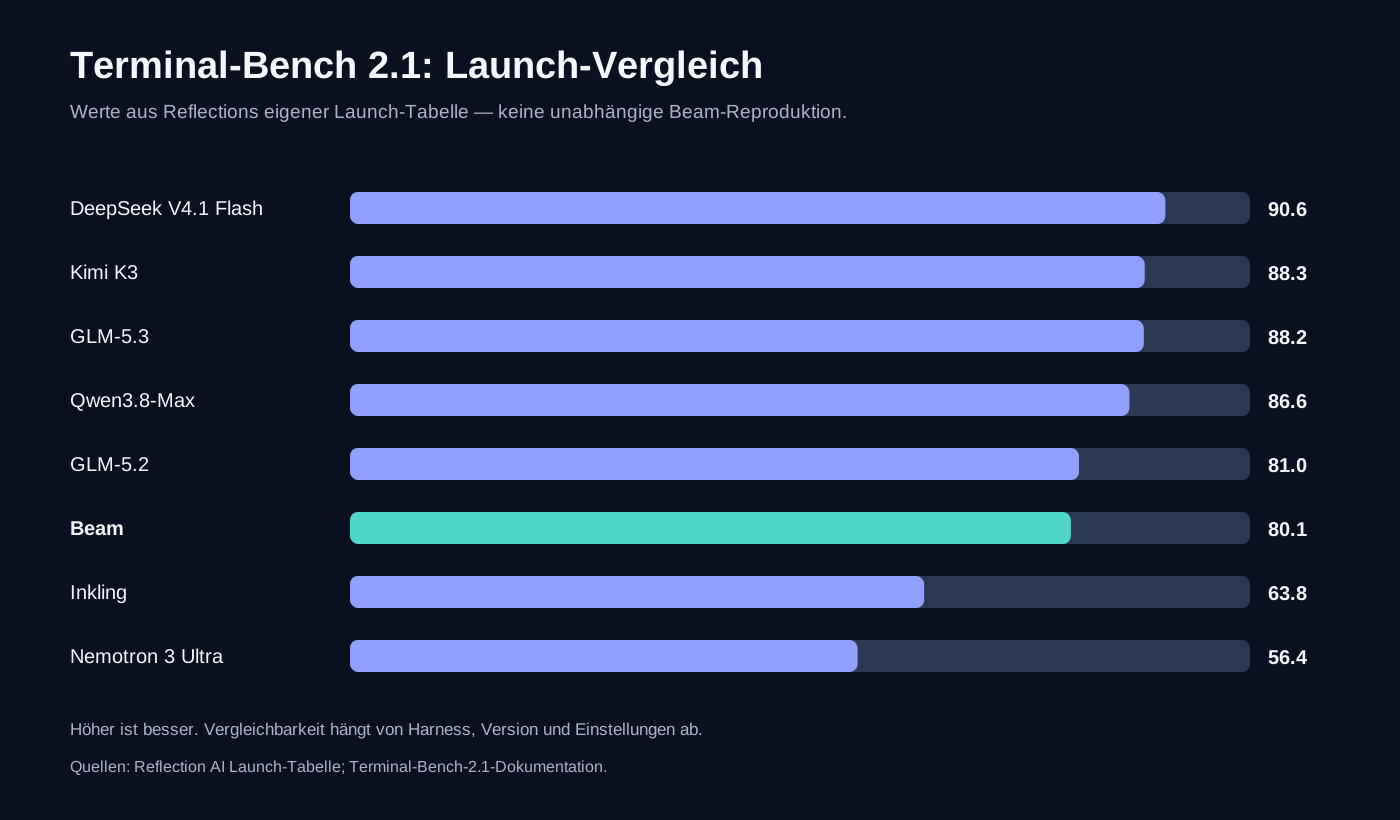
| Terminal-Bench 2.1 | 80,1 | 81,0 | 88,2 | 88,3 | 86,6 | 90,6 |
| HLE, ohne Tools | 36,2 | 40,5 | 42,3 | 46,9 | 43,6 | 39,1 |
| GPQA Diamond | 90,5 | 91,2 | 91,7 | 93,5 | 92,6 | 90,9 |
| AutomationBench public | 37,0 | 26,2 | 48,2 | 46,7 | 39,8 | 54,8 |
| AA-LCR | 79,3 | 78,3 | 79,7 | 88,7 | 80,3 | 84,0 |
| IFBench | 79,7 | 73,3 | n. a. | n. a. | 82,8 | n. a. |
Wichtig: Diese Tabelle ist keine universelle Rangliste. Die Werte stammen aus Reflections Launch-Material, teils aus unterschiedlichen externen Quellen und Harnesses. „n. a.“ bedeutet, dass Reflection in dieser Tabelle keinen Wert aufführt. [S01]
Was die Werte tatsächlich zeigen
Beam wirkt konkurrenzfähig, aber nicht führend auf jeder Achse. Auf Terminal-Bench 2.1 liegt es mit 80,1 knapp hinter GLM-5.2 und deutlich hinter GLM-5.3, Kimi K3, Qwen3.8-Max und DeepSeek V4.1 Flash. Auf DeepSWE v1.1 ist der Abstand zu den stärksten Vergleichsmodellen noch größer. [S01]
Gleichzeitig erreicht Beam hohe Werte auf SWE-bench Verified, Multilingual SWE-bench und mehreren Reasoning-Tests. Die interessantere Behauptung von Reflection lautet deshalb nicht „höchster Score“, sondern ähnliche Reasoning-Leistung bei weniger aktiver Inferenzrechenarbeit. [S01]
Warum die Benchmark-Lesart vorsichtig sein muss
SWE-bench Verified besteht aus 500 von Menschen geprüften Software-Engineering-Aufgaben. Das Projekt weist ausdrücklich darauf hin, dass Ergebnisse verschiedener Agent-Versionen und Harnesses nicht automatisch vergleichbar sind. [S22] Terminal-Bench 2.1 wiederum ist eine korrigierte Version von 2.0, bei der 28 von 89 Aufgaben überarbeitet wurden. [S25]
AutomationBench unterscheidet zwischen öffentlichem Taskset und privater offizieller Wertung; lokale Public-Scores müssen nicht 1:1 dem offiziellen Leaderboard entsprechen. [S23] AA-LCR misst Langkontext-Reasoning über Dokumentsets mit ungefähr 100K Input-Token, nicht allgemeine Modellqualität. [S38] IFBench testet präzise Instruction-Following-Constraints, nicht Coding-Leistung. [S39]
Der wichtigste Punkt: Zum Recherchestand 6. Oktober 2026 gibt es noch keine breite unabhängige Reproduktion der Beam-Scores. AIEvals listet die veröffentlichten Reflection-Werte, aber noch keine unabhängigen Beam-Läufe in den von ihm geprüften externen Leaderboards. [S12]
Wie Beam gegenüber den wichtigsten Open-Weight-Konkurrenten einzuordnen ist
Beam vs. GLM-5.2 und GLM-5.3
GLM-5.2 unterstützt laut Z.ai 1M Kontext und ist bereits mit Gewichten verfügbar. GLM-5.3 nutzt denselben Base-Model-Unterbau, wurde aber deutlich stärker post-trainiert und ist bei komplexem Coding stärker. [S30][S31]
Beam ist aktuell deshalb kein klarer Ersatz: GLM kann heute lokal oder über bestehende Anbieter getestet werden; Beam noch nicht. Beam könnte später attraktiver werden, wenn die versprochene Effizienz sich in unabhängigen Runs bestätigt.
Beam vs. Qwen3.8-Max
Qwen3.8-Max ist laut Alibaba ein 2,4-Billionen-Parameter-Modell mit bis zu 1M Kontext und multimodalen Fähigkeiten. [S29] Reflection sagt selbst, Beam nähere sich Qwen3.8-Max bei Coding- und Agent-Aufgaben an, sei aber deutlich kleiner und aktiviere weniger Parameter. [S01]
Für den praktischen Einsatz bleibt Qwen3.8-Max heute reifer verfügbar. Beam ist interessanter als potenziell effizienteres Open-Weight-Arbeitspferd, sobald die Gewichte tatsächlich vorliegen.
Beam vs. Kimi K3
Moonshot positioniert Kimi K3 als offenes, multimodales Agentenmodell. [S32] Reflection räumt Kimi K3 in seiner eigenen Kommunikation die höhere Rohleistung ein. [S01] Wer maximale Capability sucht, sollte Beam daher nicht allein anhand des Effizienz-Narrativs vor Kimi K3 setzen.
Beam vs. DeepSeek V4.1 Flash
DeepSeek V4.1 Flash nutzt 552B Gesamtparameter, aber nur 8B aktive Parameter für Input und 16B für Output und ist bereits per API verfügbar. [S33][S40] Auf mehreren in Reflections Tabelle aufgeführten Agenten-Benchmarks liegt V4.1 Flash deutlich vor Beam, darunter Terminal-Bench 2.1 und DeepSWE v1.1. [S01]
Beam muss seine praktische Effizienz daher nicht nur gegen größere Modelle, sondern auch gegen sehr aggressive Sparse-Architekturen wie DeepSeek beweisen.
Beam vs. Nemotron 3 Ultra und Inkling
NVIDIA Nemotron 3 Ultra besitzt 550B Gesamt- und 55B aktive Parameter, 1M Kontext und ist für langlaufende Agenten ausgelegt. [S34][S42] Thinking Machines Inkling hat 975B Gesamt- und 41B aktive Parameter, 1M Kontext und multimodale Eingaben; die Gewichte sind bereits verfügbar. [S35][S41]
Beam ist unter diesen westlichen Vergleichsmodellen besonders interessant, weil es nur 23B Parameter pro Token aktiviert. Ob das in realen Agenten-Stacks tatsächlich zu besseren Kosten pro erledigter Aufgabe führt, ist aber noch offen.
Kann Reflection AI Beam lokal auf einem Mac laufen?
Heute: nein, nicht seriös testbar. Der wichtigste Grund ist nicht die Mac-Hardware, sondern dass Reflection die Gewichte noch nicht veröffentlicht hat. [S01]
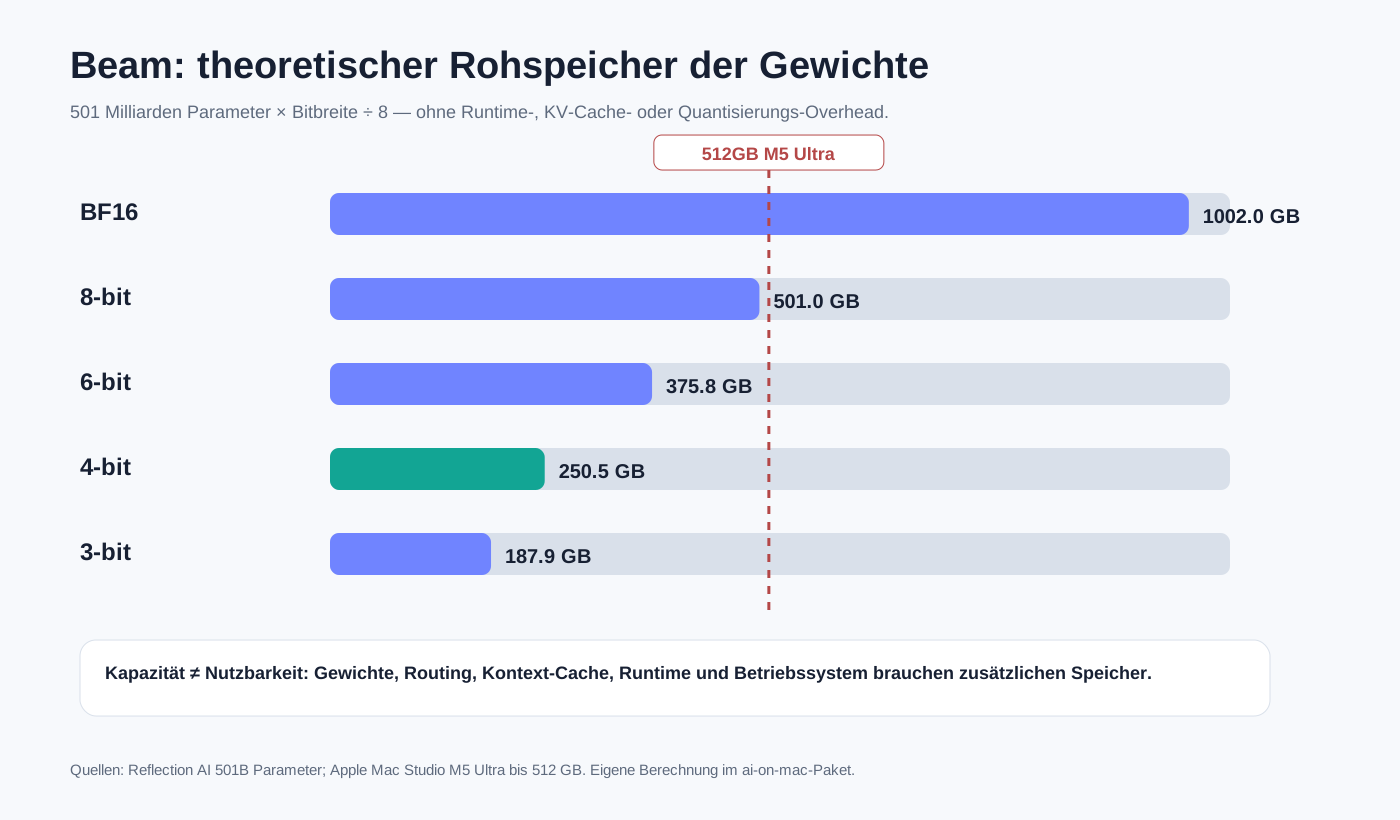
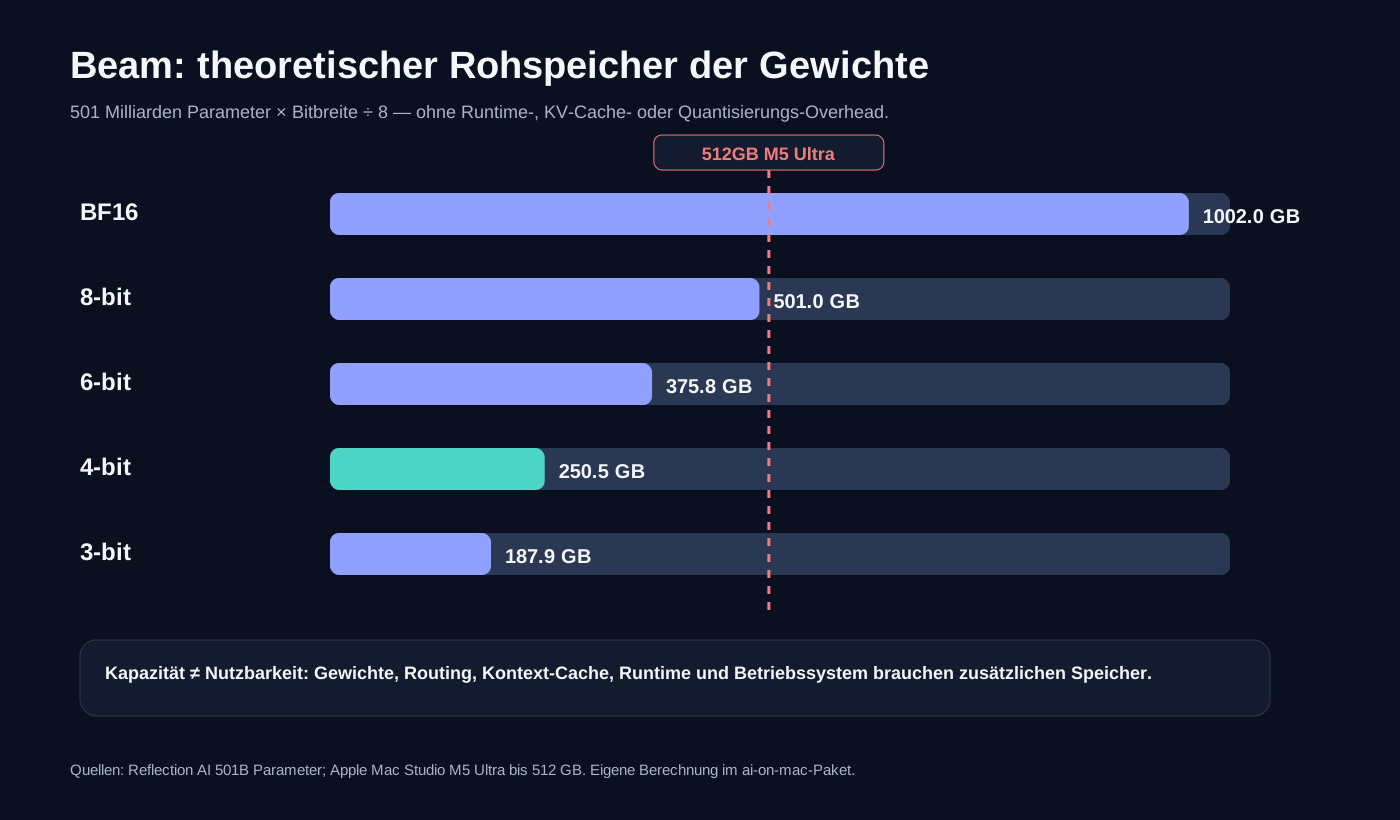
Trotzdem lässt sich die reine Speicherdimension berechnen. Bei 501 Milliarden Parametern beträgt der theoretische Rohspeicher nur für die Gewichte:
| Format | Formel | Reine Gewichte | Einordnung |
|---|---|---|---|
| BF16 / FP16 | 501B × 2 Byte | ca. 1.002 GB | weit über einem einzelnen Mac Studio |
| 8 Bit | 501B × 1 Byte | ca. 501 GB | praktisch kein Platz für Runtime, Cache und Overhead |
| 6 Bit | 501B × 0,75 Byte | ca. 375,75 GB | Kapazität auf 512GB-System theoretisch möglich, sehr wenig Reserve |
| 4 Bit | 501B × 0,5 Byte | ca. 250,5 GB | Kapazität auf 512GB-System grundsätzlich plausibel |
| 3 Bit | 501B × 0,375 Byte | ca. 187,88 GB | kleiner, aber Qualitäts- und Runtime-Fragen offen |
Eigene Berechnung. Nicht enthalten sind Quantisierungsmetadaten, KV-Cache, Aktivierungen, temporäre Buffers, Runtime, Betriebssystem und mögliche MoE-spezifische Speicherstrukturen.
Der aktuelle Mac Studio mit M5 Ultra kann laut Apple mit bis zu 512 GB Unified Memory und 1,2 TB/s Speicherbandbreite konfiguriert werden. [S36][S37] Damit ist Beam in 4-Bit-Form erstmals zumindest in der theoretischen Speicherkapazitätsklasse eines einzelnen High-End-Macs. Das ist nicht dasselbe wie „läuft gut“.
Warum 23B aktive Parameter nicht 23B Speicher bedeuten
Das ist der häufigste Denkfehler bei MoE-Modellen. Nur ein Teil der Experten rechnet pro Token, aber die Routing-Schicht muss auf die möglichen Experten zugreifen können. Für eine vollständig lokale Inferenz müssen die Gesamtgewichte typischerweise im RAM/VRAM oder über ausreichend schnelles Offloading erreichbar sein.
Ein Mac Studio mit 128 GB oder 256 GB wäre für eine 4-Bit-Vollquantisierung des 501B-Modells daher voraussichtlich zu klein oder extrem eingeschränkt. Ein 512-GB-M5-Ultra-System könnte die Rohgewichte aufnehmen, aber wir wissen noch nicht:
- welche Quantisierungsformate Reflection oder Partner bereitstellen,
- ob MLX, llama.cpp oder andere Apple-Silicon-Runtimes Beam unterstützen,
- wie effizient das Expert-Routing auf Apple GPUs implementiert wird,
- welchen Speicher der KV-Cache bei langen Kontexten benötigt,
- welche Tokens/s bei 4 Bit oder aggressiverer Quantisierung erreichbar sind,
- wie stark die Qualität durch 4- oder 3-Bit-Quantisierung leidet.
Solange die Gewichte fehlen, wäre jede konkrete „Beam auf M5 Ultra“-Geschwindigkeitsangabe erfunden.
Was ist heute tatsächlich verfügbar?
Am 6. Oktober 2026 ist Beam laut Reflection in einer Early-Access-Phase für ausgewählte Nutzer. Das Unternehmen verweist auf eine Warteliste und plant die öffentliche Gewichtsveröffentlichung für später im Oktober. [S01]
Mehrere technische Publikationen berichten aus der Reflection-Beta-Dokumentation eine OpenAI-kompatible Chat-Completions-Schnittstelle mit der Modell-ID Beam-501B-A23B. Sie berichten außerdem konfigurierbare Reasoning-Stufen und Beta-Kontextlimits. [S11][S12][S15] Da diese Dokumentation während der Recherche nicht als frei crawlbare Primärseite verfügbar war und Reflection die Beta ändern kann, sollten diese Angaben vor einer produktiven Integration erneut im Entwicklerkonto geprüft werden.
Nicht belastbar veröffentlicht sind derzeit:
- endgültiger API-Preis pro Million Token,
- finale Self-Hosting-Anforderungen,
- finale Quantisierungs- und Inferenzformate,
- vollständige Safety-Evaluation,
- Model Card,
- vollständiger Technical Report,
- unabhängige Reproduktionen der wichtigsten Beam-Scores.
Für wen ist Beam schon jetzt relevant?
Beam ist heute vor allem für vier Gruppen interessant:
- Coding-Agent-Entwickler, die ein zukünftiges effizientes Open-Weight-Backend evaluieren wollen.
- Unternehmen mit Self-Hosting-Anforderungen, für die Datenkontrolle und eigene Infrastruktur wichtiger sind als maximaler Closed-Model-Score.
- Forscher und Benchmark-Teams, weil Reflection eine ungewöhnlich große RL-Trainingskampagne dokumentiert und technische Details zur MoE-Stabilität veröffentlicht.
- Local-AI-Nutzer mit sehr großer Unified-Memory-Hardware, weil 4-Bit-Beam theoretisch in die 512-GB-Klasse fallen könnte – sofern passende Quantisierung und Runtime erscheinen.
Sollte man auf Beam warten?
Für einen produktiven Einsatz heute würde ich Beam noch nicht gegenüber bereits verfügbaren Modellen auswählen. GLM-5.2/5.3, Qwen3.8-Max, Kimi K3, DeepSeek V4.1 Flash, Nemotron 3 Ultra und Inkling besitzen bereits deutlich mehr öffentlich überprüfbare Deployment-Informationen oder verfügbare Gewichte. [S29-S35]
Beam wird interessant, sobald drei Bedingungen erfüllt sind:
- die versprochenen Apache-2.0-Gewichte sind tatsächlich veröffentlicht,
- unabhängige Coding- und Agenten-Benchmarks bestätigen die Herstellerwerte,
- reale Inferenzdaten zeigen Kosten, Latenz, Tokens/s und Speicherverbrauch in konkreten Runtimes.
Für Apple Silicon kommt eine vierte Bedingung hinzu: funktionierende MLX- oder vergleichbare Unterstützung für das Beam-MoE.
Fazit
Reflection AI Beam ist kein fertiger „DeepSeek-Killer“, aber ein ungewöhnlich interessanter Open-Weight-Kandidat. Die technische Kombination aus 501B Gesamtparametern, 23B aktiven Parametern, 23,8T Pretraining-Token, 1M effektiver Kontextlänge und einer RL-Kampagne mit mehr als 100 Millionen Rollouts ist substanziell. [S01]
Die wichtigste Information am 6. Oktober 2026 ist jedoch einfacher: Beam ist noch nicht vollständig veröffentlicht. Die Benchmarkwerte sehen konkurrenzfähig aus, sind aber noch nicht breit unabhängig reproduziert. Wer lokal auf dem Mac testen möchte, kann heute nur den Speicherbedarf abschätzen. Ein 512-GB-Mac-Studio könnte eine spätere 4-Bit-Version theoretisch aufnehmen; ob Beam dort schnell und stabil läuft, wird sich erst nach Veröffentlichung der Gewichte und Runtime-Unterstützung zeigen. [S01][S36]
Was als Nächstes geprüft werden sollte
Sobald Reflection die Gewichte veröffentlicht, sind die wichtigsten Tests:
- SHA/Version und tatsächliche Lizenz prüfen,
- BF16/FP8/FP4/GGUF/MLX-Formate erfassen,
- Speicherbedarf bei 4 Bit und 6 Bit messen,
- Prompt-Prefill und Decode-Tokens/s auf 256GB- und 512GB-Macs testen,
- 32K/128K/256K Kontext separat messen,
- identischen Agent-Harness gegen GLM-5.3, DeepSeek V4.1 Flash und Qwen3.8-Max laufen lassen,
- Kosten pro vollständig gelöster Aufgabe statt nur Preis pro Token vergleichen.
Häufig gestellte Fragen
Kann ich Beam heute herunterladen?
Nein. Reflection kündigt die Gewichte für später im Oktober 2026 an. [S01]
Ist Beam Open Source?
Reflection bezeichnet Beam als Open-Weight-Modell und plant die Gewichte unter Apache 2.0 sowie einen offenen Entwickler-Stack. Bis die tatsächlichen Artefakte vorliegen, ist „Open Weight“ die präzisere Beschreibung. [S01][S02]
Hat Beam 1 Million Token Kontext?
Reflection nennt 1M Token als effektive Kontextlänge nach Midtraining. Die aktuelle Beta-Serving-Grenze wird von mehreren Quellen niedriger angegeben und kann sich ändern. [S01][S11][S12]
Ist Beam besser als DeepSeek V4.1 Flash oder Kimi K3?
Nicht allgemein. In Reflections eigener Tabelle liegen Kimi K3 und DeepSeek V4.1 Flash auf mehreren Agenten- und Coding-Benchmarks vor Beam. Reflections stärkstes Argument ist Effizienz, nicht absolute Führung in jedem Benchmark. [S01]
Kann Beam auf einem Mac Studio M5 Ultra mit 512 GB laufen?
Noch nicht getestet. Rechnerisch benötigen 501B Parameter bei 4 Bit rund 250,5 GB reine Gewichtsdaten. Ein 512-GB-Mac hat also grundsätzlich genug Kapazität für die Rohgewichte, aber Runtime-Overhead, KV-Cache, Quantisierung, MoE-Unterstützung und tatsächliche Performance sind unbekannt. [S36]