Kurzantwort
Neon erreicht im unabhängigen Index fast Carbon-Niveau in weniger als der halben Zeit; pro Token ist es aber erst ab 1. Dezember günstiger als Carbon. Keine lokal ausführbaren Gewichte.
- API-Preis
- 3 $ Input · 0,15 $ Cache · 15 $ Output je 1 Mio. Tokens
- Batch/Flex
- 1,50 $ / 7,50 $
- Kontext
- 1.048.576 Tokens (gemeinsam), 65.536 Output synchron
- Verfügbar
- API (Paid), Gemini-App und Antigravity für AI Pro/Ultra, Google-Cloud-Enterprise
- Geprüft am
- 19.11.2026
Zuletzt geprüft: 19. November 2026
Gemini 4 Neon ist das Modell, das Google am 18. November 2026 als Mittelstufe der Gemini-4-Familie veröffentlicht hat – zwischen dem schnellen Hydrogen und dem großen Carbon. Über die Gemini API kostet Neon 3 $ pro Million Input-Tokens, 0,15 $ für gecachten Input und 15 $ pro Million Output-Tokens bei einem Kontextfenster von 1 Million Tokens (Google). Nutzbar ist es nur im kostenpflichtigen API-Tarif und in der Gemini-App beziehungsweise in Google Antigravity für Google AI Pro und Ultra.
Stand dieser Prüfung: 19. November 2026, 9:30 Uhr. Die wichtigste Einschränkung: Bis zum 30. November ist Gemini 4 Carbon wegen seines Einführungspreises pro Token günstiger als Neon. Erst ab dem 1. Dezember dreht sich das Verhältnis. Viele Benchmark-Werte stammen außerdem von Google selbst; unabhängige Messungen gibt es bisher von Artificial Analysis (Intelligence Index und Coding Agent Index) und Vals AI.
Was dieser Artikel zusätzlich liefert: eine eigene Kostenrechnung für drei Nutzungsszenarien vor und nach dem 1. Dezember, eine Benchmark-Tabelle, die Herstellerangaben und unabhängige Messungen trennt, und die konkreten Wege, Neon auf dem Mac zu nutzen. Die Rohdaten stehen als CSV zum Download bereit.
Das Wichtigste in Kürze
- Preis: 3 $ Input, 15 $ Output, 0,15 $ Cache-Input pro 1 Mio. Tokens. Das ist doppelt so teuer wie Hydrogen und 25 % günstiger als Carbon ab dem 1. Dezember 2026.
- Bis 30.11.2026 kostet Carbon nur 2 $/10 $ – bei gleichem Token-Volumen ist Neon in diesem Zeitraum 1,5-mal so teuer.
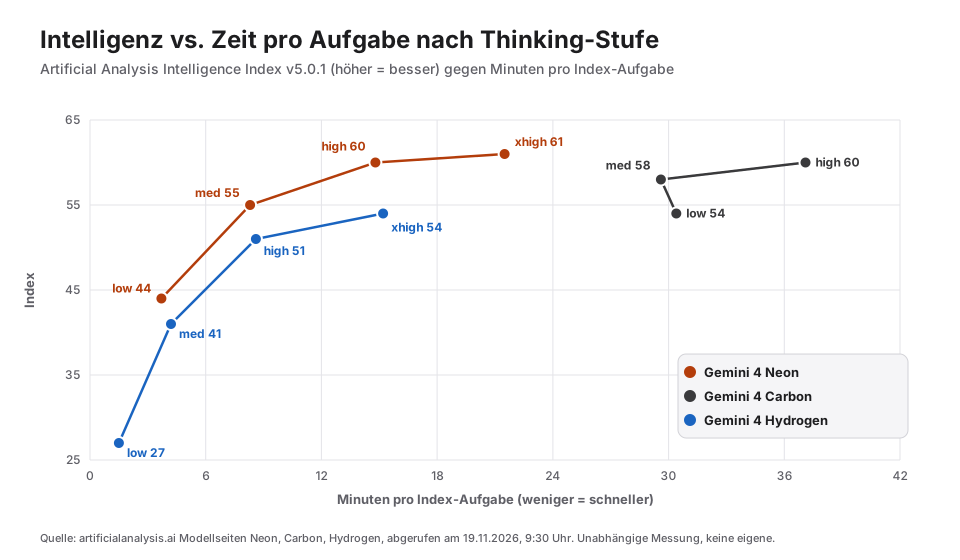
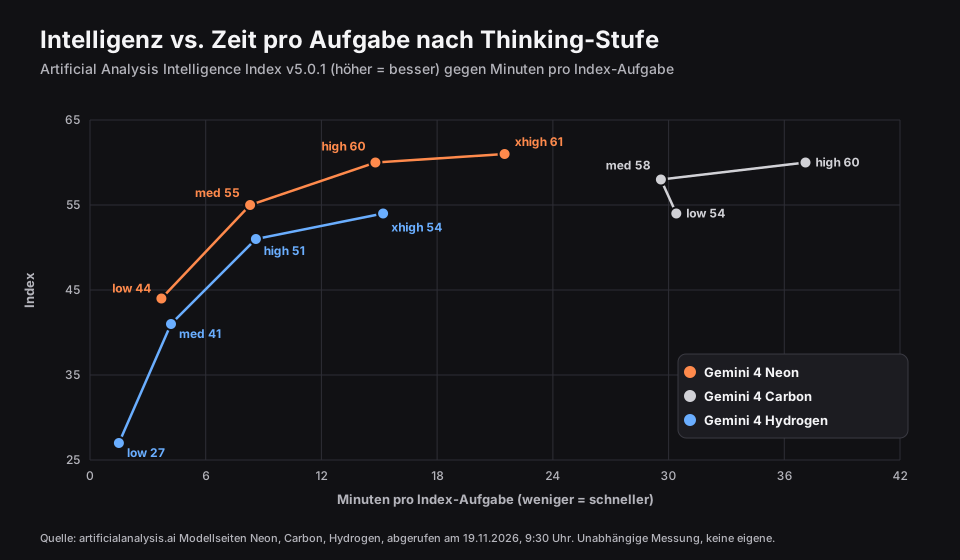
- Unabhängig gemessen: 61 Punkte (xhigh) und 60 Punkte (high) im Artificial Analysis Intelligence Index; Carbon (high) erreicht ebenfalls 60, braucht dafür aber laut derselben Quelle 37,1 statt 14,8 Minuten pro Aufgabe.
- Vals Index: 70,87 % und Platz 2, 0,44 Prozentpunkte hinter Claude Fable 5.2 bei 41 % von dessen Kosten pro Test.
- Coding-Agenten: Platz 1 im Artificial Analysis Coding Agent Index (58,64 in Antigravity CLI,
xhigh) – allerdings nur 0,17 Punkte vor Claude Fable 5.2 und bei 6,86 $ statt 15,47 $ pro Aufgabe.- Ersetzt Argon und Gemini 3.1 Pro: In der Gemini-App heißt Neon jetzt „Deeper analysis“; Google empfiehlt Neon auch in der API als Nachfolger beider Modelle.
- Mac: Neon läuft nur in der Cloud. Zugang über die Gemini-App für Mac (macOS 15+), Antigravity (App ab macOS 13 und CLI) oder die API.
Gemini 4 Neon auf einen Blick
Tabelle 1: Technische Eckdaten von Gemini 4 Neon (Stand 19.11.2026)
| Merkmal | Wert | Quelle |
|---|---|---|
| Hersteller | Google DeepMind | Modellkarte |
| Veröffentlichung | 18.11.2026 | Google-Blog |
| API-Modell-ID | gemini-4-neon | AI-Studio-Doku |
| Herkunft | laut Modellkarte aus Gemini 4 Carbon abgeleitet; Architektur nicht offengelegt | Modellkarte |
| Kontextfenster | 1.048.576 Tokens, gemeinsam für Input, Thinking und Output | AI-Studio-Doku |
| Output pro Aufruf | 65.536 Tokens synchron; mehr nur im Hintergrundmodus (background: true) bis Kontextgrenze | AI-Studio-Doku |
| Eingaben | Text, Bild, Audio, Video (Dokumente wie PDF) | Modellkarte, The Decoder |
| Ausgabe | nur Text | Modellkarte |
| Thinking-Stufen | low, medium, high (Standard), xhigh | AI-Studio-Doku |
| Wissensstand | März 2026 | Modellkarte |
| Preis (API, USD/1 Mio. Tokens) | 3,00 Input · 0,15 Cache-Input · 15,00 Output | Google-Blog |
| Free Tier | nein | AI-Studio-Doku |
| Lokale Nutzung | nein, keine offenen Gewichte | Modellkarte (Vertrieb nur über Google-Dienste) |
Einordnung: vier Gemini-4-Modelle in sieben Wochen
Neon ist laut Artificial Analysis Googles viertes Modell innerhalb von sieben Wochen. Die Reihenfolge:
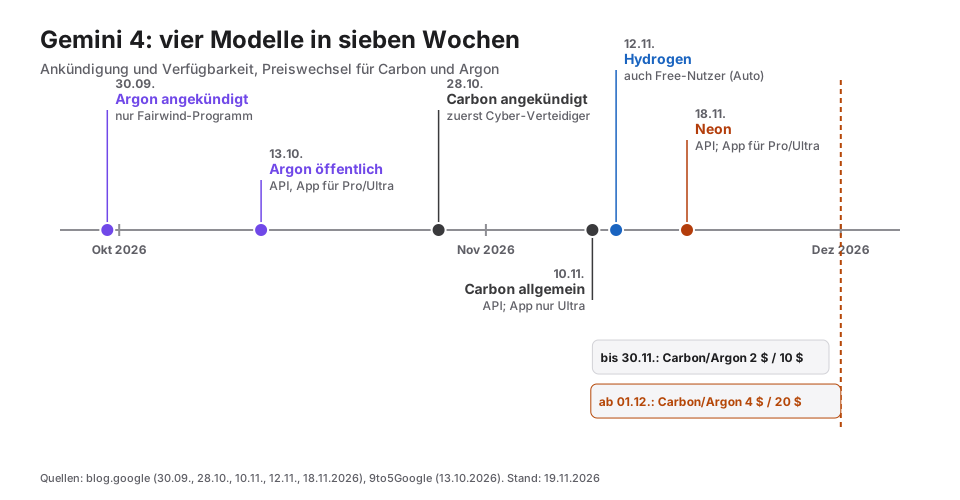
Google beschreibt die Rollen so: Carbon für die schwersten Langzeitprojekte, Hydrogen für schnelle Alltagsausführung, Neon als Ausgleich zwischen Tiefe und Effizienz (Google). In Googles Cloud-Doku ist Neon ausdrücklich das Upgrade-Ziel für Gemini 3.1 Pro und für allgemeine Coding- und Analyse-Workloads auf Gemini 4 Argon (Google Cloud). In der Gemini-App für AI Pro und Ultra besteht die Modellauswahl seit dem 18.11. laut 9to5Google aus Auto, Hydrogen („Everyday help“), Neon („Deeper analysis“) und Carbon („Code & complex work“); Argon und Gemini 3.1 Pro sind dort entfallen.
Die Namen sagen nichts über die Größe aus. Das sorgt für Verwirrung: In der Diskussion auf Hacker News war die Elementbenennung der meistgenannte Kritikpunkt.
Verwechslungsgefahr: „Neon“ ist im KI-Umfeld doppelt belegt. Der Postgres-Anbieter Neon betreibt ein eigenes AI Gateway, über das Gemini-Modelle verfügbar sind – das hat mit dem Google-Modell nichts zu tun. Und im Mai 2026 tauchte „Neon“ laut Gizchina unter Berufung auf 9to5Google als interner Codename für eine geplante Abo-Stufe („Google AI Ultra Lite“) im Code der Gemini-Mac-App auf. Gemeint ist hier ausschließlich das Modell gemini-4-neon.
Gemini 4 Neon Preise im Vergleich
Tabelle 2: API-Listenpreise pro 1 Mio. Tokens in USD (Standard-Tarif, ohne Steuern, abgerufen am 19.11.2026)
| Modell | Input | Cache-Input | Output (inkl. Thinking) | Gültig | Quelle |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | 1,50 | 0,075 | 7,50 | seit 12.11.2026 | |
| Gemini 4 Neon | 3,00 | 0,15 | 15,00 | seit 18.11.2026 | |
| Gemini 4 Carbon (Einführung) | 2,00 | 0,10 | 10,00 | bis 30.11.2026 | |
| Gemini 4 Carbon (Standard) | 4,00 | 0,20 | 20,00 | ab 01.12.2026 | |
| Claude Opus 5.5 (Referenz) | 4,00 | 0,20 | 20,00 | – | Anthropic |
| GPT-6.2 Sol (Referenz) | 2,00 | 0,10 | 10,00 | – | OpenAI |
Alle Gemini-Preise inklusive Cache-Preise laut Google-AI-Studio-Preisseite, abgerufen am 19.11.2026. Es sind US-Dollar-Listenpreise, keine Euro-Bruttopreise; Abrechnung und Umsatzsteuer hängen vom Google-Cloud-Konto ab. Anthropic berechnet zusätzlich Cache-Schreibvorgänge; Gemini 4 nutzt nur implizites Caching ohne Schreibgebühr. Ein reiner Token-Preisvergleich zwischen Anbietern sagt deshalb wenig über die Kosten pro gelöster Aufgabe.
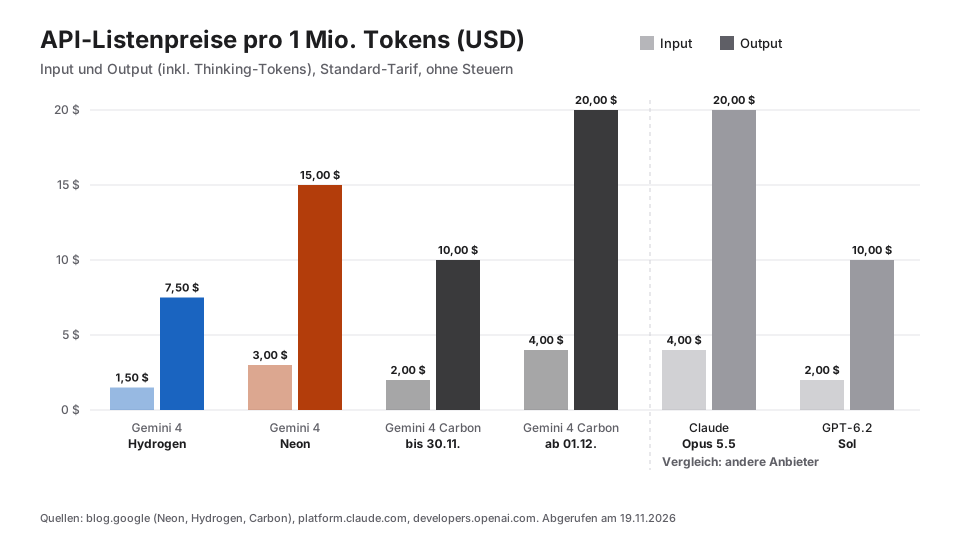
Tabelle 2b: Gemini 4 Neon nach Verarbeitungsart (USD pro 1 Mio. Tokens, Google, abgerufen am 19.11.2026)
| Tarif | Input | Cache-Input | Output inkl. Thinking |
|---|---|---|---|
| Standard | 3,00 | 0,15 | 15,00 |
| Batch | 1,50 | 0,075 | 7,50 |
| Flex | 1,50 | 0,075 | 7,50 |
| Priority | 5,40 | 0,27 | 27,00 |
Batch und Flex halbieren den Preis, laufen aber nicht interaktiv. Für Coding-Agenten, die auf eine Antwort warten, ist Standard der realistische Tarif. Grounding mit der Google-Suche ist bis 5.000 Anfragen pro Monat frei (geteilt über alle Gemini-3- und neueren Modelle), danach kostet es 14 $ pro 1.000 Anfragen.
Der Preiswechsel am 1. Dezember entscheidet
Weil alle Gemini-4-Modelle Input und Output im selben Verhältnis (1 : 5) und Cache-Input mit 95 % Rabatt bepreisen, hängt das Kostenverhältnis zwischen ihnen nicht vom Cache-Anteil oder vom Verhältnis Input zu Output ab. Bei identischem Token-Verbrauch gilt immer (eigene Berechnung):
- Neon : Hydrogen = 2,0
- Neon : Carbon bis 30.11. = 1,5
- Neon : Carbon ab 01.12. = 0,75
Der Unterschied in der Praxis entsteht deshalb fast nur durch die Zahl der Tokens, die ein Modell für dieselbe Aufgabe verbraucht. Laut Artificial Analysis erzeugt Neon pro Aufgabe rund 15 % mehr Output-Tokens als Carbon (OfficeChai über Artificial Analysis). Bei einer stark Output-lastigen Aufgabe liegt Neon damit ab dem 1. Dezember bei etwa 86 % der Carbon-Kosten statt bei 75 %, bis zum 30. November bei etwa 173 % (eigene Berechnung: 1,5 × 1,15 bzw. 0,75 × 1,15).
Eigene Rechnung: Was Neon im Monat kostet
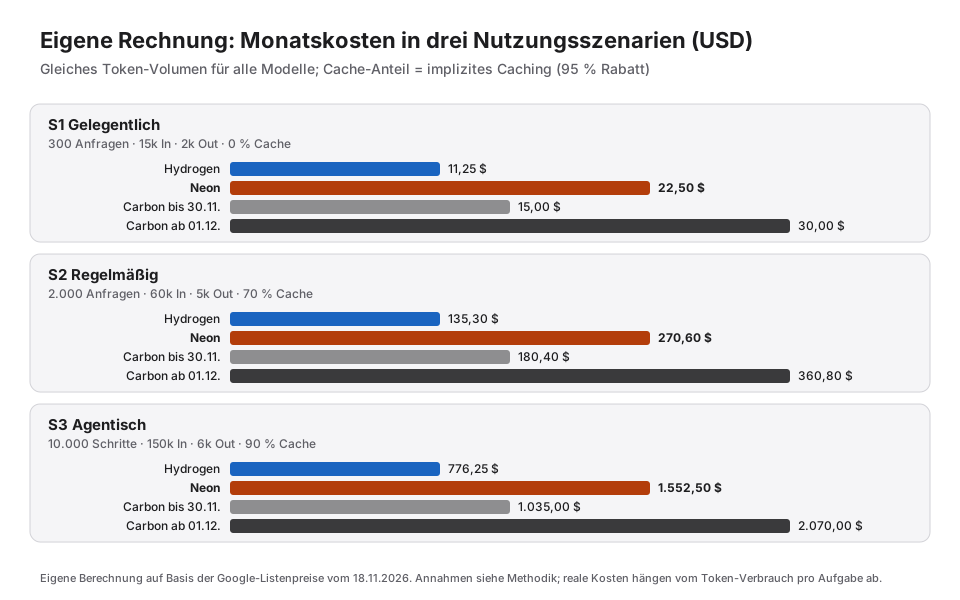
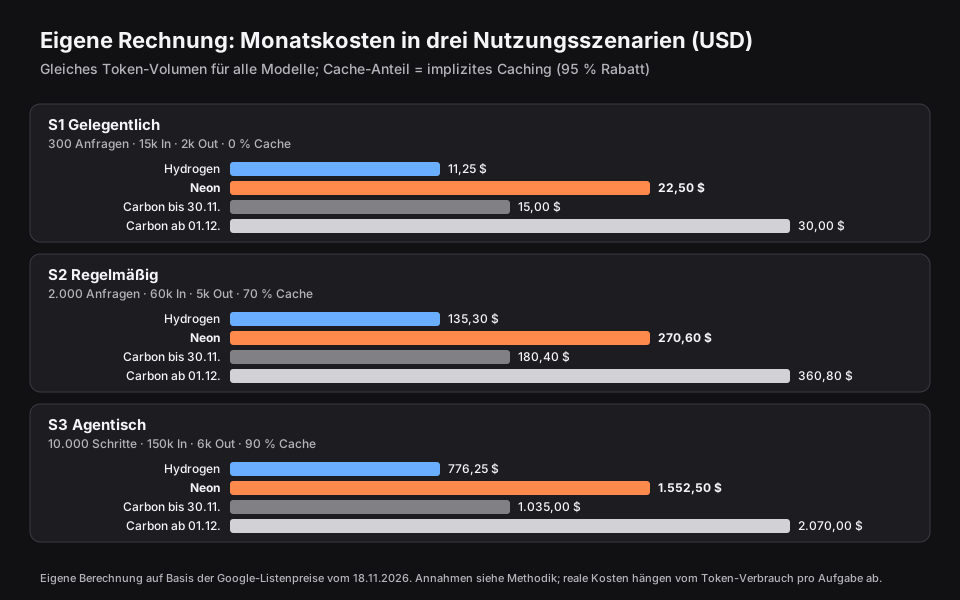
Die folgenden drei Szenarien sind eigene Beispielrechnungen, keine Messungen. Sie zeigen Größenordnungen für typische Einsatzarten.
Tabelle 3: Monatskosten in USD bei identischem Token-Volumen (eigene Berechnung, Preise vom 18.11.2026)
| Szenario | Annahmen pro Monat | Hydrogen | Neon | Carbon bis 30.11. | Carbon ab 01.12. |
|---|---|---|---|---|---|
| S1 Gelegentlich | 300 Anfragen × 15.000 Input / 2.000 Output, kein Cache | 11,25 | 22,50 | 15,00 | 30,00 |
| S2 Regelmäßig (Coding mit Repo-Kontext) | 2.000 × 60.000 Input / 5.000 Output, 70 % Cache | 135,30 | 270,60 | 180,40 | 360,80 |
| S3 Agentisch (lange Agenten-Läufe) | 10.000 Schritte × 150.000 Input / 6.000 Output, 90 % Cache | 776,25 | 1.552,50 | 1.035,00 | 2.070,00 |
Methodik der Rechnung
Formel: Kosten = (ungecachter Input × Inputpreis + gecachter Input × Cachepreis + Output × Outputpreis) / 1.000.000. Beispiel S2 Neon: 120 Mio. Input-Tokens, davon 84 Mio. gecacht → 36 × 3,00 $ + 84 × 0,15 $ + 10 × 15,00 $ = 108,00 $ + 12,60 $ + 150,00 $ = 270,60 $. Annahmen: Output enthält Thinking-Tokens; implizites Caching greift laut Google erst ab 4.096 Tokens Prompt-Länge und ist nicht garantiert; keine Grounding-Gebühren, keine Steuern, Standard-Tarif (Batch/Flex wären halb so teuer). Rundung auf zwei Nachkommastellen. Mögliche Abweichung: Bei
xhighsteigt der Output-Verbrauch stark (siehe Benchmarks). Realistisch sind ±50 % je nach Thinking-Stufe und Aufgabe.
Abo statt API? Für Einzelpersonen kann ein Abo günstiger sein: Google AI Pro kostet in Deutschland 21,99 € im Monat (Google-Abo-Seite, Preis zuletzt am 19.11.2026 geprüft). Neon ist darin in der Gemini-App und in Antigravity enthalten – allerdings mit Nutzungslimits, die Google nicht in Tokens angibt. Wer mehrere Stunden am Tag Agenten laufen lässt, stößt eher an diese Limits als an eine Kostengrenze. Unsere Gemini-API-Kostenübersicht und der Gemini-Abo-Vergleich helfen bei der Abwägung.
Download: gemini-4-preise-szenarien.csv – Preise, Annahmen und Ergebnisse zum Nachrechnen mit eigenen Werten.
Benchmarks: Was unabhängig belegt ist
Google veröffentlicht zum Start eine lange Liste von Bestwerten. Für eine Entscheidung zählt, wer gemessen hat und unter welchen Bedingungen. Die Tabelle trennt deshalb Herstellerangaben von Drittmessungen.
Tabelle 4: Ausgewählte Benchmark-Ergebnisse von Gemini 4 Neon (Stand 19.11.2026)
| Benchmark | Neon | Vergleich | Gemessen von | Einstellung |
|---|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0.1 | 61 (xhigh), 60 (high), 55 (medium), 44 (low) | Carbon (high) 60, Hydrogen (xhigh) 54, Argon 50 | Artificial Analysis | je Thinking-Stufe |
| Zeit pro Index-Aufgabe | 14,8 min (high), 21,5 min (xhigh) | Carbon (high) 37,1 min (am 18.11. noch 34,2 min) | Artificial Analysis (Neon, Carbon) | – |
| Kosten pro Index-Aufgabe | 6,44 $ (xhigh); 3,74 $ (high), 1,90 $ (medium), 0,75 $ (low)² | Carbon 7,76 $ zum Standardpreis² | Artificial Analysis | Listenpreise |
| Vals Index v2.2 | 70,87 % (Platz 2 von 42), 7,41 $/Test | Claude Fable 5.2: 71,31 %, 17,94 $/Test; laut Googles Tabelle Claude Opus 5.5 70,1 %, GPT-6.2 Sol 66,1 % | Vals AI | xhigh |
| Legal Research Bench / Tax Agent Bench | 56,25 % / 54,89 %, jeweils Platz 1 | – | Vals AI | xhigh |
| Terminal-Bench 4.0 | 61,62 % (Platz 7 von 69) | – | Vals AI | xhigh |
| Terminal-Bench 4.1 | 65,2 % | – | nicht angegeben | |
| CursorBench 4.1 | 65,4 % | Claude Opus 5.5: 58,1 % | Google (laut TestingCatalog) | nicht angegeben |
| Agent Arena | 1.336 Punkte, Platz 2, ca. 4.200 Sitzungen | – | Arena (von Google zitiert) | – |
| Artificial Analysis Coding Agent Index v2.1 | 58,64, Platz 1 (Antigravity CLI) | Claude Fable 5.2 (xhigh) 58,47 · Claude Opus 5.5 (max) 58,16 · GPT-6.2 Astra (max) 53,47 | Artificial Analysis (gelesen von OrcaRouter) | xhigh |
| Kosten pro Coding-Agent-Aufgabe | 6,86 $ | Claude Opus 5.5 (max) 12,61 $ · Claude Fable 5.2 (xhigh) 15,47 $ | Artificial Analysis | xhigh |
| Ausgabegeschwindigkeit | ca. 110 Tokens/s | Carbon (high) 55 Tokens/s | Artificial Analysis | – |
| GDP.pdf (Dokumentaufgaben) | 33,4 % (high), 28,0 % (xhigh) | Carbon (high) 28,4 % | Artificial Analysis | je Stufe |
| Zapier AutomationBench | 56,3 %, Platz 1 | – | – |
² Laut OfficeChai unter Berufung auf Artificial Analysis. Die Artificial-Analysis-Modellseite von Carbon weist seit dem 19.11. ausdrücklich 7,76 $ auf Basis des Standardpreises (4 $/20 $) aus. Frühere Werte von 5,48 $ (Modellseite am 18.11.) und 4,90 $ (OrcaRouter) beruhen offenbar auf einer anderen Preisbasis; zum aktuellen Einführungspreis wäre Carbon pro Aufgabe günstiger als Neon xhigh. Die Werte für medium und low stammen aus der Auswertung von Ahmet Balaman.
Was die Zahlen sagen – unsere Einordnung:
- Neon high ist der interessanteste Punkt. Laut Artificial Analysis erreicht Neon auf der Standardstufe
highdenselben Indexwert wie Carbon (60), braucht dafür aber 60 % weniger Zeit pro Aufgabe (eigene Berechnung aus 14,8 vs. 37,1 Minuten). Der Sprung aufxhighbringt nur einen Punkt mehr, kostet aber deutlich mehr Output: 283 Mio. statt 123 Mio. Tokens für den gesamten Index. Genau genommen ist der Gleichstand gerundet: Ungerundet liegen Neon (high) bei 59,6 und Carbon (high) bei 60,0 (OrcaRouter über Artificial-Analysis-Daten). - Mehr Denken ist nicht immer besser. Bei den Dokumentaufgaben von GDP.pdf schneidet Neon auf
high(33,4 %) deutlich besser ab als aufxhigh(28,0 %) und auch besser als Carbon (28,4 %) (Artificial Analysis). - Neon ist gesprächig. Artificial Analysis führt Neon bei der Ausführlichkeit auf Platz 93 von 95. Wer nach Tokens bezahlt, sollte
xhighnur gezielt einsetzen. - „Platz 3“ ist eine Frage der Zählweise. Google spricht von Platz 3 im Intelligence Index. Die Artificial-Analysis-Seite listet Neon (xhigh) auf Platz 6 von 96, weil dort jede Thinking-Variante eines Modells separat gezählt wird.
- Vals bestätigt die Kosteneffizienz. Neon liegt nur knapp hinter Claude Fable 5.2, kostet pro Test aber 7,41 $ statt 17,94 $. Der Vals Index gewichtet Finanzaufgaben mit rund 52 % (Vals AI); für reine Coding-Arbeit ist er deshalb nur bedingt aussagekräftig.
- Coding-Agenten: knapp vorn, deutlich günstiger. Im Coding Agent Index liegt Neon nur 0,17 Punkte vor Claude Fable 5.2; Konfidenzintervalle veröffentlicht Artificial Analysis nicht. Der Abstand zu GPT-6.2 Astra (5,17 Punkte) stammt laut OrcaRouter zu 4,2 Punkten aus einem einzigen Teiltest (SWE-Atlas-QnA). Klar ist der Kostenunterschied: 6,86 $ pro Aufgabe gegenüber 15,47 $ bei Fable 5.2 (
xhigh). - Coding-Werte sind schwer vergleichbar. Google meldet 65,2 % auf Terminal-Bench 4.1, Vals misst 61,62 % auf Terminal-Bench 4.0 – das sind unterschiedliche Versionen und Harnesses. CursorBench-Werte stammen nur aus Googles eigener Tabelle.
Was die Benchmarks nicht messen: Verhalten in deinem eigenen Repository, Latenz unter Last zu Spitzenzeiten, Qualität deutschsprachiger Texte und das Verhalten an den Nutzungsgrenzen der Abos.
Technische Details für Entwickler
Die folgenden Punkte stammen aus Googles Entwickler-Doku zu Neon:
- Thinking-Stufe setzen: In der Interactions API über
generation_config: {"thinking_level": "high"}. Erlaubt sindlow,medium,high,xhigh. Der Wertminimalaus Gemini 3.8 Flash führt zu einem Fehler. - Sampling-Parameter entfernen:
temperature,top_pundtop_kwerden ignoriert; Werte außerhalb des erlaubten Bereichs liefern HTTP 400. - Lange Ausgaben: Synchron sind 65.536 Tokens pro Schritt möglich. Für mehr braucht es
background: trueund ein höheresmax_output_tokens. Achtung:max_output_tokensumfasst Thinking und Antwort. - Caching: Nur implizites Caching ab 4.096 Tokens. Explizites Caching (
cachedContents,caches.create) wird nicht unterstützt; altecached_content-Felder entfernen. - Abrechnung: Berechnet werden alle verarbeiteten Tokens, auch Thinking-Tokens, interne Tool-Systemanweisungen und Funktionsdeklarationen. Google-Search-Grounding kostet pro Anfrage extra.
- Timeouts: Google empfiehlt beim Umstieg von 3.8 Flash Client-Timeouts von mindestens 15 Minuten oder den Hintergrundmodus.
- Mehrstufige Gespräche:
previous_interaction_id(Interactions API) oder Thought Signatures unverändert zurückgeben (generateContent).
Umstieg von Carbon oder Argon: Modell-ID ändern genügt. Beachten: Neon startet standardmäßig mit high, Argon und Gemini 3.8 Flash mit medium.
Zusätzlich laut Google-Cloud-Doku (Modellseite): Neon akzeptiert auch Microsoft-Office- und OpenDocument-Dateien, unterstützt Computer Use, Code Execution, Grounding, URL Context und Structured Output. Nicht unterstützt sind Live API, Tuning und RAG Engine. Abgeschlossene Segmente einer langen Ausgabe werden auch dann berechnet, wenn ein späteres Segment fehlschlägt.
Gemini 4 Neon auf dem Mac nutzen
Neon ist ein reines Cloud-Modell. Der Arbeitsspeicher deines Macs spielt deshalb keine Rolle – anders als bei lokalen Modellen, wo RAM die Modellgröße begrenzt.
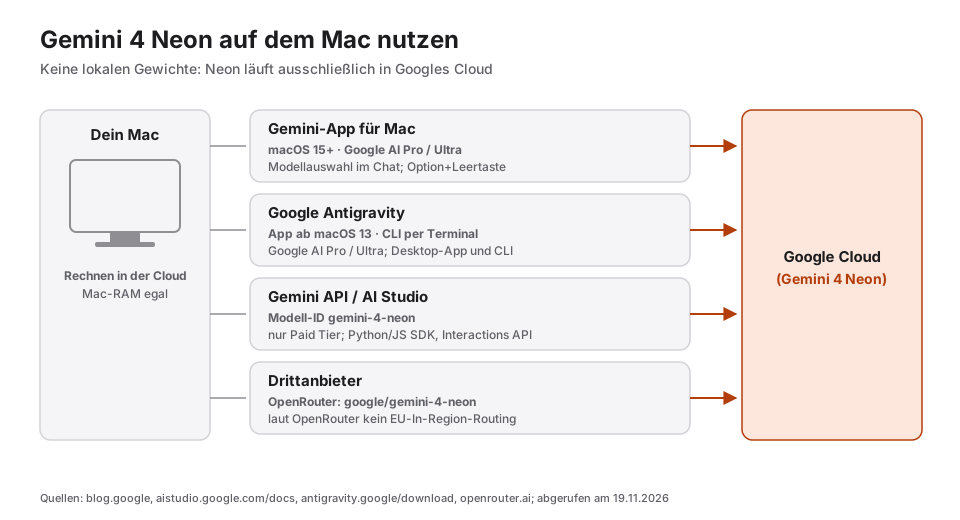
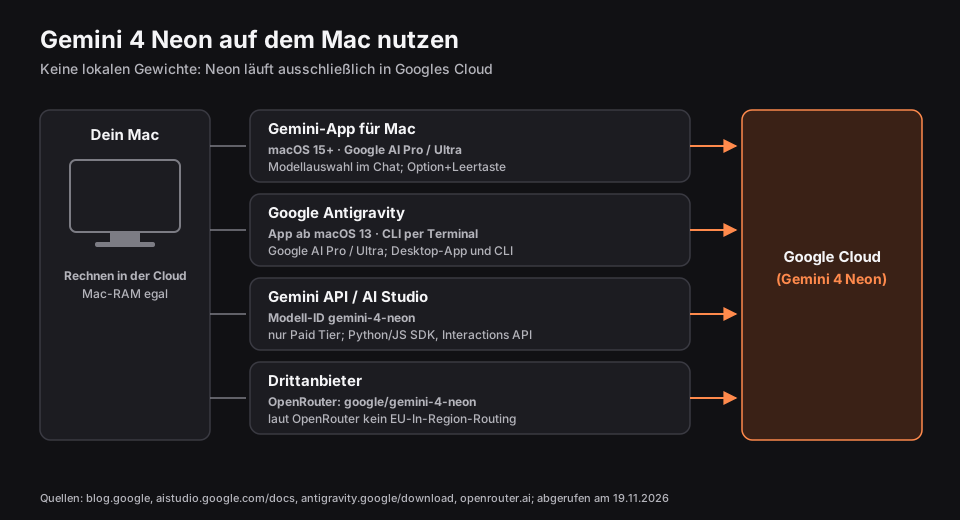
Tabelle 5: Zugangswege zu Neon auf dem Mac (Stand 19.11.2026)
| Weg | Voraussetzung | Für wen | Quelle |
|---|---|---|---|
| Gemini-App für Mac | macOS 15 oder neuer; Google AI Pro oder Ultra; Aufruf per Option + Leertaste | Analyse, Dokumente, Alltag | Google, Google |
| Google Antigravity (App v2.33.0) | macOS 13 oder neuer, Apple Silicon oder Intel; AI Pro/Ultra; auch IDE-Erweiterungen | agentisches Coding; Orchestrator: Neon plant, Hydrogen führt aus | Antigravity-Download, Antigravity-Blog |
| Antigravity CLI (v1.5.11) | Installation: curl -fsSL https://antigravity.google/cli/install.sh | bash | Terminal-Workflows | Antigravity-Download |
| Gemini API / AI Studio | Google-Cloud-Projekt mit aktiver Abrechnung (Paid Tier) | eigene Tools, Skripte | AI-Studio-Doku |
| OpenRouter | Modell google/gemini-4-neon, gleiche Listenpreise | Multi-Anbieter-Setups | OpenRouter |
Wer Daten nicht in eine Cloud geben darf oder will, braucht ein lokales Modell. Einstiegspunkte: Ollama auf dem Mac mini M4 einrichten, die besten offenen LLMs 2026 und LM Studio vs. Ollama.
Datenschutz, EU und Sicherheit
- Kein Training mit API-Daten im Paid Tier: Laut den Gemini-API-Nutzungsbedingungen (gültig seit 23.03.2026) nutzt Google Prompts und Antworten bezahlter Dienste nicht zur Produktverbesserung. Für Missbrauchserkennung werden sie „für einen begrenzten Zeitraum“ protokolliert; eine genaue Dauer nennt Google dort nicht.
- Grounding: Bei Grounding mit der Google-Suche speichert Google Prompts, Kontext und Ausgabe 30 Tage.
- EWR, Schweiz, UK: Wer API-Clients für Nutzer in diesen Regionen anbietet, darf nur bezahlte Dienste verwenden. Für Neon ist das ohnehin der Fall, weil es keinen Free Tier gibt.
- Datenstandort: Auf Googles Unternehmensplattform (Gemini Enterprise Agent Platform, früher Vertex AI) ist Neon seit dem 18.11. allgemein verfügbar, und zwar global sowie in den Multi-Regionen
usundeu. Die ML-Verarbeitung kann aufeubeschränkt werden; Datenresidenz, CMEK und VPC-SC werden unterstützt. Einschränkung: Laut Google steht das Modell verifizierten Unternehmenskunden „in ausgewählten Regionen“ zur Verfügung, eine einzelne EU-Region wieeurope-westist nicht gelistet (Google Cloud). Über OpenRouter gibt es kein EU-In-Region-Routing (OpenRouter); die Gemini API in AI Studio nennt keinen Datenstandort. - Sicherheitseinstufung: Die Modellkarte übernimmt die Frontier-Safety-Bewertung von Argon. Für Cyber-Fähigkeiten und biologische Risiken heißt es dort, das Erreichen der kritischen Schwelle (CCL) könne „nicht ausgeschlossen“ werden. Google nennt eigene Schutzmaßnahmen und Werte zu Prompt-Injection; das sind Herstellerangaben.
Diese Hinweise ersetzen keine Rechtsberatung.
Welches Gemini-4-Modell passt?
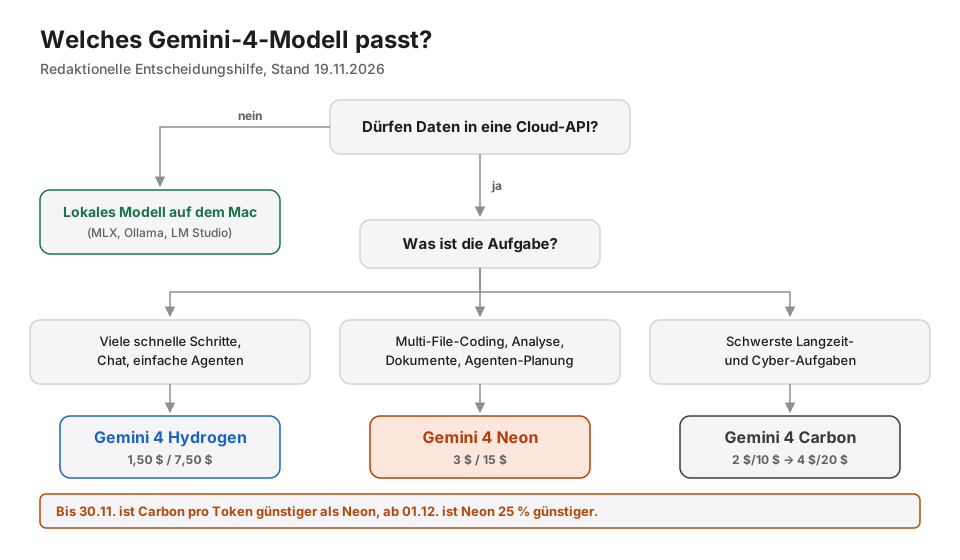
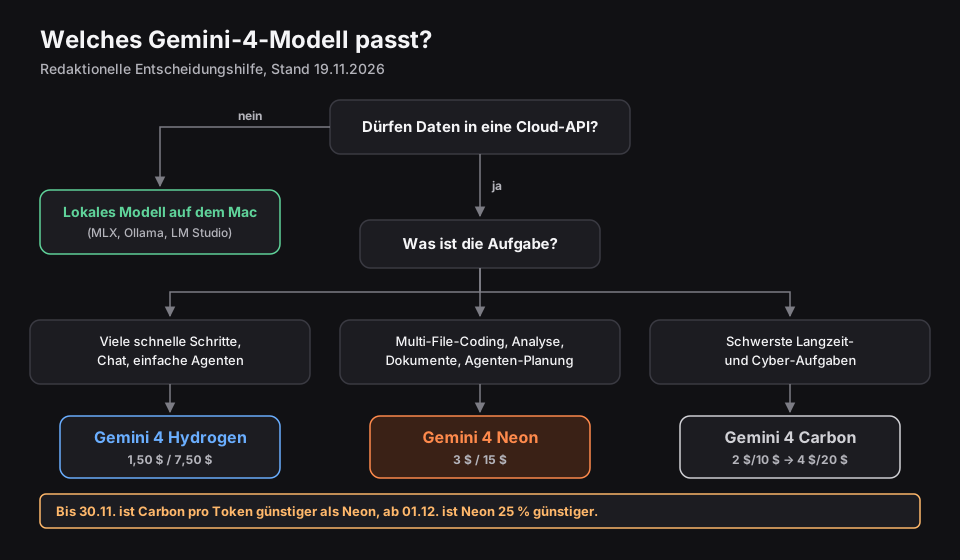
Tabelle 6: Entscheidungsmatrix (redaktionelle Einschätzung auf Basis der genannten Quellen)
| Wenn du … | dann | weil |
|---|---|---|
| viele kurze Agentenschritte oder Chat-Antworten brauchst | Hydrogen | halber Neon-Preis, laut Artificial Analysis rund 165 Tokens/s auf high |
| Multi-File-Coding, Dokumentanalyse oder Agentenplanung machst | Neon (high) | Carbon-Niveau im Index bei weniger als halber Zeit pro Aufgabe |
| bis 30.11. viel Volumen auf Top-Niveau verarbeitest | Carbon testen | 2 $/10 $ sind bis dahin günstiger als Neon |
| lange Coding-Sessions in Antigravity fährst | Orchestrator: Neon + Hydrogen | Neon plant und prüft, Hydrogen erledigt Routineschritte zum halben Preis |
| EU-Datenresidenz brauchst | Neon über Googles Enterprise-Plattform (eu) | AI-Studio-API und OpenRouter bieten das nicht |
| ab 01.12. bisher Carbon nutzt | Neon gegentesten | 25 % niedrigerer Token-Preis |
| Daten nicht in die Cloud geben darfst | lokales Modell | Neon hat keine offenen Gewichte |
Was noch offen ist
- Nutzungslimits im Abo: Wie viele Neon-Anfragen AI Pro und Ultra in App und Antigravity erlauben, nennt Google nicht.
- „32 % günstiger pro Aufgabe als Carbon“: Diese Google-Angabe für die Stufe
highnennt keine Preisbasis. Artificial Analysis hat für Neon in Coding-Agent-Läufen nurxhighgemessen. - Abo-Seite: Googles Abo-Übersicht nannte Neon am 19.11. noch nicht und war bei den Modellen je Tarif in sich widersprüchlich (Google).
- Euro-Preise für die API: Google rechnet in US-Dollar ab; einen offiziellen Euro-Preis haben wir nicht gefunden.
Methodik und Änderungsprotokoll
Methodik: Wir haben Gemini 4 Neon nicht selbst getestet. Alle Leistungswerte stammen aus den genannten Quellen; Herstellerangaben sind als solche gekennzeichnet. Preise wurden am 19.11.2026 bei Google, Anthropic und OpenAI abgerufen. Kostenrechnungen sind eigene Berechnungen mit offen gelegten Annahmen. Insgesamt haben wir 40 Quellen geöffnet und geprüft, davon 18 Primärquellen.
Interessenkonflikte: Keine. Dieser Artikel enthält keine Affiliate-Links. Hinweise zu unserer Arbeitsweise: KI-Transparenz.
Korrekturen: Fehler gefunden? Schreib uns über die Kontaktangaben auf der Seite Über AI on Mac.
Änderungsprotokoll
- 19.11.2026: Erstveröffentlichung (Recherchestand 9:30 Uhr, inklusive Coding Agent Index, App-Modellauswahl und EU-Verfügbarkeit auf Googles Enterprise-Plattform).
Weiterlesen auf AI on Mac: Gemini 4 Argon · Gemini 4 Carbon · Gemini 4 Hydrogen · Google Gemini Kosten und Preise 2026 · GPT-6.2 Astra und Sol · Claude Fable 5.2 auf dem Mac
Häufig gestellte Fragen
Was kostet Gemini 4 Neon?
3 $ pro Million Input-Tokens, 0,15 $ pro Million gecachter Input-Tokens und 15 $ pro Million Output-Tokens inklusive Thinking-Tokens (Google, 18.11.2026).
Ist Gemini 4 Neon günstiger als Gemini 4 Carbon?
Erst ab dem 1. Dezember 2026. Bis 30. November kostet Carbon 2 $/10 $ und ist damit pro Token günstiger. Ab Dezember kostet Carbon 4 $/20 $; Neon ist dann pro Token 25 % günstiger.
Gibt es Gemini 4 Neon kostenlos?
Nein. Neon ist im Free Tier der API nicht verfügbar. Für die Gemini-App und Antigravity nennt Google ausschließlich Google AI Pro und Ultra.
Wie groß ist das Kontextfenster?
1.048.576 Tokens, die sich Input, Thinking und Output teilen. Pro synchronem Aufruf sind höchstens 65.536 Output-Tokens möglich.
Kann ich Gemini 4 Neon lokal auf dem Mac ausführen?
Nein. Neon ist nur über Google-Dienste und Drittanbieter-APIs erreichbar. Der Mac dient als Client über die Gemini-App, Antigravity oder eigene API-Skripte.
Welche Thinking-Stufe sollte ich nutzen?
Für die meisten Aufgaben high (Standard). Laut Artificial Analysis bringt xhigh einen Indexpunkt mehr, verbraucht aber mehr als doppelt so viele Output-Tokens.