Google hat Gemini 4 Hydrogen am 12. November 2026 veröffentlicht. Das Modell kostet in der Gemini Developer API 1,50 US-Dollar pro Million regulärer Input-Tokens und 7,50 Dollar pro Million Output-Tokens, einschließlich Thinking. Es ist die auf effiziente Ausführung ausgelegte Variante der Gemini-4-Familie und unterstützt ein gemeinsames Kontextbudget von 1.048.576 Tokens. Für Mac-Nutzer ist es ein Cloud-Modell, kein lokal installierbares LLM. Google-Ankündigung · API-Preise · Cloud-Dokumentation
Stand: 12. November 2026. Diese Analyse stützt sich auf veröffentlichte Dokumentation und externe Benchmarks; wir haben keine eigenen Inferenzmessungen durchgeführt.
Technische Daten und Verfügbarkeit
| Merkmal | Gemini 4 Hydrogen |
|---|---|
| Google-Modell-ID | gemini-4-hydrogen |
| OpenRouter-ID | google/gemini-4-hydrogen |
| Release | 12.11.2026, GA |
| Gemeinsames Kontextbudget | 1.048.576 Tokens |
| Output pro Vordergrundsegment | 65.536 Tokens |
| Thinking | low, medium, high (Standard), xhigh |
| Eingaben | Text, Bilder, Audio, Video, Dokumente |
| Ausgabe | Text |
| Wissensstichtag | März 2026 (Cloud-Dokumentation) |
| Gewichte | Nicht öffentlich verfügbar |
Quellen: Model Card, Cloud-Spezifikation, OpenRouter, Vals AI.
Die Model Card beschreibt Hydrogen als von Carbon abgeleitet. Parameterzahl und detaillierte Architektur wurden in den geprüften Quellen nicht offengelegt. Google nennt das Modell als regulären Nachfolger für viele Einsatzgebiete von Gemini 3.8 Flash. Es ist in Google AI Studio, der Gemini API und dem Enterprise-Angebot verfügbar. In der Gemini-App erhalten kostenlose Nutzer Zugang über die automatische Modellauswahl; ein garantiert manuell auswählbares kostenloses Hydrogen-Kontingent folgt daraus nicht. In Antigravity ist der Zugang für zahlende Google-AI-Pro- und Ultra-Nutzer angekündigt. Entwickler-Ankündigung · Google Search
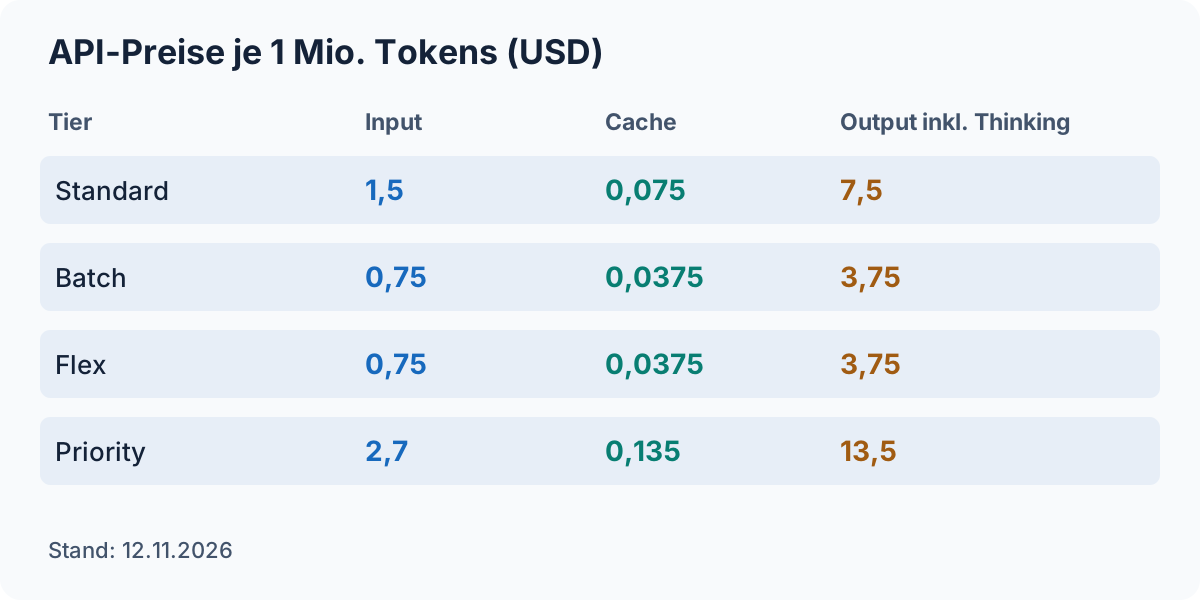
Gemini 4 Hydrogen API-Preise
| Tarif (USD je 1 Mio. Tokens) | Input | Cache-Hit | Output inkl. Thinking |
|---|---|---|---|
| Standard | 1,50 | 0,075 | 7,50 |
| Batch | 0,75 | 0,0375 | 3,75 |
| Flex | 0,75 | 0,0375 | 3,75 |
| Priority | 2,70 | 0,135 | 13,50 |
Quelle: Gemini Developer API – Preisübersicht, abgerufen am 12.11.2026. Listenpreise in USD, ohne individuelle Steuern, Wechselkurs, Gebühren oder zusätzliche Tool-Aufrufe. Für Deutschland sind dies keine Euro-Bruttopreise; Abrechnung und gegebenenfalls Umsatzsteuer hängen vom Anbieter und Konto ab. Batch und Flex haben andere Ausführungsbedingungen; sie sind nicht pauschal Ersatz für interaktives Coding. Der Free Tier ist in der Preisliste ausgewiesen, aber kontingentiert. Rate Limits
Was kosten Agenten mit wiederholtem Kontext?
Für I Millionen gesamte Input-Tokens, H Millionen davon als Cache-Hit und O Millionen Output-Tokens gilt im Standardtarif:
Kosten = 1,50 × (I − H) + 0,075 × H + 7,50 × O.
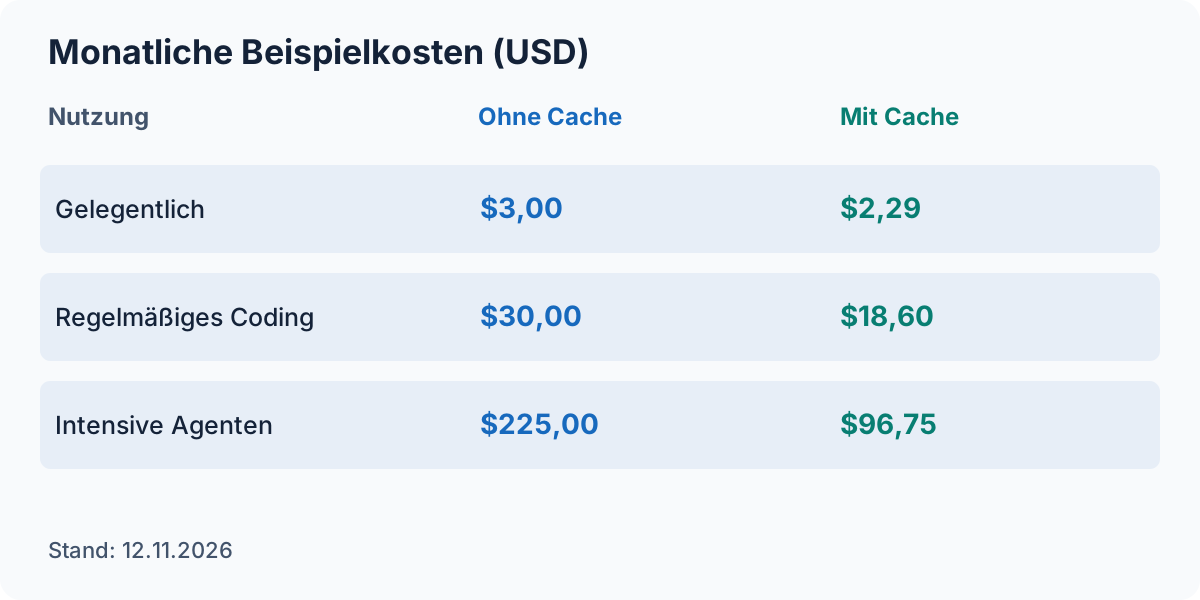
| Monatliches Beispiel | Input (Mio.) | Cache-Hits (Mio.) | Output (Mio.) | Kosten ohne Cache | Mit Cache |
|---|---|---|---|---|---|
| Gelegentlich | 1 | 0,5 | 0,2 | 3,00 $ | 2,29 $ |
| Regelmäßiges Coding | 10 | 8 | 2 | 30,00 $ | 18,60 $ |
| Agenten intensiv | 100 | 90 | 10 | 225,00 $ | 96,75 $ |
Eigene Szenariorechnung, keine Messung oder Prognose einer realen Cache-Quote. Gerundet auf Cent. Output enthält gegebenenfalls interne Thinking-Tokens. Bei identischen Tokenmengen halbiert Batch/Flex die reinen Tokenkosten; Wartezeit und Verfügbarkeit können sich unterscheiden.
Ein Cache-Hit verbilligt den betroffenen Input um 95 Prozent. Die Gesamtrechnung sinkt nicht automatisch um 95 Prozent, denn neue Inputs und generierte Tokens bleiben kostenpflichtig. Google dokumentiert automatisches Caching ab 4.096 gemeinsamen Präfix-Tokens. Für kleine Erweiterungen eines Gesprächs gelten zusätzliche Regeln; das gesamte vorherige Präfix muss nicht vollständig als Hit abgerechnet werden. Prüfe die Usage-Metadaten statt eine Quote anzunehmen. Caching-Dokumentation
Google Search Grounding kann zusätzliche Kosten auslösen: Im bezahlten Standardtarif nennt Google 5.000 kostenlose Suchanfragen pro Monat, gemeinsam für Gemini 3 und neuere Modelle, danach 14 Dollar je 1.000 Suchanfragen. Ein Modellaufruf kann mehrere Suchanfragen auslösen. Grounding · Preise
Hydrogen vs. Carbon und Argon: Dezember ist relevant
| Google Developer API, Standard | Input / Output heute | Ab 1.12.2026 laut Preisliste |
|---|---|---|
| Hydrogen | 1,50 / 7,50 $ | Keine Änderung angekündigt |
| Argon | 2,00 / 10,00 $ | 4,00 / 20,00 $ |
| Carbon | 2,00 / 10,00 $ | 4,00 / 20,00 $ |
Einheit: USD pro Million Tokens. Hydrogen ist bei gleichen ungekachten Input- und Outputmengen derzeit 25 Prozent günstiger als die beiden anderen Modelle. Bei den angekündigten Dezemberpreisen wären es 62,5 Prozent, sofern Hydrogen unverändert bleibt. Gleiche Tokenmengen sind eine Rechenannahme, keine Aussage über Kosten je gelöster Aufgabe. Siehe auch die Faktenchecks zu Gemini 4 Carbon und Gemini 4 Argon. Offizielle Preisliste
Benchmarks: Wo Hydrogen überzeugt und wo nicht
| Test | Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep | 13,5 % | 3,1 % | 5,8 % |
| Terminal-Bench 4.1 (cheating-adjusted) | 57,0 % | 63,9 % | – |
| Agents’ Last Exam v1.1 | 71,6 % | 60,4 % | 69,8 % |
| OSWorld-2.1 (Offline-Teilmenge) | 77,6 % | 83,9 % | 74,2 % |
| HLE-Diamond | 58,8 % | 53,3 % | 47,3 % |
Herstellerdaten aus Googles Model Card, November 2026. Fehlende Werte sind keine Nullwerte. Die Aufgaben messen verschiedene Fähigkeiten und sind nicht zu einer gemeinsamen Rangliste verrechenbar.
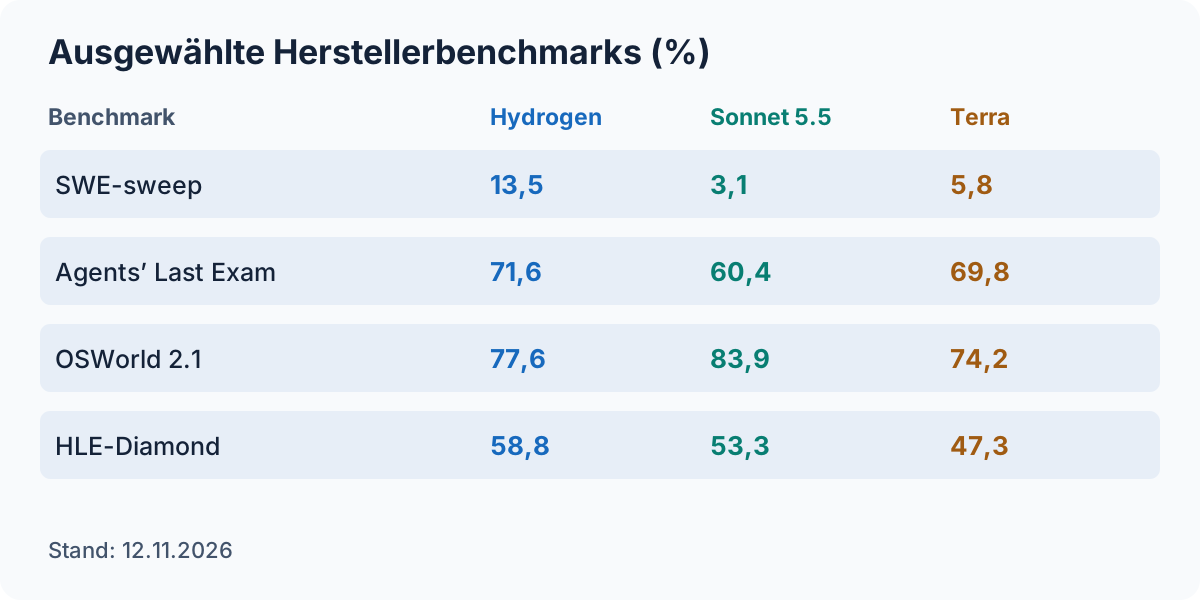
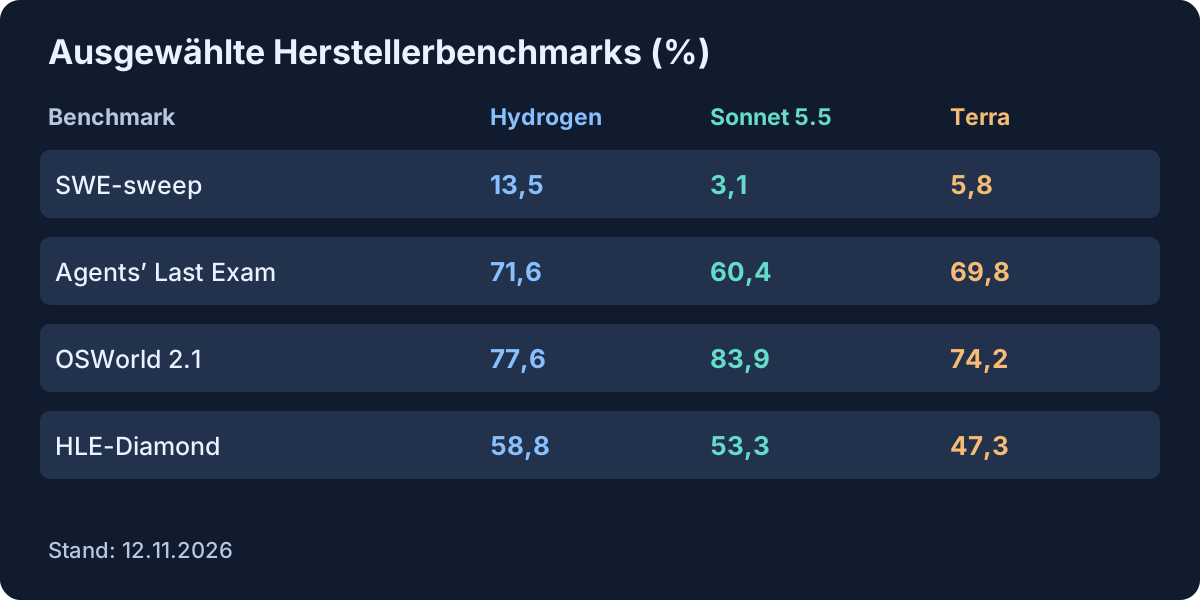
Vals AI veröffentlichte unabhängige Hydrogen-Ergebnisse mit xhigh: 68,49 % im Vals Index (Platz 6 von 37) und 54,04 % im Terminal-Bench 4.0 (Platz 11 von 64). Der Terminal-Bench 4.0 ist nicht dieselbe Version wie Googles 4.1-Test. Google meldet außerdem einen Artificial Analysis Intelligence Index von 51 bei high und 54 bei xhigh, gegenüber 50 für Argon. Ridge dokumentiert 54 als sekundäre Referenz; die AA-Originalseite war bei dieser Recherche nicht zugänglich. Vals AI · Google · Ridge
Die Ergebnisse sprechen für einen Test als allgemeines Arbeitsmodell, nicht für die Behauptung, Hydrogen sei in jedem Coding-Workflow überlegen. Prüfe insbesondere Tests, unerwünschte Codeänderungen und Anzahl der Wiederholungen pro akzeptiertem Patch.
1M Kontext ist nicht 1M Input plus 1M Output
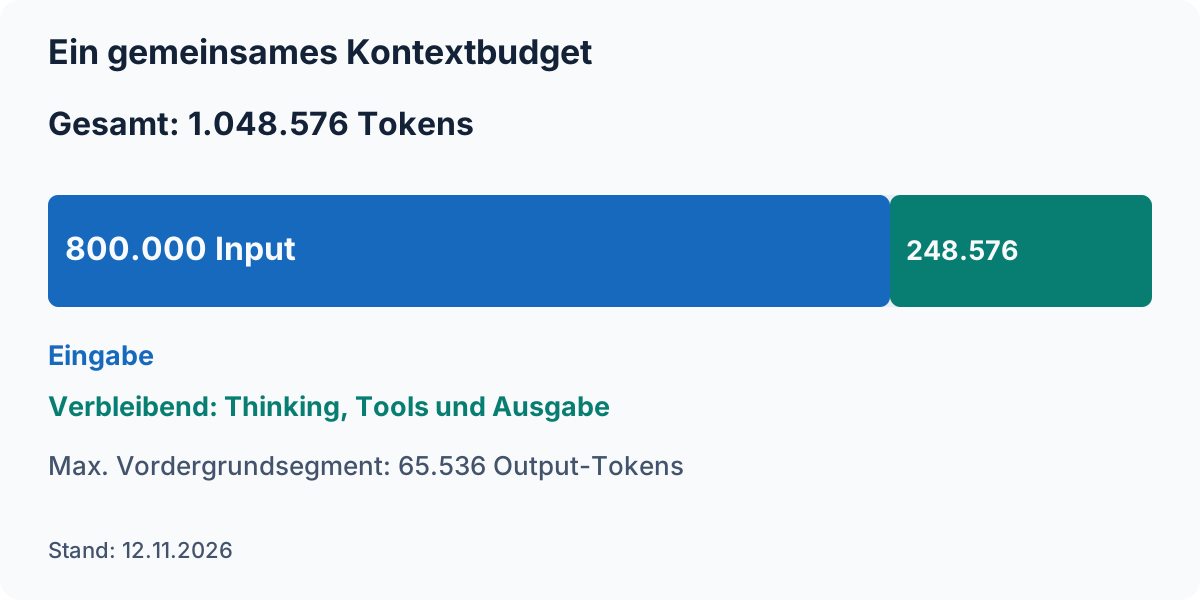
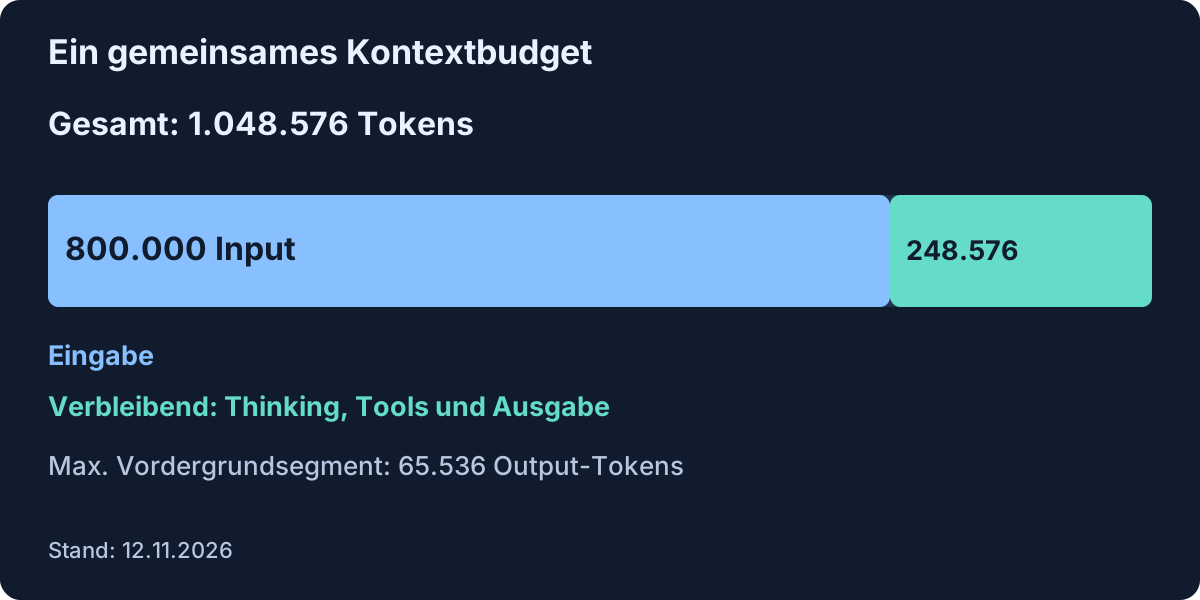
Das gemeinsame Budget zählt Eingabe, Thinking, Tool-Aufrufe und Antwort zusammen. Ein Request mit 800.000 Input-Tokens lässt rechnerisch höchstens 248.576 Tokens für die übrigen Ausgaben. Praktische Grenzen und zusätzliche interne Tokens können den sichtbaren Output weiter verringern. Ein einzelnes Vordergrundsegment ist auf 65.536 Output-Tokens begrenzt. Lange Decodes nutzen unterstützte Continuation-Mechanismen; Google nennt hierfür in Agent Platform die v1beta1-API. Cloud-Spezifikation · Entwicklerleitfaden
Wer von 3.8 Flash migriert, sollte thinking_budget und MINIMAL entfernen, den gewünschten Thinking-Level explizit setzen und die Signaturen vergangener Tool-Aufrufe korrekt erhalten. Die Cloud-Dokumentation nennt feste Sampling-Parameter und eine Mindestankündigungsfrist von 45 Tagen bei Einstellung dieser kurzfristigen GA-Version. Migration · Lifecycle
Hydrogen auf dem Mac einsetzen
Für einen einfachen Test über das Google-SDK (API-Key als Umgebungsvariable, nicht im Repository):
python3 -m venv .venv
source .venv/bin/activate
pip install -U google-genai
export GEMINI_API_KEY='YOUR_API_KEY'
from google import genai
client = genai.Client()
result = client.interactions.create(
model="gemini-4-hydrogen",
input="Suggest three tests for a Python function that parses CSV files."
)
print(result.output_text)Das Beispiel orientiert sich an Googles Textgenerierungs-Dokumentation, wurde hier nicht mit einem Live-Key ausgeführt. Alternativ kann ein OpenRouter-kompatibler Client die Modell-ID google/gemini-4-hydrogen verwenden; die tatsächlich verfügbaren Thinking- und Continuation-Optionen hängen vom Client und Provider ab. Kein Apple-Silicon-Chip kann das proprietäre Modell ohne veröffentlichte Gewichte lokal ausführen. Der Mac führt den Agenten-Client, Editor und Tests aus, während die Modellinferenz remote erfolgt. Für lokale Alternativen ist der MacBook-Pro-Praxischeck relevant.
EU-Region, Datenschutz und Free Tier
Deutschland wird als unterstützte Entwicklerregion geführt. Die Google-Cloud-Modellspezifikation nennt neben global auch eu und us für die ML-Verarbeitung. OpenRouter zeigte am Recherchetag EU-In-Region-Routing für Hydrogen mit Google Vertex zu 1,65/8,25 Dollar je Million Input/Output, Business- oder Enterprise-Tarif und https://eu.openrouter.ai/api/v1. Eine frühere Suchvorschau widersprach der geöffneten Modellseite; deshalb sollte die Region vor dem ersten produktiven Einsatz erneut geprüft werden. Europa im Sinne des Routers umfasst auch UK und Schweiz. OpenRouter-Modellseite · Routing-Dokumentation · Google-Regionen
EU-Verarbeitung allein belegt keine DSGVO-Konformität. Prüfe Verträge, Aufbewahrung, Unterauftragsverarbeiter und konkrete Datenflüsse. Bei der Developer API sind die Bedingungen für unbezahlte und bezahlte Dienste und der EWR-Sonderfall zu beachten; laut den seit 23. März 2026 geltenden Bedingungen gelten die Datennutzungsregeln der Paid Services im EWR, der Schweiz und dem Vereinigten Königreich auch für kostenlose Nutzung. Das ist keine Garantie für EU-exklusive Speicherung: Die Bedingungen erlauben begrenzte Sicherheitsprotokollierung und vorübergehende Speicherung in anderen Ländern. Wer API-Clients Nutzern im EWR, der Schweiz oder im Vereinigten Königreich bereitstellt, darf nur Paid Services verwenden. Gemini API-Bedingungen
Welches Modell für welchen Agenten?
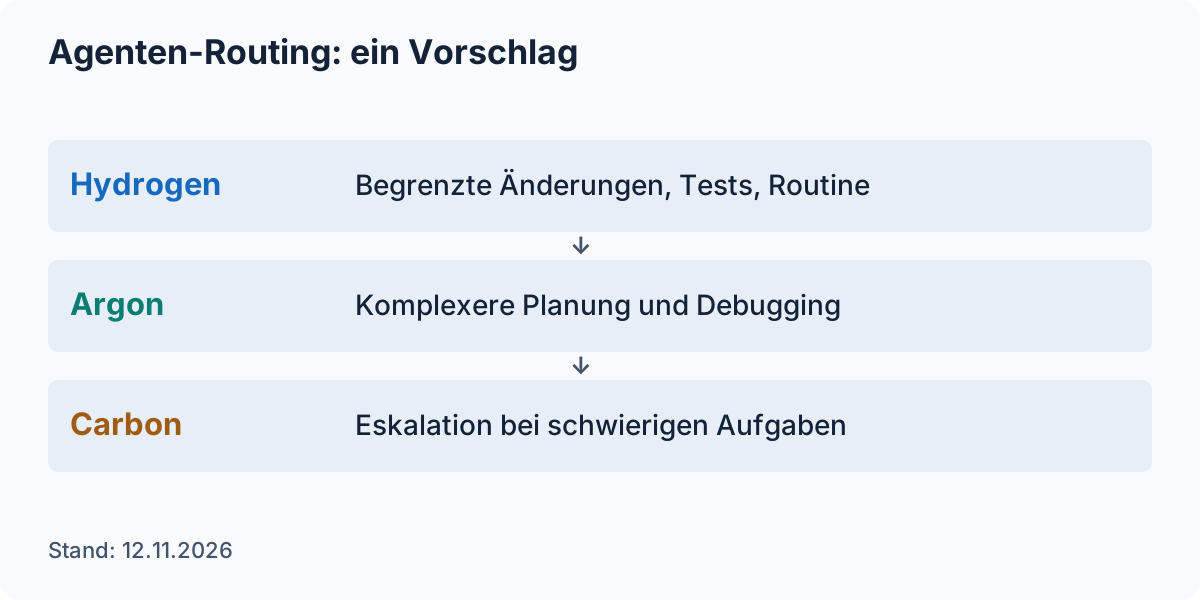
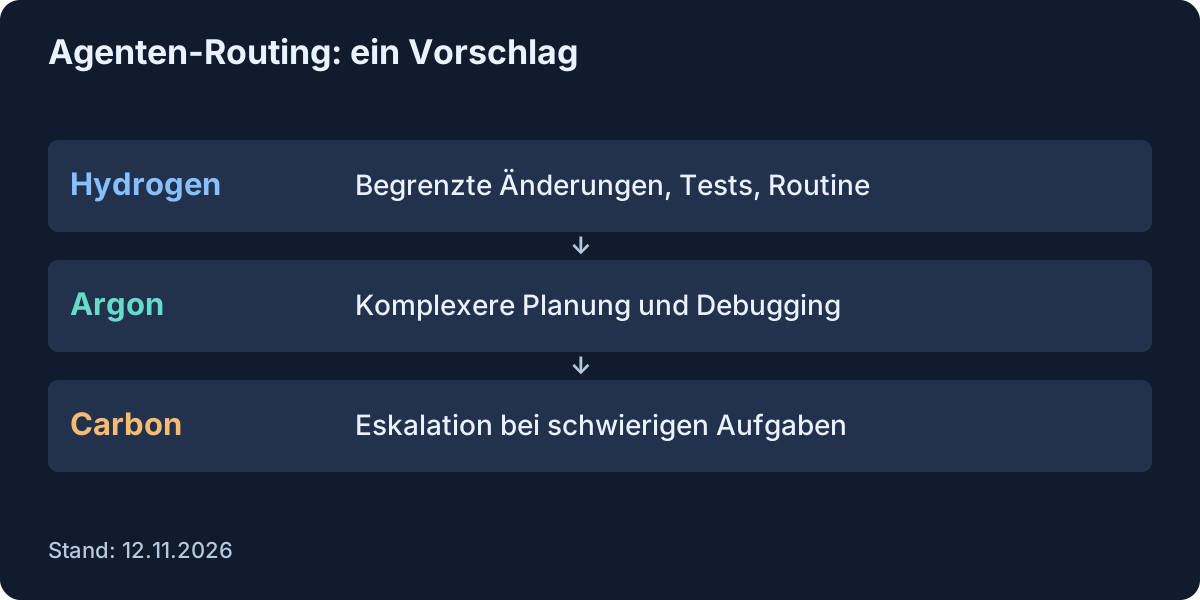
Hydrogen ist ein sinnvoller Startpunkt für begrenzte Implementierungsaufgaben, Tests und wiederholbare Tool-Aufrufe. Argon oder Carbon kommen als Eskalation für schwer auflösbare Architekturentscheidungen infrage. Google meldet für die eigene Antigravity-Orchestrierung auf Terminal-Bench 4.0 24 Prozent weniger Quota-Verbrauch und 19 Prozent kürzere Bearbeitungszeit gegenüber Carbon allein bei ähnlicher Erfolgsrate. Das sind Herstellerdaten eines bestimmten Systems, keine Garantie für andere Agenten. Google-Ankündigung
Für die eigene Evaluation: dieselben zehn repräsentativen Aufgaben mit identischem Repository-Stand und denselben Tools ausführen, Thinking-Level festhalten und akzeptierte Patches, Teststatus, Gesamtkosten, Zeit und Wiederholungen messen. Die aussagekräftigste Kennzahl ist der Preis je akzeptierter Aufgabe, nicht der reine Tokenpreis.
Weitere Orientierung: Gemini-Kosten in Deutschland und Gemini 3.8 Flash im Vergleich.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- blog.google gemini-models / introducing-gemini-4-hydrogen
- aistudio.google.com docs / pricing
- docs.cloud.google.com gemini / 4-hydrogen
- deepmind.google model-cards / gemini-4-hydrogen
- openrouter.ai google / gemini-4-hydrogen
- vals.ai models / google_gemini-4-hydrogen
- blog.google developers-tools / build-with-gemini-4-hydrogen
- blog.google search / gemini-4-hydrogen-search-upgrade
- aistudio.google.com docs / pricing
- aistudio.google.com docs / rate-limits
- aistudio.google.com docs / caching
- aistudio.google.com docs / google-search
- ridgebench.com models / gemini-4-hydrogen
- docs.cloud.google.com guides / gemini-4-hydrogen
- docs.cloud.google.com models / model-versions
- aistudio.google.com docs / text-generation
- openrouter.ai features / in-region-routing
- aistudio.google.com docs / available-regions
- aistudio.google.com docs / terms