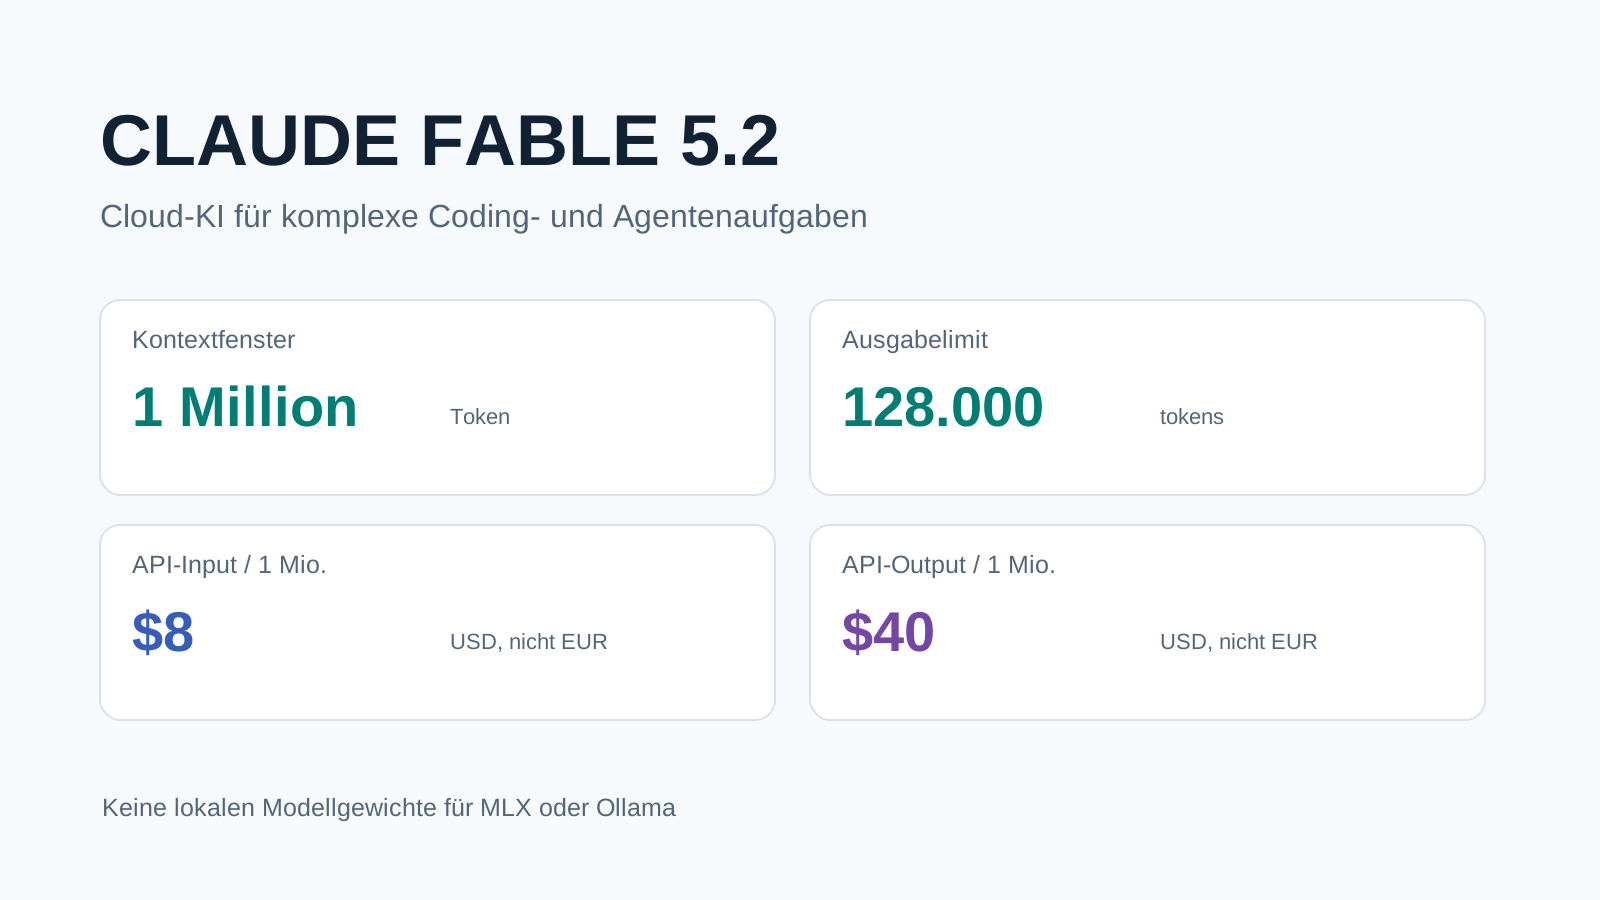
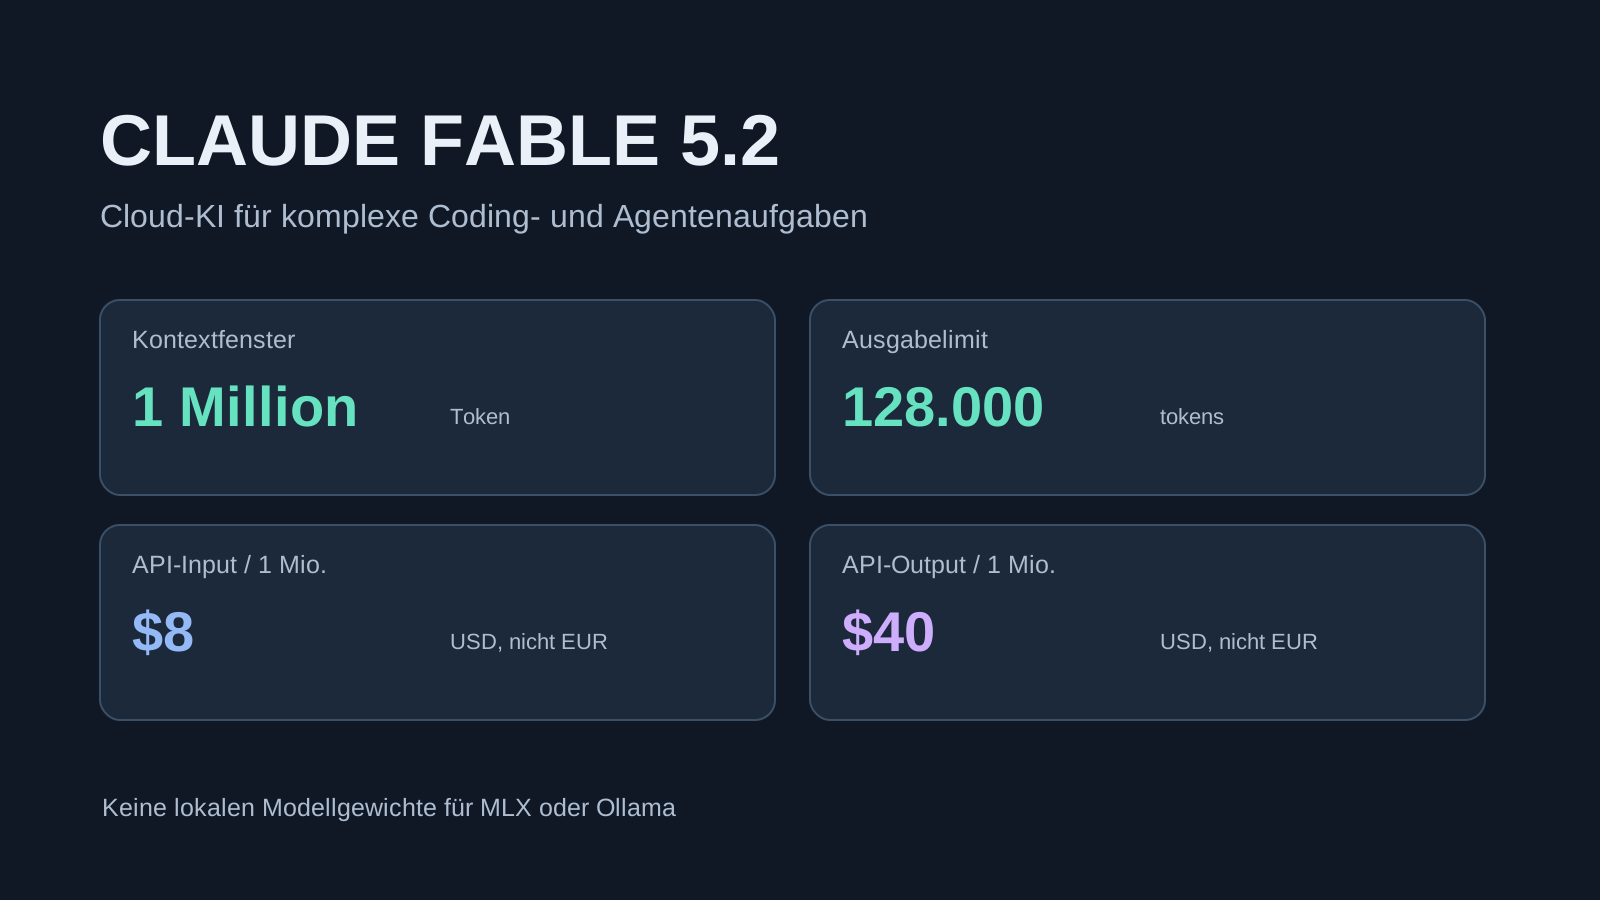
Geprüft am 11. November 2026. Anthropic hat Claude Fable 5.2 am 9. November 2026 veröffentlicht. Das Modell bietet 1 Million Token Kontext, bis zu 128.000 Ausgabe-Token und kostet auf der direkten API 8 US-Dollar pro Million Eingabe-Token und 40 US-Dollar pro Million Ausgabe-Token. Das sind jeweils 20 % weniger als bei Fable 5.1 – aber doppelt so viel wie bei Opus 5.5. Für einen Mac ist Fable 5.2 ein Cloud-Modell, keine lokal installierbare Modellgewicht-Datei. 123
Die wichtigere Frage ist nicht, ob Fable 5.2 auf einem Benchmark vorne liegt, sondern wann ein längerer, teurerer Agentenlauf weniger kostet als mehrere fehlgeschlagene Versuche mit einem günstigeren Modell. Hier vergleichen wir Hersteller- und Fremdmessungen, rechnen drei reale Tokenbudgets durch und erklären die Fallstricke bei API-Integration und Datenschutz.
Die wichtigsten Fakten
| Merkmal | Claude Fable 5.2 | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|
| Veröffentlichung | 09.11.2026 | 01.09.2026 | 22.09.2026 |
| Kontextfenster | 1 Mio. Token | 1 Mio. Token | 1 Mio. Token |
| Max. Ausgabe | 128.000 Token | 128.000 Token | 128.000 Token |
| Frischer Input / 1 Mio. Token | 8,00 $ | 10,00 $ | 4,00 $ |
| Output / 1 Mio. Token | 40,00 $ | 50,00 $ | 20,00 $ |
| 5-Minuten-Cache-Write | 10,00 $ | 12,50 $ | 5,00 $ |
| 1-Stunden-Cache-Write | 16,00 $ | 20,00 $ | 8,00 $ |
| Cache-Read / 1 Mio. Token | 0,20 $ | 0,25 $ | 0,20 $ |
| API-Standard-Effort | high | high | medium |
Datenstand: 11.11.2026; offizielle Listenpreise in USD ohne etwaige Steuern, Provider-Aufschläge und Werkzeugkosten. Quelle: Anthropic. 234
Die gemeinsame Kontextgrenze bedeutet nicht, dass jede Million Kontext-Token automatisch preiswert verarbeitet wird. Tokenmenge, Cache-Trefferquote, Output-Länge und mehrere Agentenschritte bestimmen die Rechnung. Auch 128.000 Output-Token sind ein Limit, kein übliches oder garantiertes Antwortvolumen. 24
Was ist neu gegenüber Fable 5.1?
Anthropic beziffert die Ausgabe-Geschwindigkeit mit bis zu 30 % mehr Tempo gegenüber Fable 5.1. Hinzu kommt ein optionaler Fast Mode mit bis zu 2,5-facher Token-Ausgaberate. Er kostet 16 $ Input und 80 $ Output je Million Token. Der schnellere Modus ändert die Fähigkeiten des zugrunde liegenden Modells nicht und verspricht vor allem schnellere Generierung, nicht unbedingt eine kürzere Wartezeit bis zum ersten Token. 15
Fable 5.2 nutzt adaptives Denken, das sich nicht deaktivieren lässt. low, medium, high, xhigh und max steuern den Aufwand. Für die direkte API empfiehlt Anthropic zunächst high, bevor kostspieligere Einstellungen getestet werden. Bei Aufgaben mit klaren Anforderungen sind Opus 5.5 oder Sonnet 5.5 häufig die vernünftigeren Startpunkte – diese Empfehlung kommt ausdrücklich auch von Anthropic. 136
Benchmarks: Herstellerwerte versus unabhängige Messungen
Anthropics Launch-Tabelle meldet für FrontierCode 2.0 bei xhigh 49,1 % für Fable 5.2 gegenüber 32,4 % für Fable 5.1 und 45,5 % für Opus 5.5. Bei FrontierSWE v2 stehen 69,9 % für Fable 5.2, 56,3 % für Fable 5.1 und 62,3 % für Opus 5.5. Diese Zahlen sind Herstellermessungen mit modell- und testabhängigen Einstellungen – kein selbst durchgeführter Test dieser Website. 1
Auch externe Auswertungen stützen einen Leistungssprung, zeigen aber Grenzen:
| Externe Auswertung | Fable 5.2 | Wichtige Einordnung |
|---|---|---|
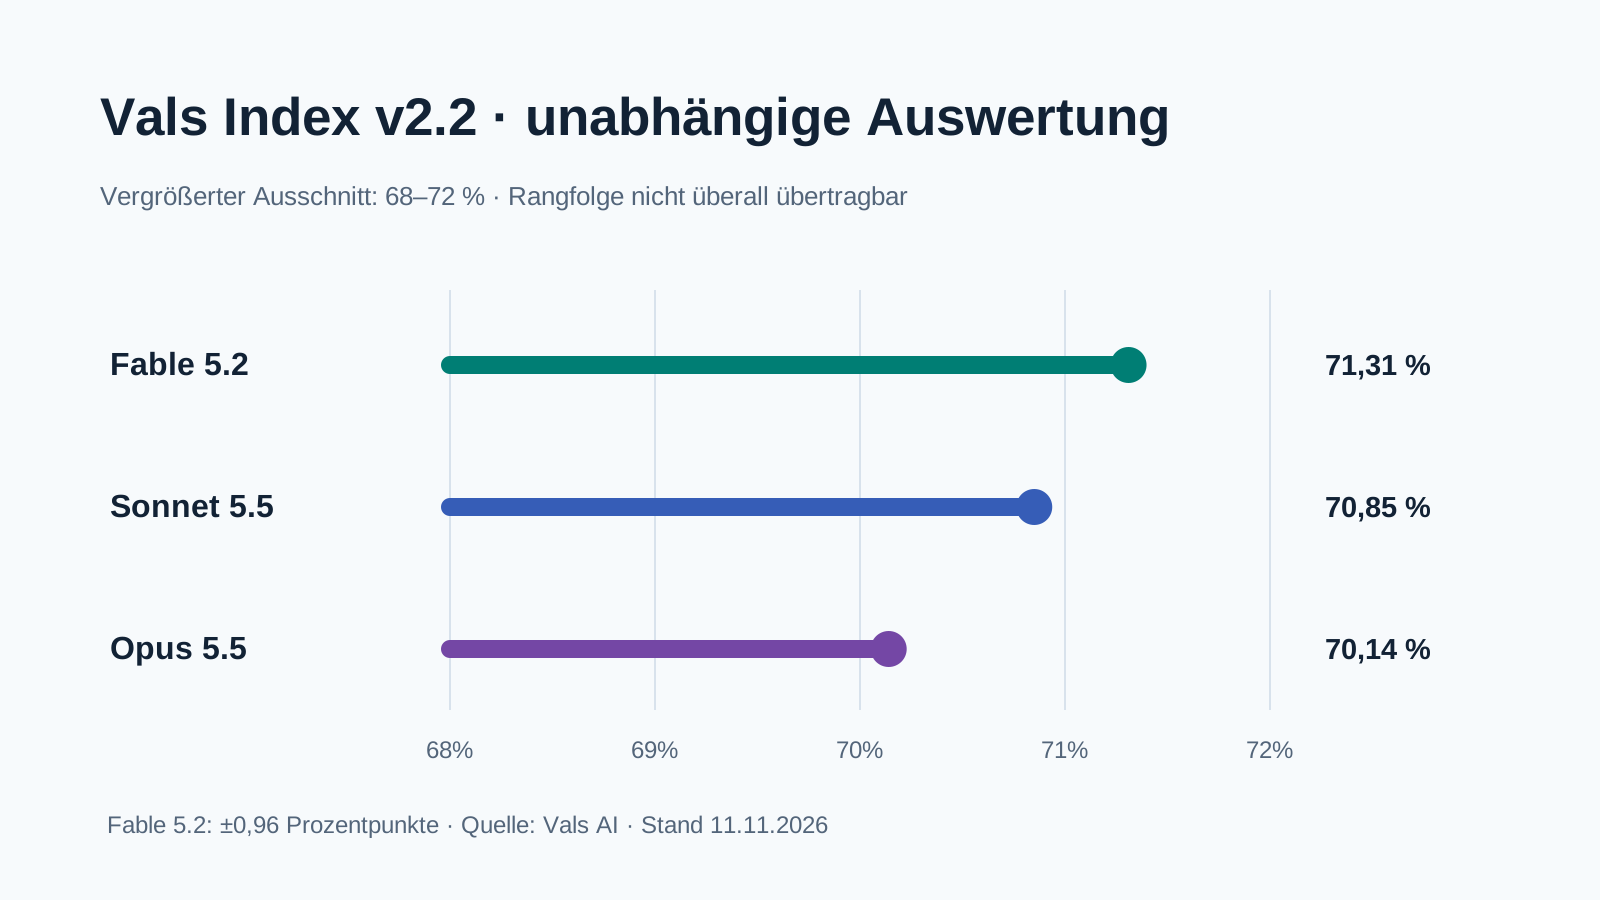
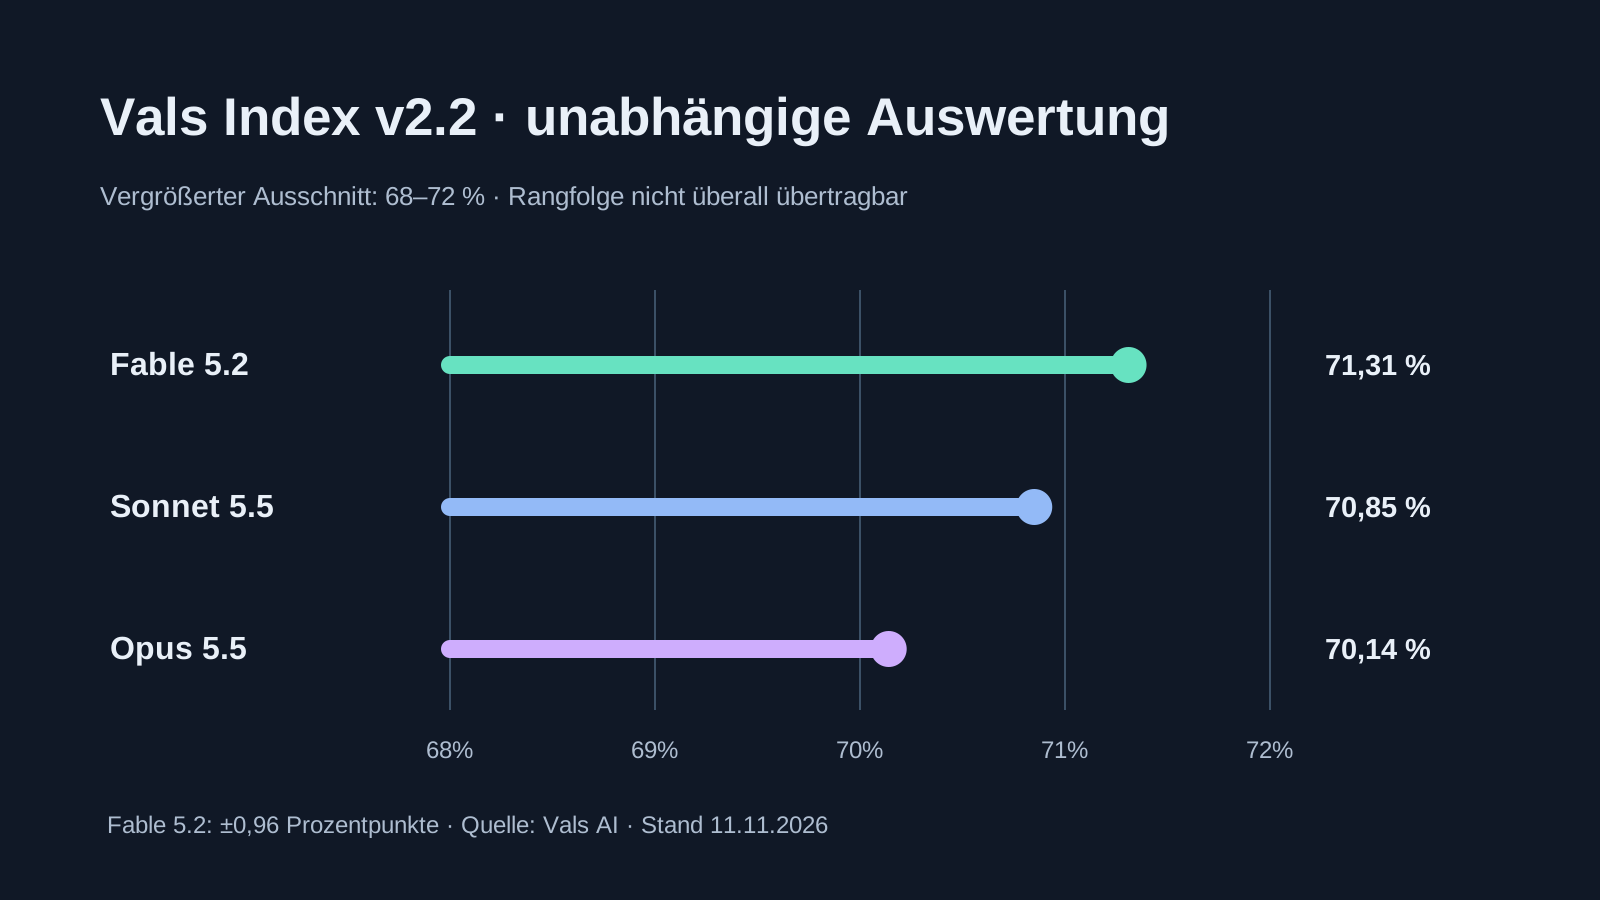
| Vals Index v2.2 | 71,31 % ± 0,96 Prozentpunkte | Platz 1 von 36, Sonnet 5.5 bei 70,85 % – knapper Abstand |
| Vals Vibe Code Bench v1.1 | 93,77 % | Platz 1 von 127 getesteten Systemen |
| Vals SWE-bench Multimodal | 62,29 % | Opus 5.5 liegt dort bei 70,21 % |
Artificial Analysis Intelligence Index v5.0.1 (max, Default-Fallback) | 65 Punkte | Sehr stark, aber etwa 26,54 $ pro Index-Aufgabe |
| Plotly DataAnalyticsBench | 43 von 43 Fragen | Ebenfalls 43/43 für zwei GPT-6-Varianten; Fable-Lauf kostete 35,74 $ |
Quellen: Vals AI, Artificial Analysis und Plotly. Die Untersuchungen haben verschiedene Aufgaben, Harnesses, Effort-Einstellungen und Kostenregeln und dürfen nicht zu einer gemeinsamen Rangliste vermischt werden. 789
Praktische Folgerung: Fable 5.2 ist ein Kandidat für schwer lösbare, lang laufende Aufgaben. Der Sieger eines Gesamtindex muss nicht auch für einen konkreten Repo-Bug, eine Finanzabfrage oder eine wissenschaftliche Pipeline die beste Option sein. Die Ergebnisse von Vals zeigen sogar erhebliche Unterschiede zwischen Kategorien. Ein kleiner kontrollierter A/B-Test auf denselben eigenen Aufgaben bleibt nötig. 7
Was kostet Fable 5.2 bei echter Nutzung?
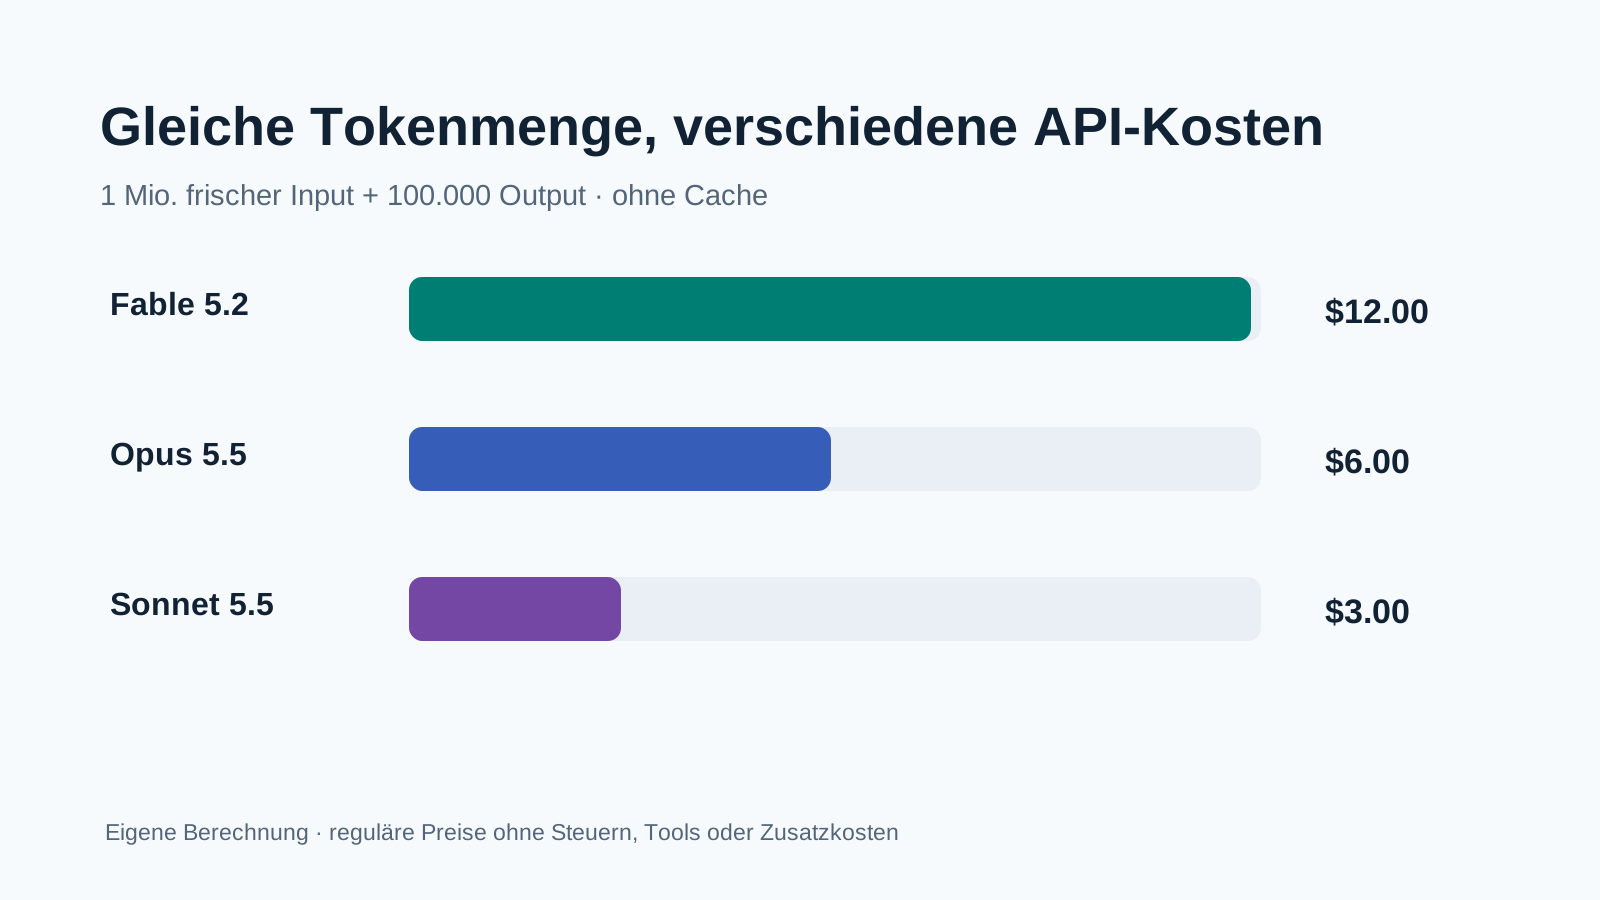
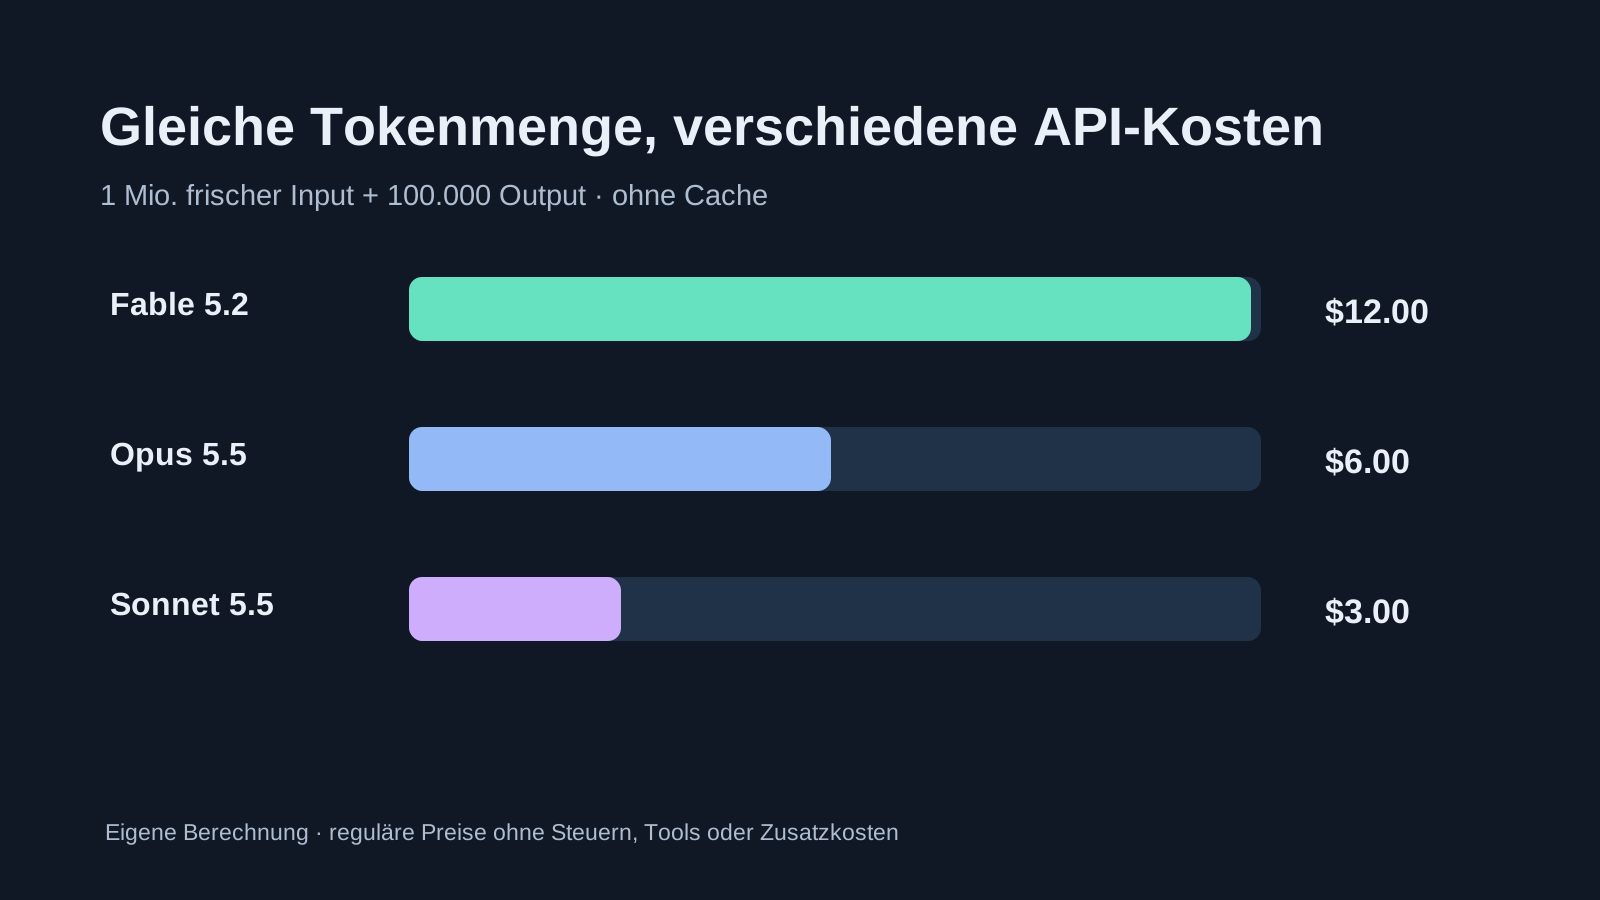
Die folgenden drei Rechnungen benutzen ausschließlich reguläre, ungecachte Tokens. Sie berücksichtigen weder prompt caching noch Tools, Steuern, Langläufe mit wiederholten Anfragen oder zusätzliche Gebühren von Cloud-Routern. Formel: Kosten = Input_Mio × Inputpreis + Output_Mio × Outputpreis.
| Szenario | Tokens Input / Output | Fable 5.2 | Opus 5.5 | Sonnet 5.5 |
|---|---|---|---|---|
| Kurzer Einzelauftrag | 0,10 Mio. / 0,01 Mio. | 1,20 $ | 0,60 $ | 0,30 $ |
| Agentenlauf | 1 Mio. / 0,10 Mio. | 12,00 $ | 6,00 $ | 3,00 $ |
| Hohe Monatsnutzung | 10 Mio. / 1 Mio. | 120,00 $ | 60,00 $ | 30,00 $ |
Eigene Beispielrechnung mit Anthropic-Listenpreisen vom 11.11.2026; keine gemessenen Verbrauchsdaten. 4
Cache kann die Input-Rechnung massiv ändern. Fable 5.2 berechnet nur 0,20 $ je Million gelesener Cache-Token, verglichen mit 8 $ für frischen Input. Aber Cache-Writes kosten 10 $ oder 16 $ je Million Token, und ein Cache-Hit setzt technisch passende, unveränderte Präfixe voraus. Beispiel: Bei 1 Mio. Input-Token, davon 90 % Cache-Reads, plus 100.000 Output-Token entstehen rechnerisch 0,8 $ frischer Input + 0,18 $ Reads + 4 $ Output = 4,98 $. Derselbe Mix kostet mit Opus 5.5 2,58 $. Cache-Writes sind in beiden Zahlen bewusst nicht enthalten. 4
Kosten pro gelöstem Problem können das Bild umkehren: Bei Vals kostete ein gesamter Index-Test für Fable 5.2 ungefähr 17,94 $, während Opus 5.5 dort bei 24,77 $ lag. Das ist eine Messung in diesem Testharness, keine allgemeine Kostengarantie. Bei Artificial Analysis kostete Fable 5.2 in der aufwendigen Max-Konfiguration dagegen 26,54 $ pro Aufgabe. Entscheidend sind Fehlversuche, Zahl der Iterationen, Tokenverbrauch, Zeit und geprüfte Qualität des Endergebnisses. 78
Auf dem Mac nutzen: Claude API und OpenRouter
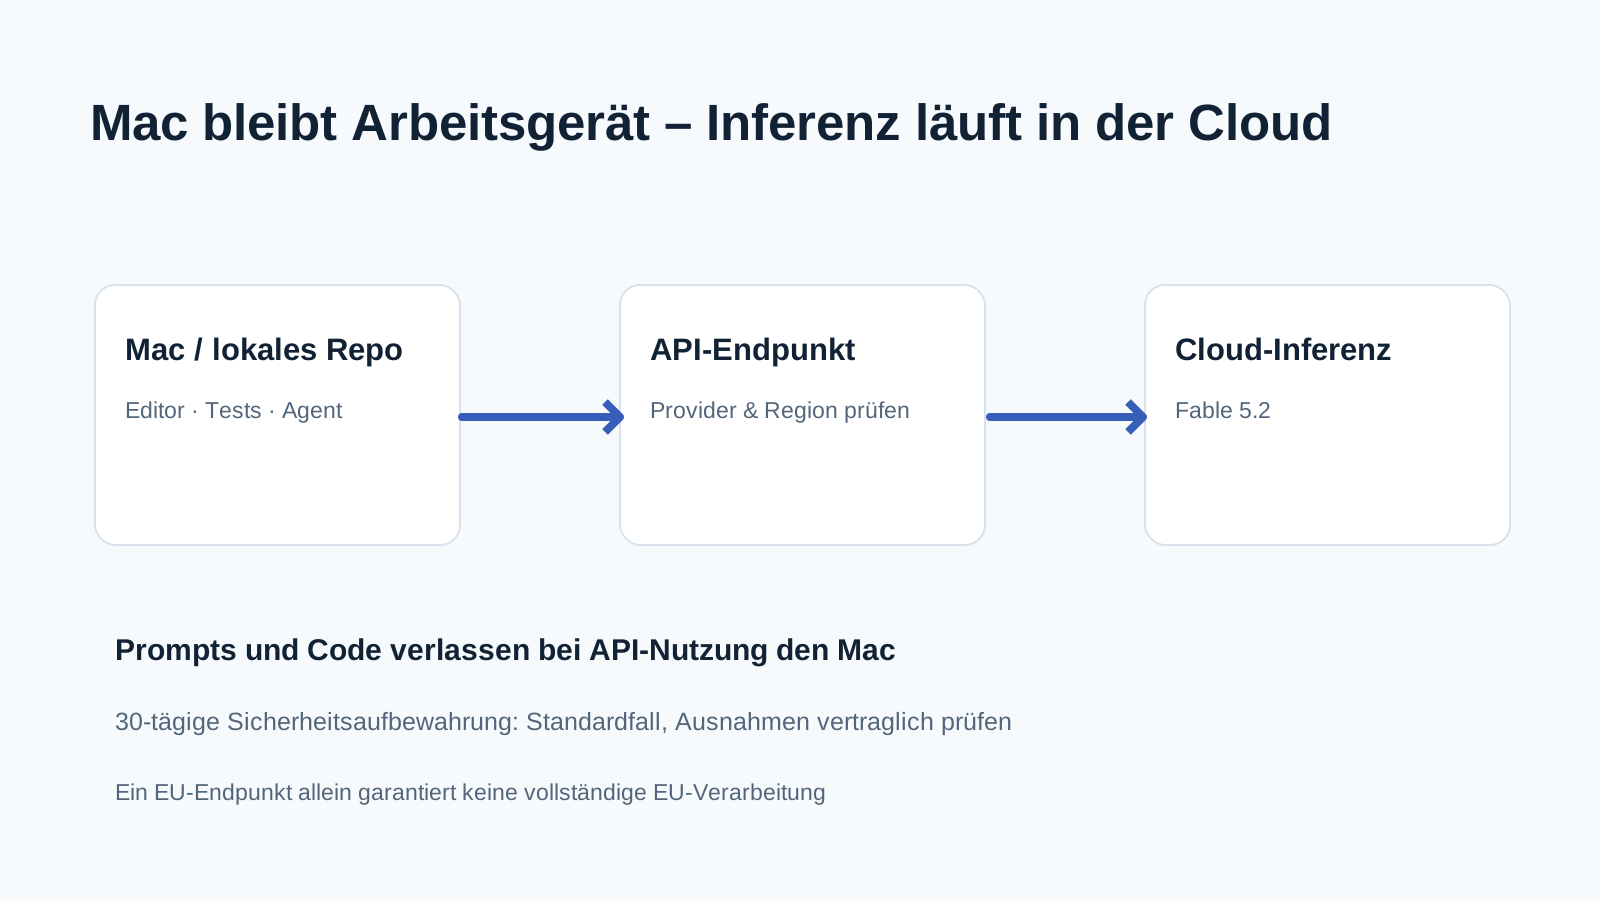
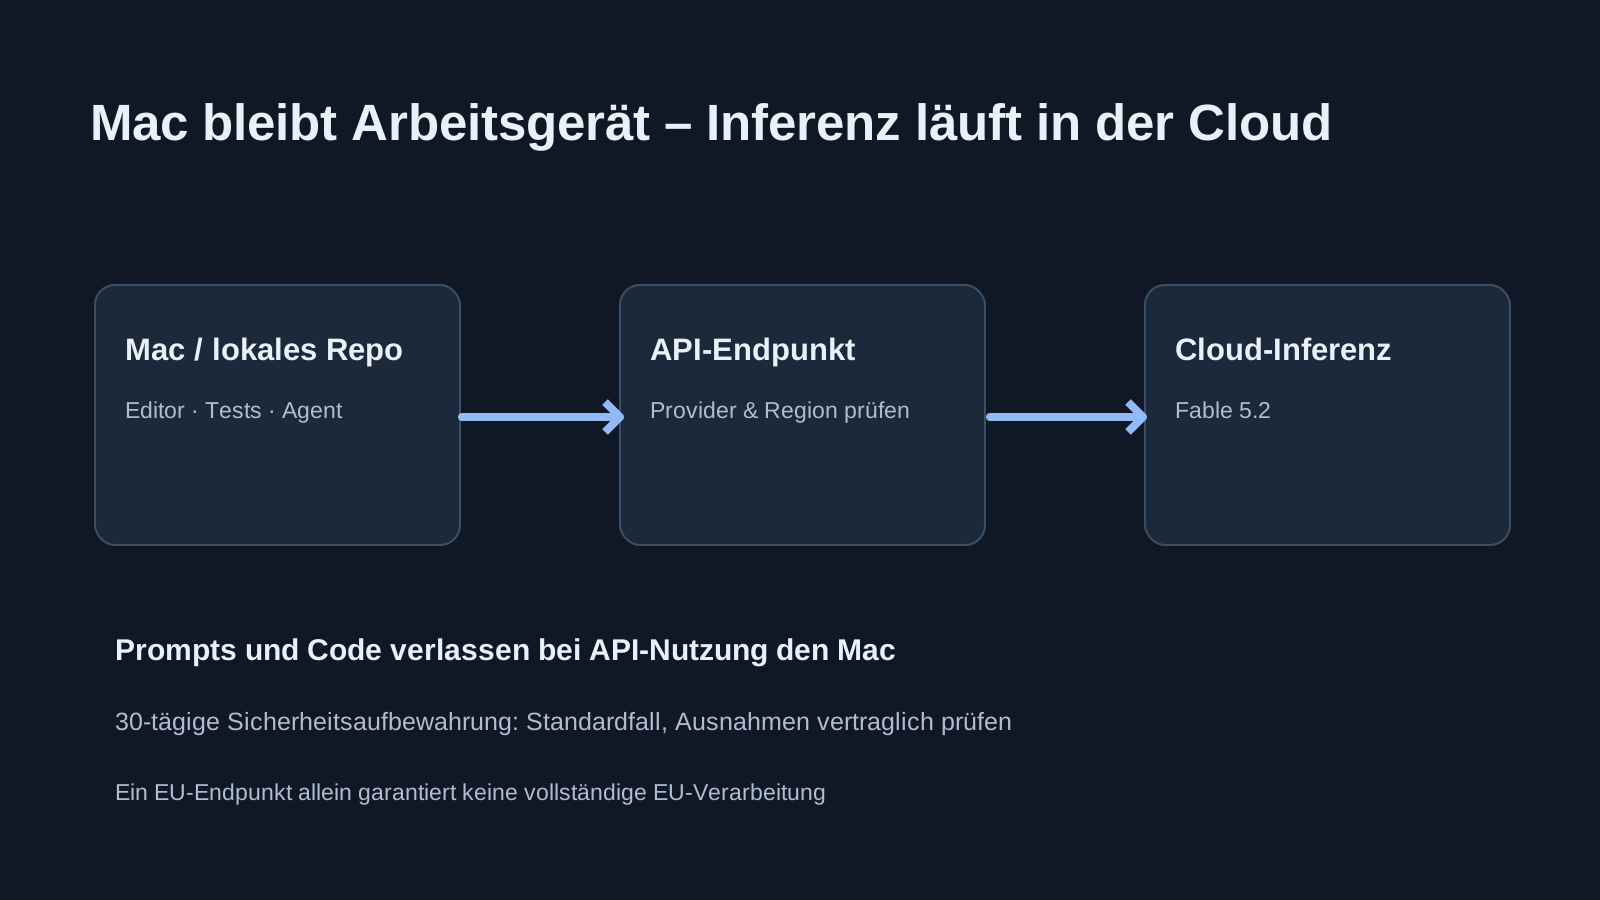
Fable 5.2 hat nicht veröffentlichte Gewichte. Ollama oder MLX können es deshalb auf einem Mac mini, MacBook Air oder MacBook Pro nicht lokal ausführen; auch 128 GB Unified Memory ändern daran nichts. Der Mac kann jedoch den Editor, Terminal, Testlauf und Agent-Harness bereitstellen, während Fable 5.2 über die Cloud antwortet. 28
Die Modell-ID hängt vom Zugang ab:
| Plattform | Modellkennung |
|---|---|
| Anthropic Messages API | claude-fable-5-2 |
| OpenRouter | anthropic/claude-fable-5.2 |
| Amazon Bedrock | anthropic.claude-fable-5-2 (je nach Aufruf ggf. Profilpräfix) |
| Google Cloud / Microsoft Foundry | claude-fable-5-2 |
Quellen: Anthropic und OpenRouter. Provider-Konfiguration, Endpoint und Region vor dem Einsatz prüfen. 210
Ein dokumentationsnahes Minimalbeispiel für die direkte Anthropic API:
import anthropic

client = anthropic.Anthropic()  # liest ANTHROPIC_API_KEY
message = client.messages.create(
    model="claude-fable-5-2",
    max_tokens=4096,
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Prüfe diese Migrationsstrategie auf Risiken."}],
)
for block in message.content:
    if block.type == "text":
        print(block.text)
Dafür werden ein eigener API-Zugang, ein freigeschaltetes Modell und eine kompatible SDK-Version benötigt. Das Beispiel führt keine Aktionen am lokalen Repository aus. 6
Drei API-Fallen beim Umstieg
- Append-only-Verlauf: Fable 5.2 bindet Thinking-Blöcke an ihren bisherigen Kontext. Werden frühere Nachrichten, Tooldefinitionen oder der Systemprompt nachträglich verändert, kann die API mit HTTP 400 und
The block is bound to a different conversationantworten.prefix_mismatch_behavior="drop_block"ist ein dokumentierter Beta-Notbehelf, ersetzt aber keine sauber aufgebaute History. 311 - Kein erzwungener Tool-Call:
tool_choicemitanyoder einem namentlich erzwungenen Tool liefert HTTP 400. Wo strukturierte Ausgaben nötig sind, empfiehlt Anthropic Auto-Auswahl mit strikter Validierung oder JSON-Ausgaben. 3 - Thinking ist nicht abschaltbar:
thinking: {"type":"disabled"}sowie veraltete festebudget_tokenssind ungültig. Effort undmax_tokensmüssen sinnvoll zusammenspielen. Wechsel auf kleinere Modelle kann außerdem Thinking-Blöcke verwerfen, die diese nicht lesen können. 311
Für Agenten ist ein kontrollierter Parallelvergleich sinnvoll: identische Aufgaben, gleiche Test-Suite, sauber protokollierte Requests und Kosten; ein schneller Opus- oder Sonnet-Lauf als Basislinie, Fable 5.2 nur für Eskalationen. Die genaue Orchestrierung hängt vom eingesetzten Framework ab.
Sicherheit, Biologie und Datenschutz
Fable und Mythos 5.2 basieren laut Anthropic auf demselben zugrunde liegenden Modell. Fable hat zusätzliche Sicherheitsfilter für bestimmte Cybersecurity- und Biologieaufgaben. Anthropic dokumentiert, dass blockierte Anfragen teils transparent an ältere Opus-Modelle weitergegeben werden. Mythos 5.2 ist über Verifizierungsprogramme eingeschränkt zugänglich. Für bioinformatische Forschung bedeutet das: Eine hohe allgemeine Wissenschaftsleistung garantiert nicht, dass sämtliche biomedizinischen Arbeitsschritte von Fable 5.2 bearbeitet werden. 1
Als sogenanntes Covered Model verlangt Fable 5.2 standardmäßig eine 30-tägige Sicherheitsaufbewahrung. Zero Data Retention (ZDR) erfordert eine ausdrücklich genehmigte Sonderregelung; Enterprise Frontier Safeguards ist für berechtigte Unternehmenskunden vorgesehen. Auf Google Clouds Agent Platform verbleiben die für Monitoring aufbewahrten Daten laut Anthropic in der Cloud-Provider-Umgebung; das allein beantwortet aber noch nicht Fragen nach Unterauftragsverarbeitung, geografischer Speicherung oder Zulässigkeit personenbezogener Inhalte. 1213
Google dokumentiert einen europäischen Multi-Region-Endpunkt für Claude Fable 5.2 mit EU-ML-Verarbeitung. OpenRouter kennzeichnet dagegen für diesen Modell-Router derzeit keine EU-In-Region-Routing-Option. Das sind unterschiedliche Plattformen und daher kein Beweis für einen Widerspruch. Wer strikte EU-Vorgaben hat, muss konkreten Provider, Region, Datenfluss, Aufbewahrung, Verträge und Tool-Aufrufe separat prüfen. Die normale Anthropic-API bietet hier keinen pauschalen EU-Only-Nachweis. 1014
Claude Pro, Max und die befristete Einführung
Zwischen 9. und 16. November 2026 (jeweils nach den offiziellen US-Pacific-Zeitangaben) dürfen berechtigte Pro-Abonnenten Fable-Modelle vorübergehend innerhalb von bis zu 50 % ihres bestehenden Wochenlimits nutzen. Berechtigte Pro-Abonnenten erhalten zudem einen Fable-Reset; Max/Ultra und bestimmte Premium-Sitze bekommen je nach Abolaufzeit bis zu drei Resets. Danach gelten wieder die regulären Regeln: Im Pro-Abo wird Fable normalerweise über Nutzungsguthaben abgerechnet; bei Max/Ultra zählt Fable innerhalb des bestehenden Limits mit einer 50-%-Teilgrenze. 50 % bedeutet keine zusätzlich geschenkten 50 % Gesamtkapazität. 1516
Für wen lohnt sich Fable 5.2?
Beginne mit Opus 5.5, wenn du alltägliche Programmierung, technische Dokumentation, kleinere Refactorings oder Routine-Agenten umsetzt. Teste Fable 5.2 auf selektiven Eskalationsfällen, beispielsweise großen migrationsartigen Änderungen, schwer reproduzierbaren Fehlern oder mehrstufiger wissenschaftlicher Analyse, wenn deine eigenen Messungen den Mehrpreis rechtfertigen. Nutze Sonnet 5.5 als günstigeren Kandidaten für gut strukturierte Tasks und Subagenten. 124
Für lokal vertrauliche Mac-Dateien ist keines dieser Cloud-Modelle eine Offline-Alternative. Wenn Daten das Gerät nicht verlassen dürfen, ist ein lokales Open-Weight-Modell mit dokumentiertem RAM-, Qualitäts- und Datenschutzprofil die richtige Vergleichskategorie – nicht eine vermeintlich lokal installierbare Fable-Variante.
Weiterlesen: Claude Fable 5.1: API-Kosten und Mac-Einsatz, Kimi K3.1 Pro: API und Agenten, Alle Artikel. Diese Links wurden am 11.11.2026 geprüft.
Quellen und Methodik
Herstellerdaten wurden aus der Anthropic-Ankündigung und API-Dokumentation übernommen und als solche bezeichnet. Vals AI, Artificial Analysis und Plotly liefern unabhängige Messungen unter jeweils eigenen Harnesses. Alle Kostenbeispiele sind eigene Rechnungen, keine praktischen Messungen. Recherchedatum: 11.11.2026. Weitere Quellen und alle geprüften URLs stehen im begleitenden Quellenprotokoll.
Footnotes
-
https://www.anthropic.com/claude-fable-and-mythos-5-2 ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
https://platform.claude.com/docs/en/models/fable-5-2/overview ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
https://platform.claude.com/docs/en/models/fable-5-2/whats-new-fable-5-2 ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
https://platform.claude.com/docs/en/about-claude/pricing ↩ ↩2 ↩3 ↩4 ↩5
-
https://platform.claude.com/docs/en/build-with-claude/fast-mode ↩
-
https://platform.claude.com/docs/en/build-with-claude/effort ↩ ↩2
-
https://www.vals.ai/models/anthropic_claude-fable-5-2 ↩ ↩2 ↩3
-
https://artificialanalysis.ai/models/claude-fable-5-2 ↩ ↩2 ↩3
-
https://plotly.com/blog/claude-fable-5-2-plotly-data-analytics-bench/ ↩
-
https://openrouter.ai/anthropic/claude-fable-5.2-20261109 ↩ ↩2
-
https://platform.claude.com/docs/en/models/fable-5-2/migration-guide ↩ ↩2
-
https://platform.claude.com/docs/en/manage-claude/api-and-data-retention ↩
-
https://support.claude.com/en/articles/15425695-covered-models ↩
-
https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/partner-models/claude/fable-5-2 ↩
-
https://support.claude.com/en/articles/17506494-claude-fable-5-2-launch-offers ↩
-
https://support.claude.com/en/articles/15424964-claude-fable-models-on-your-plan ↩