Google hat Gemini Decision 1 am 11. November 2026 veröffentlicht. Das Modell beantwortet strukturierte Fragen zu Texten, Bildern, Audio, Videos und PDFs, ohne generative Ausgabetokens zu erzeugen. Der reguläre API-Preis beträgt 0,10 US-Dollar pro Million Input-Tokens. Das macht es für Klassifikation, Tool-Auswahl und Model-Routing interessant, nicht für die eigentliche Codegenerierung. Google-Ankündigung · API-Preise
Stand: 13. November 2026. Diese Analyse verwendet öffentliche Dokumentation und eigene Kostenrechnungen. Es wurden keine eigenen Inferenz- oder Qualitätsmessungen durchgeführt.
Technische Daten und API-Limits
| Merkmal | Gemini Decision 1 |
|---|---|
| Native Modell-ID | gemini-decision-1 |
| Gateway-ID | google/gemini-decision-1 |
| Kontextfenster | 262.144 Tokens, einschließlich Fragen |
| Eingaben | Text, Bilder, Audio, Video, PDF |
| Ausgaben | Strukturierte Entscheidungen und Wahrscheinlichkeiten |
| Fragen je Request | 1–1.000, innerhalb des Kontextlimits |
| Optionen bzw. Bewertungsstufen | 2–255 |
| Inputpreis | 0,10 USD / Mio. Tokens |
| Output-Tokens | 0 |
| Context Caching / Batch API | Nicht unterstützt |
| Lokale Gewichte | Keine öffentliche Bereitstellung bestätigt |
Quellen: Google Decisions API und OpenRouter.
Entscheidungen statt Textgenerierung
Ein generatives LLM kann eine Klassifikation als JSON ausgeben. Das kostet Ausgabetokens und setzt voraus, dass der Client die Antwort verarbeitet. Gemini Decision 1 bewertet vorgegebene Antworten direkt. Die Anwendung legt fest, welche Entscheidungen möglich sind, und entscheidet selbst über die Folgen.
| Fragetyp | Bedeutung | Beispiel |
|---|---|---|
noul | Geschätzte Wahrscheinlichkeit für Ja | Ist das eine Coding-Aufgabe? |
choice | Auswahl und Verteilung über definierte Optionen | Welcher Agent ist zuständig? |
score | Erwarteter Wert auf einer geordneten Skala | Wie komplex ist die Anfrage? |
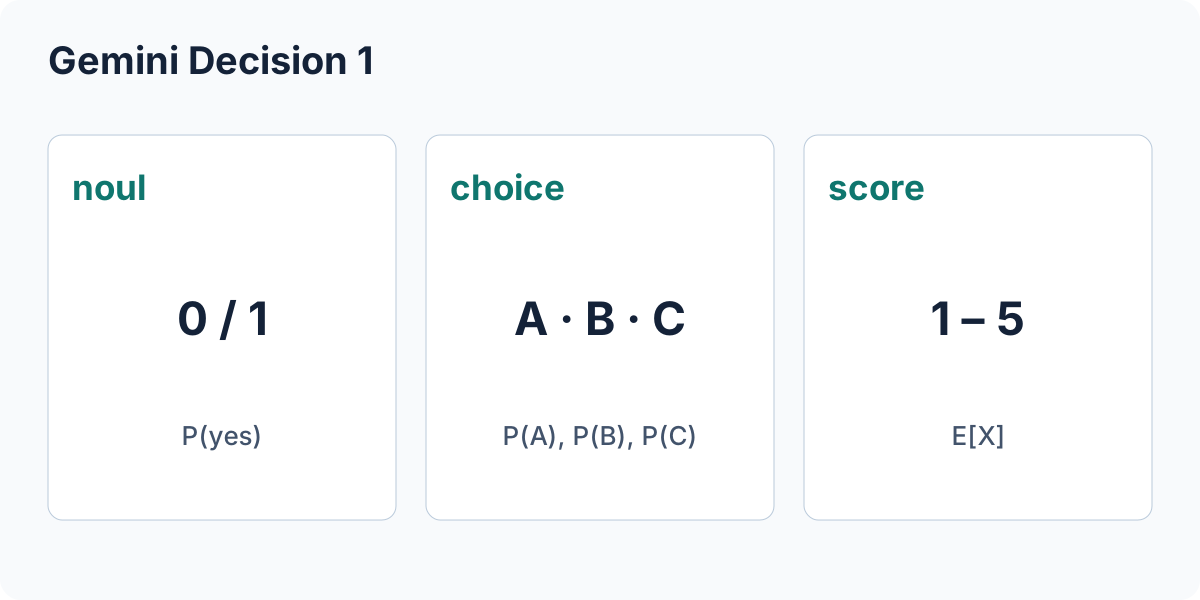
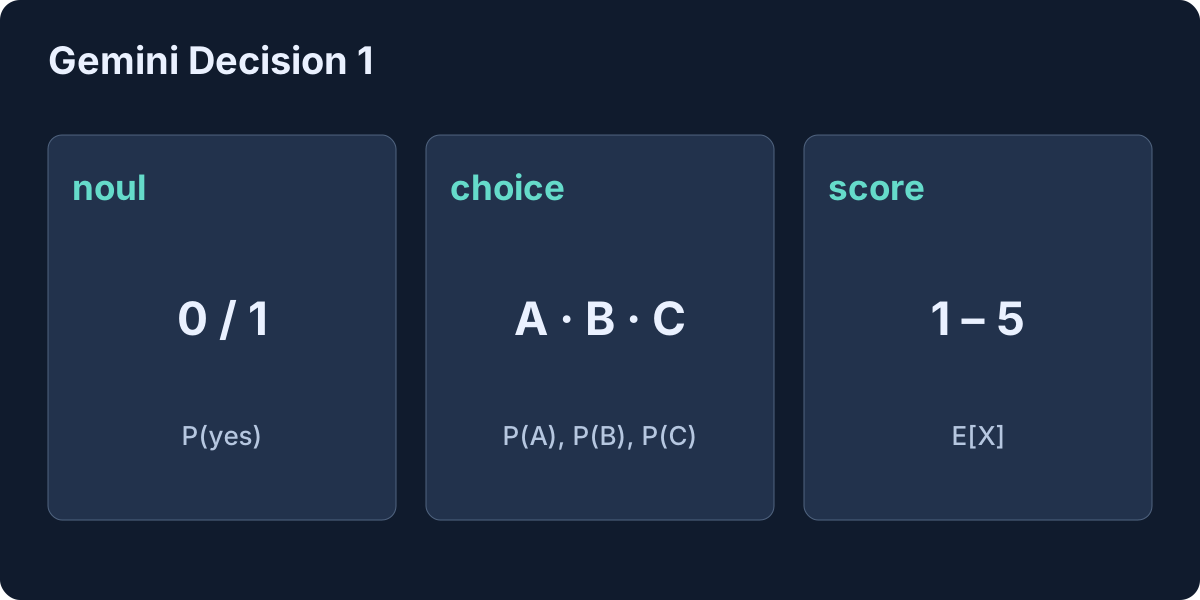
Die Wahrscheinlichkeit für Ja und die Konfidenz sind unterschiedliche Größen. Ein niedriger Ja-Wert kann eine sichere Nein-Entscheidung bedeuten. Auch eine hohe Konfidenz ist keine Garantie für Korrektheit. Die Fragen werden unabhängig ausgewertet und können nicht auf Antworten anderer Fragen zugreifen. Abhängigkeiten müssen in der Anwendungslogik modelliert werden. API-Dokumentation
API-Preise und monatliche Kosten
Google bietet ein kostenloses Kontingent innerhalb der geltenden Limits an. Der Standardtarif kostet 0,10 USD je Million Input-Tokens über alle unterstützten Modalitäten. Es gibt keine Output-Abrechnung, kein Context Caching und keine Batch API für dieses Modell. Die Developer API ist getrennt von Google-AI-Verbraucherabonnements.
| Anfragen pro Monat | Input-Tokens bei 2.000 je Anfrage | Modellkosten (USD) |
|---|---|---|
| 1.000 | 2 Mio. | 0,20 |
| 10.000 | 20 Mio. | 2,00 |
| 100.000 | 200 Mio. | 20,00 |
| 1.000.000 | 2 Mrd. | 200,00 |
Formel: Anfragen × abrechenbare Input-Tokens × 0,10 / 1.000.000. Eigene Berechnung nach Google-Preisliste; ohne Steuern, Gateway-Gebühren, Wiederholungen oder nachgelagerte Modelle.
Warum gemeinsamer Input entscheidend ist
Ein Dokument mit 10.000 Tokens soll anhand von 20 unabhängigen Fragen bewertet werden, die jeweils weitere 100 Tokens benötigen. Bei einzelnen Requests entstehen 20 × (10.000 + 100) = 202.000 Tokens, also 0,0202 USD. Eine gemeinsame Anfrage benötigt rechnerisch 10.000 + 20 × 100 = 12.000 Tokens für 0,0012 USD.
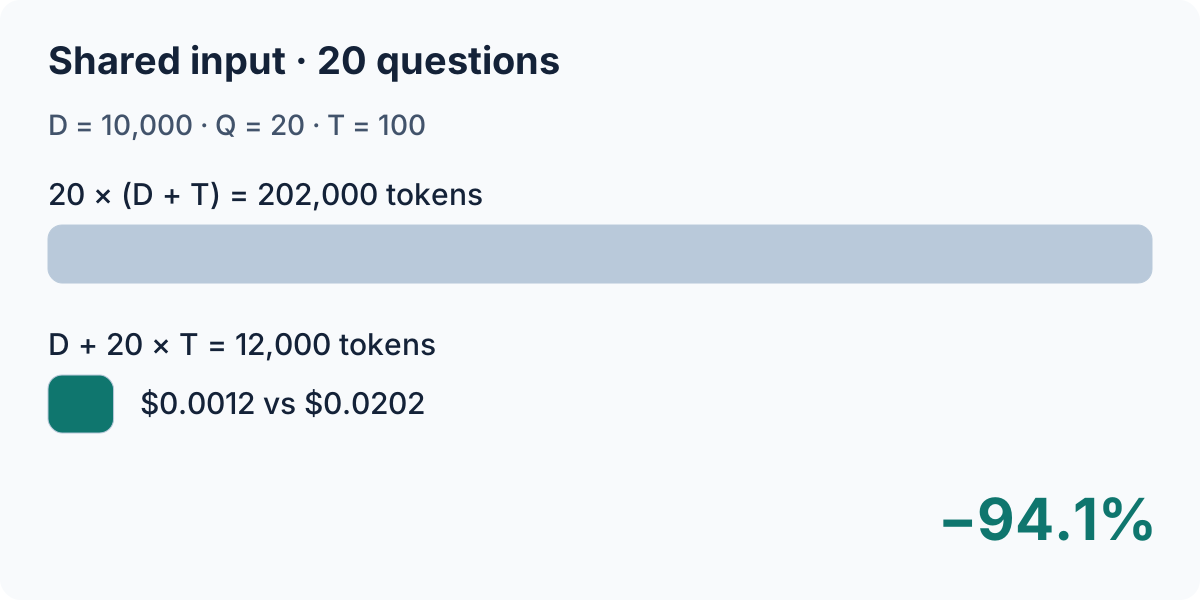
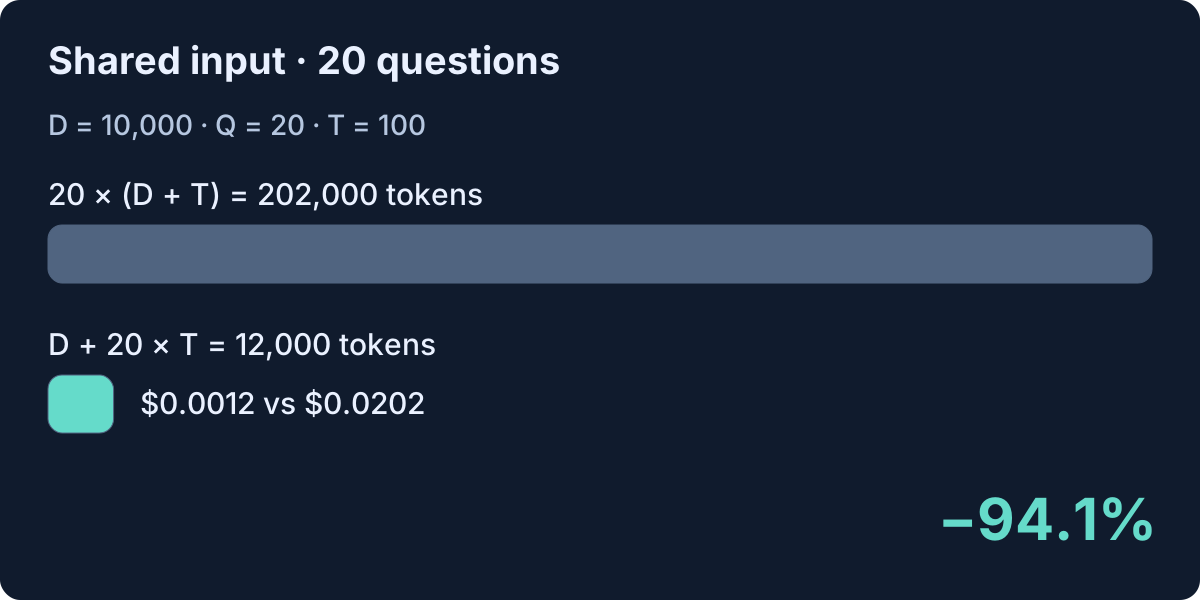
Die Ersparnis beträgt rund 94,1 Prozent. Zusätzliche Formatierungs-Tokens sind in der vereinfachten Rechnung nicht berücksichtigt. Der Vorteil gilt nur, wenn die Fragen unabhängig sind und die gemeinsame Anfrage in das Kontextfenster passt. Wiederholter Input in separaten Requests wird vollständig berechnet.
Für eigene Szenarien: Bei N Dokumenten, D Dokument-Tokens, Q Fragen und T Tokens je Frage kosten gemeinsame Requests N × (D + Q × T) × 0,10 / 1.000.000 USD. Separate Requests kosten N × Q × (D + T) × 0,10 / 1.000.000 USD.
Model-Routing für Agenten auf dem Mac
Ein Router kann einfache Aufgaben an ein lokales Modell, Coding-Aufgaben an ein spezialisiertes Cloud-Modell und schwierige Probleme an ein Reasoning-Modell weiterleiten. Gemini Decision 1 übernimmt die Klassifikation; es führt die ausgewählte Aufgabe nicht aus.
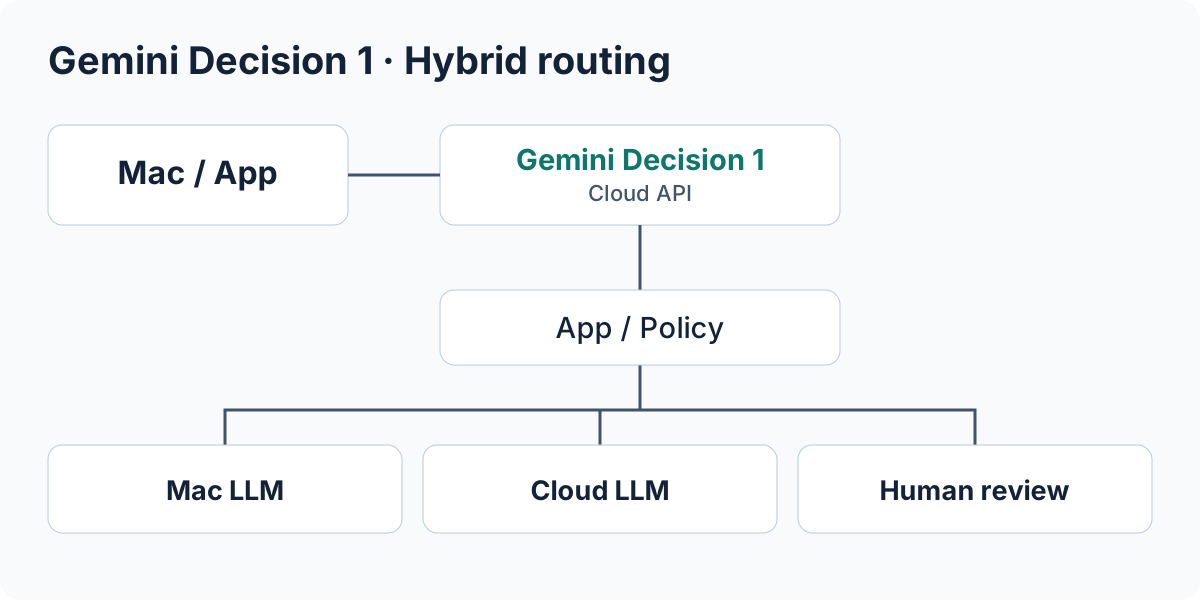
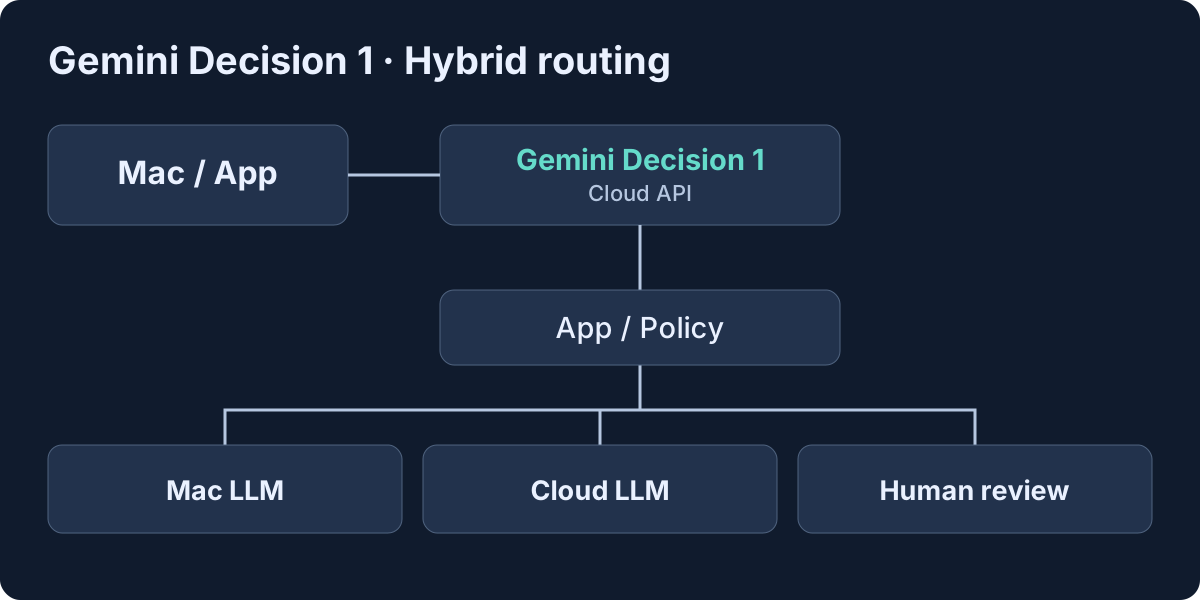
Die Anwendung kann bei niedriger Konfidenz eine manuelle Prüfung oder einen zweiten Klassifikator verwenden. Berechtigungen müssen getrennt und deterministisch geprüft werden. Eine Modellentscheidung sollte keine irreversiblen Aktionen eigenständig autorisieren.
Beispiel mit dem dokumentierten Google GenAI SDK ab Version 3.2. Installation: python3 -m pip install -U google-genai. Den API-Schlüssel als GEMINI_API_KEY setzen.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})
result = client.decisions.create(
    model="gemini-decision-1",
    input="Implement a CSV parser in Python.",
    questions={
        "coding": {
            "type": "noul",
            "instructions": "Does this task require writing code?"
        }
    }
)
answer = result.answers["coding"]
if answer.noul >= 0.90 and answer.confidence >= 0.85:
    print("coding")
else:
    print("review")
Die Schwellenwerte illustrieren die Anwendungslogik, sie sind keine empirisch optimierten Grenzwerte. Das Beispiel folgt dem dokumentierten SDK-Schema, wurde aber nicht live ausgeführt.
Anbieter, Latenz und Alternativen
Google verwendet die native REST-API unter https://generativelanguage.googleapis.com/v1beta/decisions. OpenRouter stellt eine eigene Decisions API bereit; ein Chat-Completions-Client ist nicht automatisch kompatibel. Vercel unterstützt das Modell über sein AI SDK; für Audio, Video und PDF verweist der Anbieter auf SDK 7. OpenRouter · Vercel
Google berichtet in der Launch-Ankündigung von 150–250 ms End-to-End-Latenz unter den angegebenen Bedingungen. Das ist kein eigener Messwert und keine Garantie für lange Multimedia-Requests oder europäische Netzwerklatenz.
| Modell (OpenRouter) | Input / Mio. Tokens (USD) | Kontext |
|---|---|---|
| Gemini Decision 1 | 0,10 | 262.144 |
| Liquid d1.1 | 0,02 | 65.536 |
| Perplexity Decider V1.2 | 0,02 | ca. 262K |
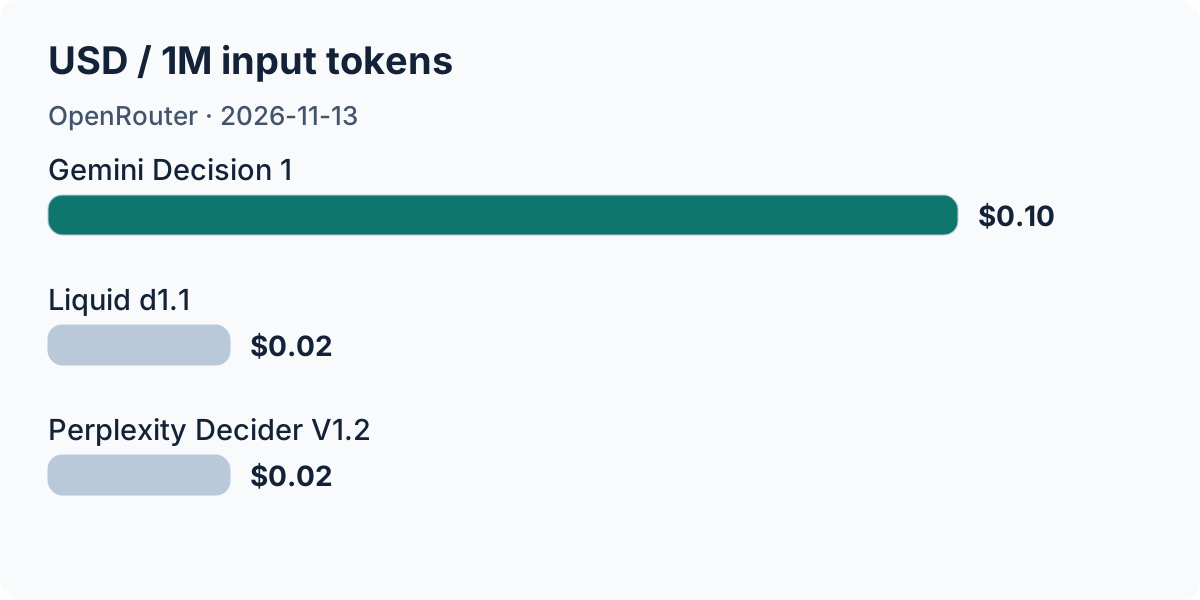
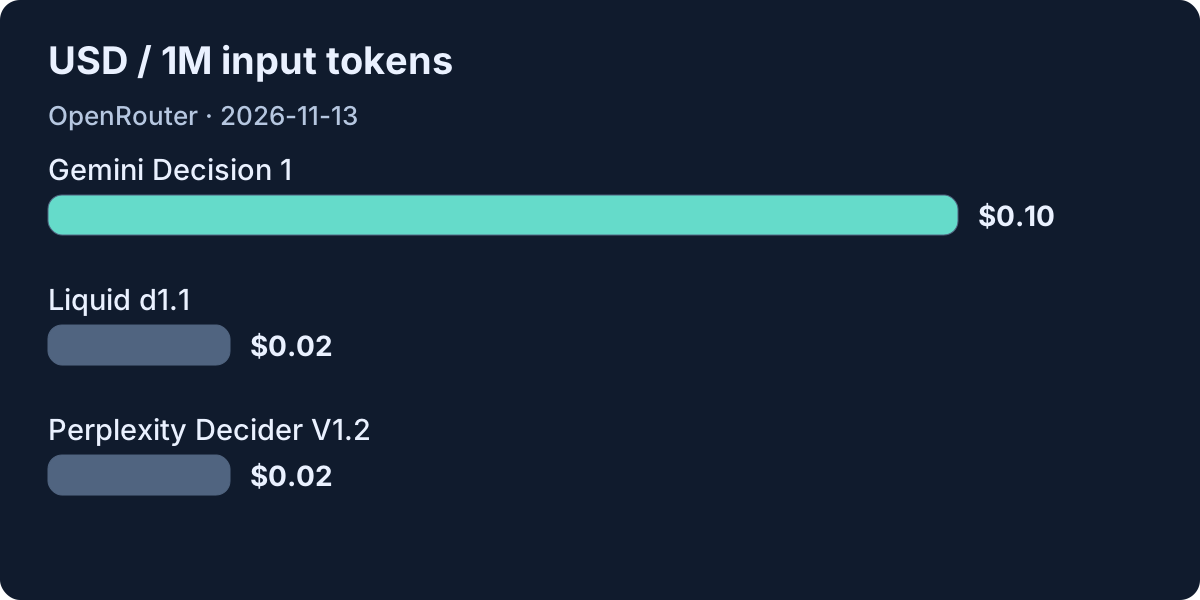
Quellen: Gemini, Liquid, Perplexity. Gemini kostet nominal fünfmal so viel wie die anderen beiden Modelle. Modalitäten, Fehlerraten und Latenzen sind nicht zwingend vergleichbar; die günstigste API muss nicht die günstigste Pipeline ergeben.
Lokale Ausführung und Datenschutz
Für Gemini Decision 1 sind keine öffentlich verfügbaren Modellgewichte bestätigt. Es gibt daher keinen dokumentierten lokalen Checkpoint für Ollama, MLX oder llama.cpp. Ein Mac kann die Cloud-API aufrufen oder die eigentliche Inferenz nach dem Routing lokal durchführen. Die an den Router gesendeten Inhalte verlassen dennoch das Gerät.
OpenRouter kennzeichnet das Modell als nicht für EU-In-Region-Routing verfügbar. Googles API-Bedingungen unterscheiden zwischen Tarifen und Regionen. Paid-Services-Bedingungen sind nicht gleichbedeutend mit einer Garantie ausschließlich europäischer Verarbeitung. Bei sensiblen Daten müssen der konkrete Anbieter, Auftragsverarbeitung und Datenflüsse überprüft werden.
So lässt sich die Routing-Qualität messen
Für einen ersten Vergleich sind beispielsweise 500 repräsentative, manuell klassifizierte Anfragen sinnvoll. Erfasst werden Precision, Recall, F1 pro Kategorie, Fehlerraten unter automatisch weitergeleiteten Aufgaben, Median- und P95-Latenz und Kosten der kompletten Pipeline. Verschiedene Konfidenzschwellen zeigen den Zielkonflikt zwischen Automatisierungsgrad und Fehlerquote. Für probabilistische Vorhersagen können Kalibrierungsdiagramme und der Brier-Score helfen.
Ein Router lohnt sich wirtschaftlich erst dann, wenn seine eigenen Kosten und die Folgen falscher Entscheidungen geringer als die vermiedenen Ausgaben für leistungsfähigere Modelle sind. Für vollständig lokale Abläufe bleibt ein lokaler Klassifikator oder ein lokales LLM die naheliegende Vergleichsbasis.
Weiterführend: Gemini API-Kosten, TypeSafe Jev Router und Gemma 4 auf dem Mac.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- blog.google developers-tools / gemini-decisions-api
- aistudio.google.com docs / decisions-api
- aistudio.google.com docs / pricing
- openrouter.ai google / gemini-decision-1
- vercel.com changelog / gemini-decision-1-now-available-on-ai-gateway
- aistudio.google.com docs / terms
- openrouter.ai features / in-region-routing
- openrouter.ai liquid / d1.1
- openrouter.ai perplexity / pplx-decider-v1.2
- scikit-learn.org modules / calibration.html