Mit KI-Unterstützung recherchiert und redigiert. Inhaltlich verantwortlich: Julian Dominic Altmann. Quellenprüfung vom 8. November 2026; keine eigenen MacBook- oder LLM-Geschwindigkeitsmessungen.
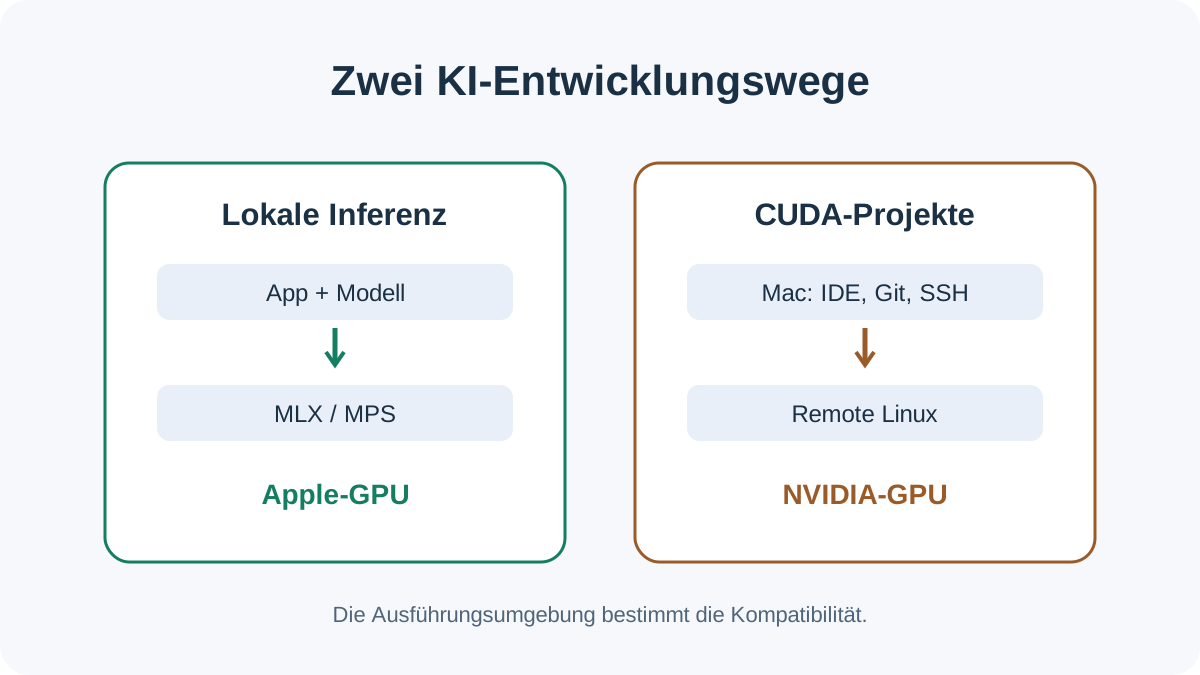
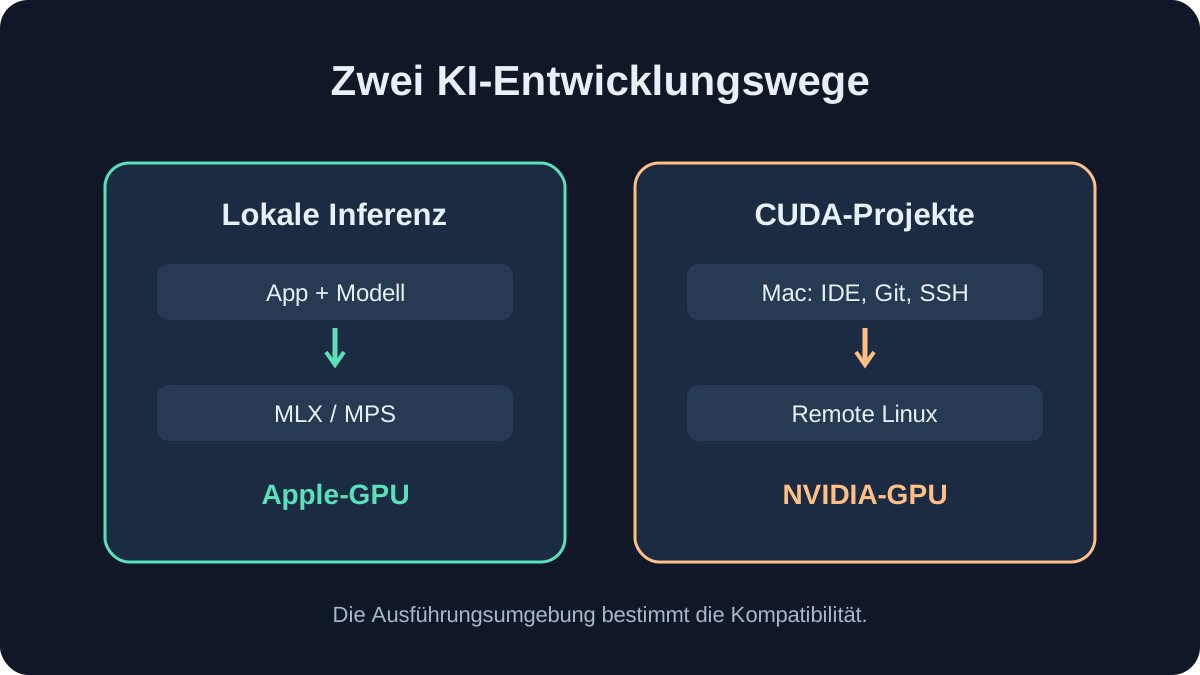
Ja, für viele Formen der KI-Entwicklung ist ein MacBook Pro sehr gut geeignet. Das gilt für Anwendungen mit Cloud-APIs, autonome Agenten, RAG-Systeme, lokale Sprachmodelle und unterstütztes Fine-Tuning. Für CUDA-spezifische Forschung und verteiltes Training großer Modelle ist es hingegen kein vollwertiger Ersatz für einen NVIDIA/Linux-Rechner. Das liegt vor allem an der Softwarearchitektur, nicht daran, dass macOS grundsätzlich keine GPU-beschleunigte KI ausführen könnte. Apple: PyTorch auf Metal · NVIDIA: CUDA
Wer bereits einen Apple-Silicon-Mac besitzt, sollte deshalb zunächst den konkreten Workflow testen, statt nur auf den Chipnamen oder theoretische TOPS zu achten. Dieser Entwicklerleitfaden zeigt einen lokalen API-Test, eine reproduzierbare Durchsatzmessung und die Grenzen von MLX, PyTorch/MPS und CUDA. Den eigentlichen Hardware- und Preisvergleich deckt unsere MacBook-Kaufberatung für KI-Entwicklung ab.
Was funktioniert auf einem MacBook Pro?
| Aufgabe | Eignung | Engpass |
|---|---|---|
| KI-App mit externen APIs | Sehr gut | Entwicklungswerkzeuge, Netzverbindung |
| Coding-Agenten und Tool-Aufrufe | Sehr gut | Kontextverarbeitung, Latenz |
| RAG, Embeddings, Vektordatenbank | Sehr gut | RAM, Indexgröße, Speicher |
| Lokale LLM-Inferenz | Gut bis sehr gut | RAM, Kontext, Modell und Runtime |
| Klassisches Machine Learning | Sehr gut | Framework und Modell |
| LoRA/QLoRA mit MLX-LM | Geeignet, modellabhängig | Kompatibilität, GPU-Speicher, Batch |
| Große Trainingscluster und CUDA-Kernel | Lokal ungeeignet | NVIDIA-CUDA-Ökosystem |
Die Tabelle beschreibt Einsatzgebiete, keine Benchmark-Rangliste. Cloud-first-Anwendungsentwicklung benötigt nur wenig lokale Modellrechenleistung. Ein Agent, der jede Anfrage über eine externe API abwickelt, profitiert nicht automatisch von einer Max-GPU.
Warum Unified Memory für lokale LLMs zählt
Bei Apple Silicon greifen CPU und GPU auf einen gemeinsamen Speicherpool zu. Das ermöglicht es MLX, Daten auf beiden Geräten zu verwenden, ohne sie grundsätzlich zwischen getrenntem System-RAM und dediziertem GPU-VRAM kopieren zu müssen. MLX-Dokumentation
Unified Memory bedeutet allerdings nicht, dass alle 32, 64 oder 128 GB als ungenutzter Modell-GPU-Speicher verfügbar sind. macOS, Entwicklungswerkzeuge, Modellgewichte, temporäre Puffer und der KV-Cache konkurrieren um dieselbe Kapazität. Ein längeres Kontextfenster kann den KV-Cache stark vergrößern; mehrere parallele Anfragen ebenfalls.
Für die reine Speicherung von 4-Bit-Gewichten lässt sich eine ideale Untergrenze berechnen:
Gewichtsspeicher (dezimal GB) = Parameterzahl (Milliarden) × 4 / 8
| Dichtes Modell | Idealisierter 4-Bit-Gewichtsspeicher |
|---|---|
| 8B | 4 GB |
| 14B | 7 GB |
| 32B | 16 GB |
| 70B | 35 GB |
Eigene rechnerische Untergrenzen, keine tatsächlichen Laufzeitanforderungen. Metadaten, Mischpräzision, KV-Cache und Betriebssystem fehlen.
Ein theoretisches 70B-Q4-Modell mit 35 GB Gewichtsspeicher ist deshalb nicht automatisch auf jedem 48-GB-Mac komfortabel nutzbar. Für realistische Reserven und Kontextgrößen hilft unser separater Unified-Memory-Guide.
M6, M5 Pro und M5 Max: Welche Konfiguration ist relevant?
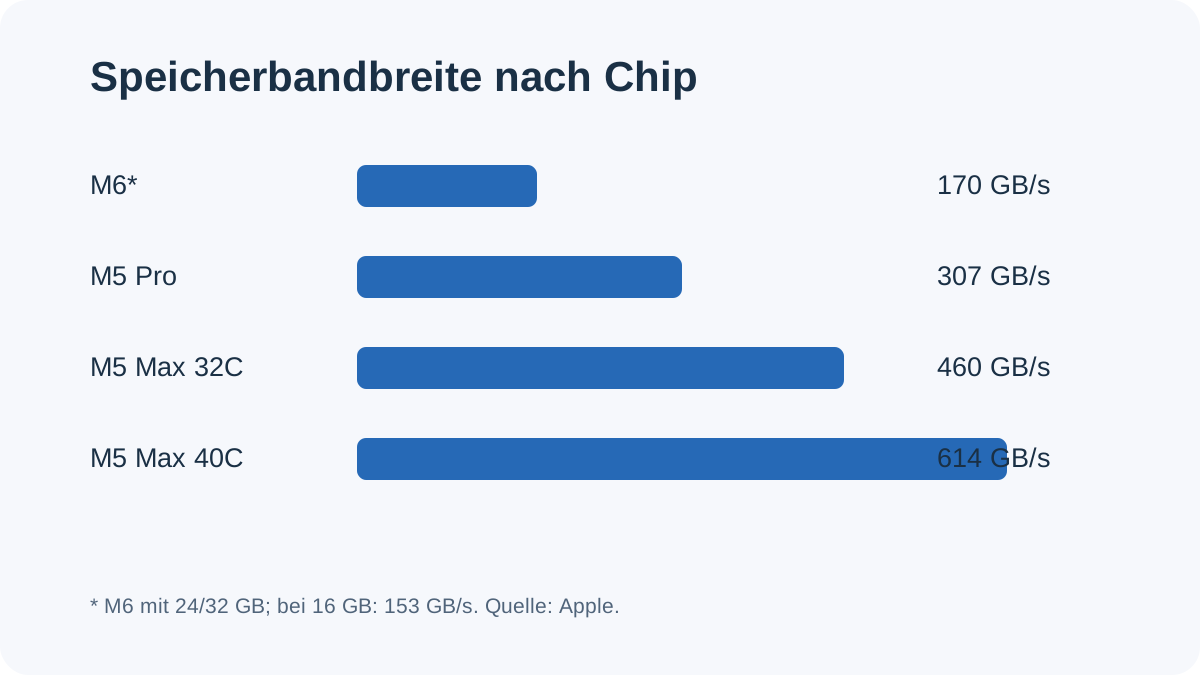
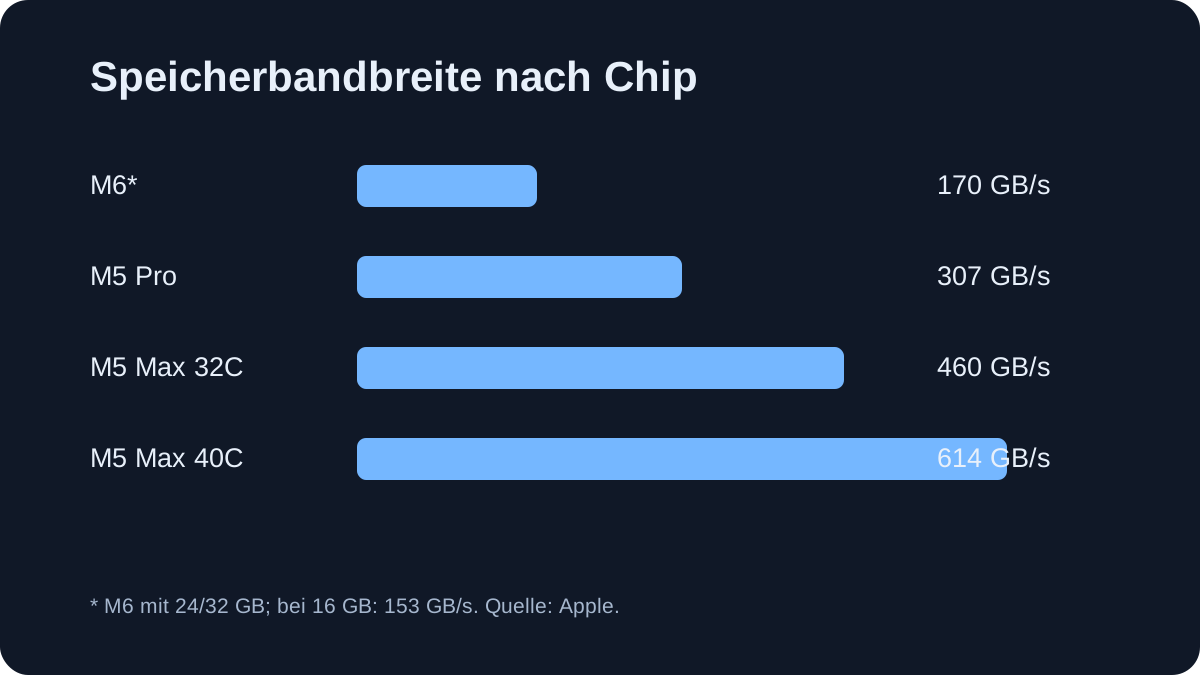
| MacBook-Pro-Chip | Maximale RAM-Konfiguration | Bandbreite |
|---|---|---|
| M6 | 32 GB | 170 GB/s bei 24/32 GB |
| M5 Pro | 64 GB | 307 GB/s |
| M5 Max, 32-Core-GPU | 36 GB | 460 GB/s |
| M5 Max, 40-Core-GPU | 128 GB | 614 GB/s |
Apple-Spezifikationen, geprüft am 08.11.2026. Das M6-Basismodell mit 16 GB besitzt 153 GB/s. Die Maximalwerte sind nicht für jede Chip-/RAM-Variante verfügbar. M6-Technikdaten · M5 Pro/Max-Technikdaten
Die Konsequenz für Entwickler: Für API-first-Projekte und kleinere lokale Modelle sind 24 bis 32 GB häufig ausreichend. Wer IDE, Browser, RAG-Dienste und größere Modelle gleichzeitig betreibt, gewinnt durch 48 oder 64 GB mehr Spielraum. 128 GB sind für besonders große lokale Modelle interessant, aber kein Garant für hohe Inferenzgeschwindigkeit. Die reale Leistung hängt auch von Modellarchitektur, Quantisierung, Kernels und Kontext ab.
Gerade beim M5 Max ist die GPU-Ausbaustufe wichtig: Die 32-Core-Variante unterstützt nur 36 GB Unified Memory. 48, 64 und 128 GB gehören zur 40-Core-Konfiguration. Apple-Spezifikation
MLX oder PyTorch/MPS: Die passende Entwicklungsumgebung
MLX ist Apples auf Apple Silicon ausgerichtetes Machine-Learning-Framework. Es bietet automatische Differenzierung und GPU-Ausführung; das ergänzende MLX-LM bietet Inferenz sowie LoRA- und QLoRA-Fine-Tuning für kompatible Modellfamilien. Nicht jede beliebige Hugging-Face-Architektur wird automatisch unterstützt. MLX-LM Fine-Tuning
PyTorch/MPS bringt bekannte PyTorch-APIs auf die Apple-GPU. Das ist für neuronale Netze, Lehrprojekte und kleinere Trainingsläufe nützlich. MPS ist aber kein CUDA-Emulator: einzelne Operatoren, Optimierungen und native CUDA-Erweiterungen fehlen oder benötigen andere Implementierungen. Apple PyTorch · PyTorch MPS Notes
GPU-Verfügbarkeit mit PyTorch überprüfen:
import torch

device = torch.device(
    "mps" if torch.backends.mps.is_available() else "cpu"
)
print("Device:", device)
Die Ausgabe bestätigt nur die Verfügbarkeit des Backends. Sie beweist nicht, dass alle Operationen eines konkreten Modells vollständig auf der GPU laufen.
Ollama und LM Studio sind die schnelleren Wege für die lokale App-Entwicklung: beide stellen lokale Modellschnittstellen bereit. Ollama führte am 30. März 2026 einen MLX-basierten Pfad für Apple Silicon als Preview ein; die tatsächliche Runtime und Modellkompatibilität müssen für die installierte Version geprüft werden. Ollama MLX · LM Studio Server
Auch vLLM Metal existiert, ist aber nicht mit jeder CUDA-vLLM-Konfiguration gleichzusetzen. Vor einem produktiven Einsatz ist die unterstützte Modell- und Feature-Matrix entscheidend.
Praxis: Eine lokale KI-API starten
Für einen ersten Integrationstest genügt ein kleines quantisiertes Modell. Das öffentlich verfügbare Qwen3:4B-Paket bei Ollama hat einen Downloadumfang von etwa 2,5 GB (Q4_K_M); der Arbeitsspeicherbedarf zur Laufzeit ist höher.
Ollama installieren, den lokalen Dienst starten und anschließend:
ollama pull qwen3:4b
curl -s http://localhost:11434/api/chat \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3:4b",
    "messages": [
      {"role": "user", "content": "Erkläre einen Python-Decorator."}
    ],
    "stream": false
  }'
Die Anfrage wird vom lokalen Ollama-Dienst verarbeitet, sofern er läuft und das Modell geladen werden kann. Eine solche Architektur eignet sich für interne Dokumentensuche, Code-Assistenten und Prototypen. Lokal ausgeführte Modellgewichte bedeuten aber nicht automatisch vollständige Offline-Nutzung: zusätzliche Tools, Downloads oder Telemetrie müssen separat geprüft werden.
Leistung reproduzierbar messen statt Marketingwerte vergleichen
Ein einzelner Tokens-pro-Sekunde-Wert lässt wichtige Engpässe aus. Bei Coding-Agenten zählen neben der Ausgaberate vor allem Prefill (Verarbeitung langer Eingaben) und Time to First Token (Wartezeit bis zur ersten Ausgabe).
Ollama gibt bei der Generate-API unter anderem die generierten Tokens und die Auswertungsdauer in Nanosekunden zurück. Daraus lässt sich eine Decode-Rate berechnen. API-Referenz
curl -s http://localhost:11434/api/generate \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3:4b",
    "prompt": "Erkläre die binäre Suche.",
    "stream": false,
    "options": {"num_predict": 256, "temperature": 0}
  }' | python3 -c '
import json, sys
r = json.load(sys.stdin)
n, t = r.get("eval_count", 0), r.get("eval_duration", 0)
print(f"{n * 1e9 / t:.1f} Tokens/s" if t else "Kein gültiger Messwert")
'
Für einen sauberen Vergleich müssen Modell-Digest, Quantisierung, Kontextlänge, Runtime-Version, Temperatur/Energieprofil und wiederholte Messungen festgehalten werden. Ein einmaliger kurzer Prompt eignet sich nur als Funktionstest, nicht für eine universelle Hardware-Rangliste.
Die unabhängige Jacar-Messreihe dokumentiert beispielsweise M5-Max-Daten mit konkreter oMLX-Version, Modellkonfiguration und mehreren Wiederholungen. Solche veröffentlichten Ergebnisse sind ein Anhaltspunkt, dürfen aber nicht auf beliebige andere Modelle übertragen werden. Für diesen Artikel wurden keine eigenen Tokenraten gemessen.
Fine-Tuning und Training: Was geht, was nicht?
Auf einem MacBook Pro lassen sich viele kleinere neuronale Netze trainieren. Mit MLX-LM können bestimmte Sprachmodelle durch LoRA oder QLoRA angepasst werden; dabei werden weniger Parameter trainiert als beim vollständigen Fine-Tuning. Modellunterstützung, Batch-Größe, Sequenzlänge und RAM bestimmen die praktische Grenze. MLX-LM LoRA-Dokumentation
Vollständiges Training großer Sprachmodelle benötigt zusätzlich zu den Gewichten Speicher für Gradienten, Aktivierungen und Optimizer-Zustände sowie sehr viel Rechenleistung. Für verteilte Trainingssysteme, CUDA-Kernel und NVIDIA-spezifische Bibliotheken bleibt Linux mit NVIDIA-GPUs die naheliegendere Ausführungsplattform. Ein Mac kann dabei weiterhin als lokaler Editor und SSH-Client dienen. NVIDIA CUDA
Die aktive Kühlung eines MacBook Pro hilft bei längerer GPU-Last, beseitigt aber nicht thermische und elektrische Grenzen. Der unabhängige Notebookcheck-Test des 16-Zoll-M5-Max dokumentiert das Verhalten unter Dauerlast. Das sind externe Testdaten, keine Messungen dieser Redaktion.
Welche Entscheidung ist sinnvoll?
- Cloud-first KI-Entwicklung: Erst prüfen, ob der vorhandene Mac genügt. Für APIs, Agent-Orchestrierung und Backend-Code ist eine größere GPU oft kein entscheidender Vorteil.
- Local-first-Prototypen mit größeren LLMs: RAM-Reserve und das gewünschte Modell priorisieren; M5 Pro mit 48/64 GB ist ein plausibler Ausgangspunkt.
- Sehr große lokale Modelle: M5 Max mit 128 GB prüfen, aber vor dem Kauf das konkrete Modell samt Kontext und Runtime kalkulieren.
- CUDA-spezifische Forschung: MacBook für IDE, Git und SSH nutzen, Trainings- und Kernel-Tests auf NVIDIA/Linux ausführen.
Für den eigentlichen Kaufentscheid mit deutschen Preisen und weiteren Modellen: MacBook für KI-Entwicklung 2026. Für Modellgrößen und Reserven: RAM-Bedarf lokaler LLMs.
Fazit
Ein MacBook Pro ist ein leistungsfähiges mobiles System für KI-Apps, lokale Inferenz, RAG und unterstütztes Fine-Tuning. Der entscheidende Mehrwert liegt in Unified Memory und einem nutzbaren Apple-Silicon-Softwarestack – nicht in einer pauschalen Überlegenheit gegenüber CUDA-GPUs.
Die beste Entwicklungsmaschine ist diejenige, auf der dein konkreter Stack funktioniert. Prüfe deshalb zunächst Runtime, Modell, Kontext und die für dein Projekt notwendigen GPU-Operationen, bevor du für zusätzlichen Speicher oder eine Max-GPU bezahlst.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- support.apple.com en-us / 148300
- support.apple.com en-us / 126319
- apple.com 10 / apple-introduces-the-new-14-inch-macbook-pro-with-m6
- apple.com 03 / apple-introduces-macbook-pro-with-all-new-m5-pro-and-m5-max
- ml-explore.github.io usage / unified_memory.html
- github.com mlx_lm / LORA.md
- developer.apple.com metal / pytorch
- docs.pytorch.org notes / mps.html
- ollama.com blog / mlx
- ollama.com library / qwen3:4b
- docs.ollama.com api / generate
- lmstudio.ai core / server
- docs.vllm.ai stable / supported_models
- docs.nvidia.com cuda / cuda-installation-guide-linux
- jacar.es en / local-llm-benchmarks-apple-silicon
- notebookcheck.net Apple-s-fastest-laptop-starts-to-show-its-age-Apple-MacBook-Pro-16-2026-M5-Max-Review.1250821.0.html