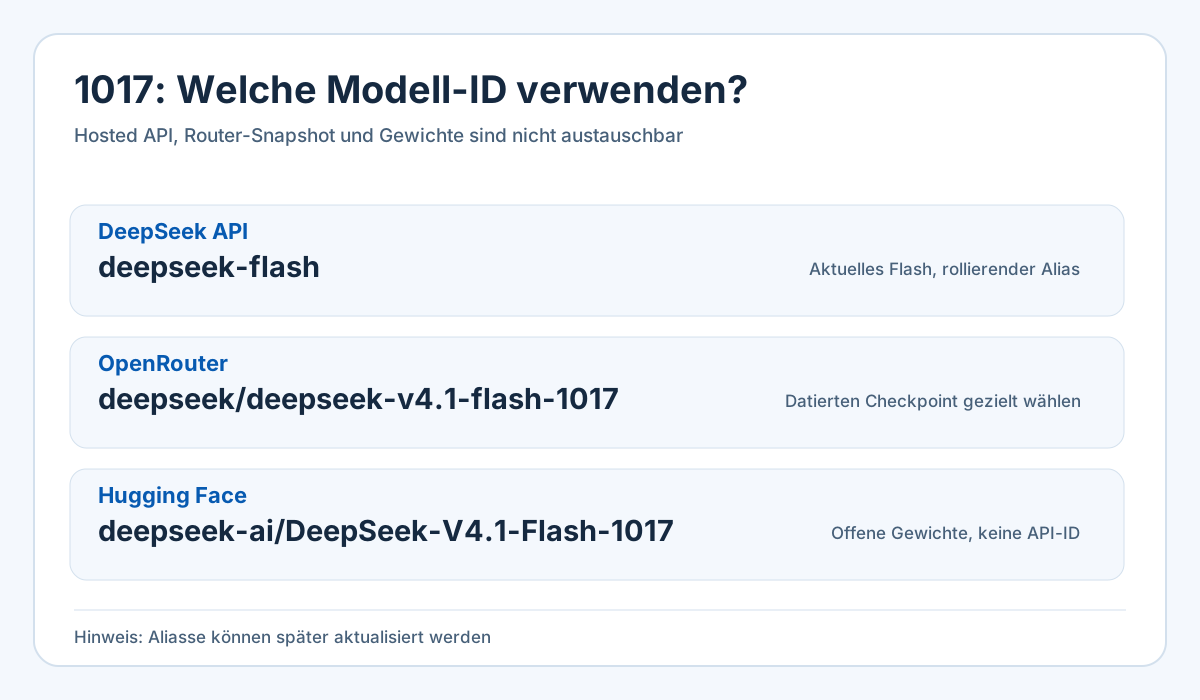
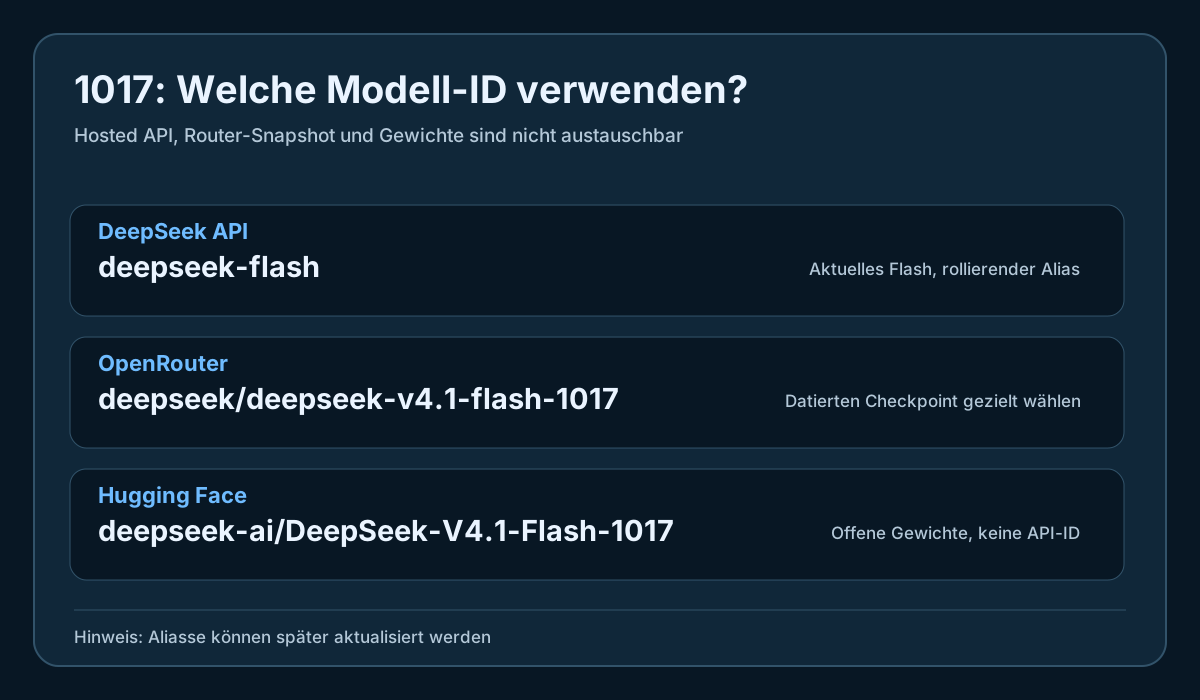
Recherche-Stand: 17. Oktober 2026. DeepSeek hat am 17. Oktober 2026 das Checkpoint-Update DeepSeek-V4.1-Flash-1017 veröffentlicht. Der neue Stand ersetzt die September-Version hinter dem API-Alias deepseek-flash; bestehende Integrationen benötigen keinen ID-Wechsel. Auf OpenRouter ist zusätzlich der datierte Snapshot deepseek/deepseek-v4.1-flash-1017 gelistet. Die Methode des Zugriffs und die Listenpreise bleiben laut Hersteller unverändert. 123
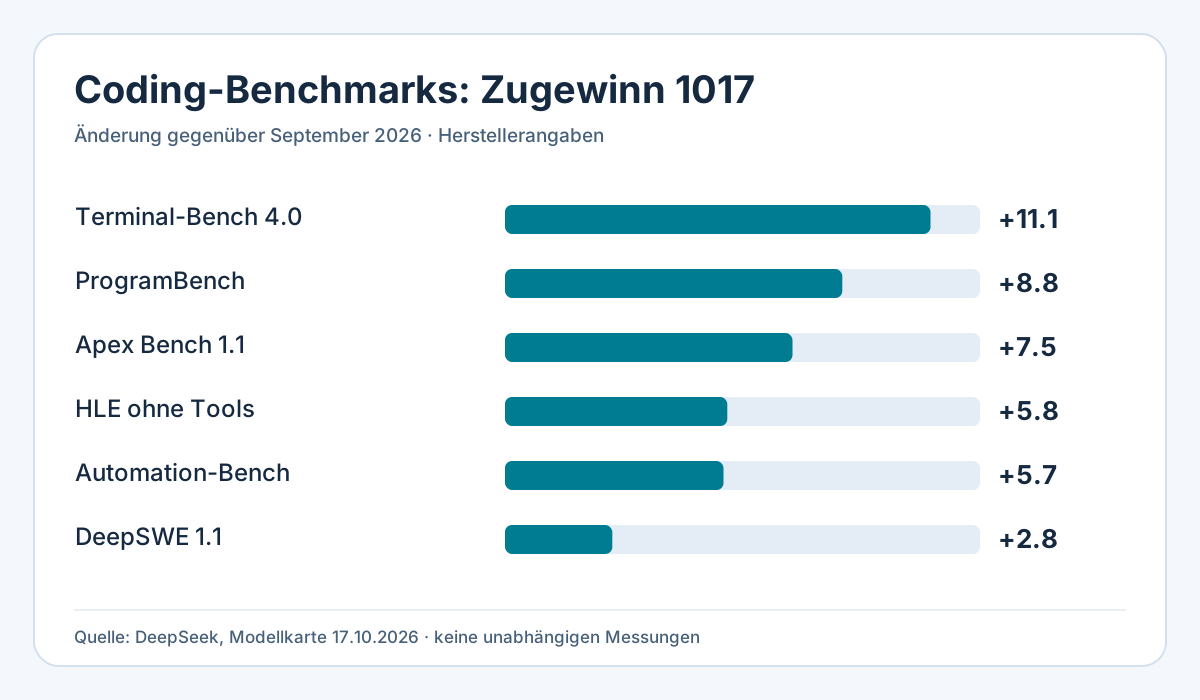
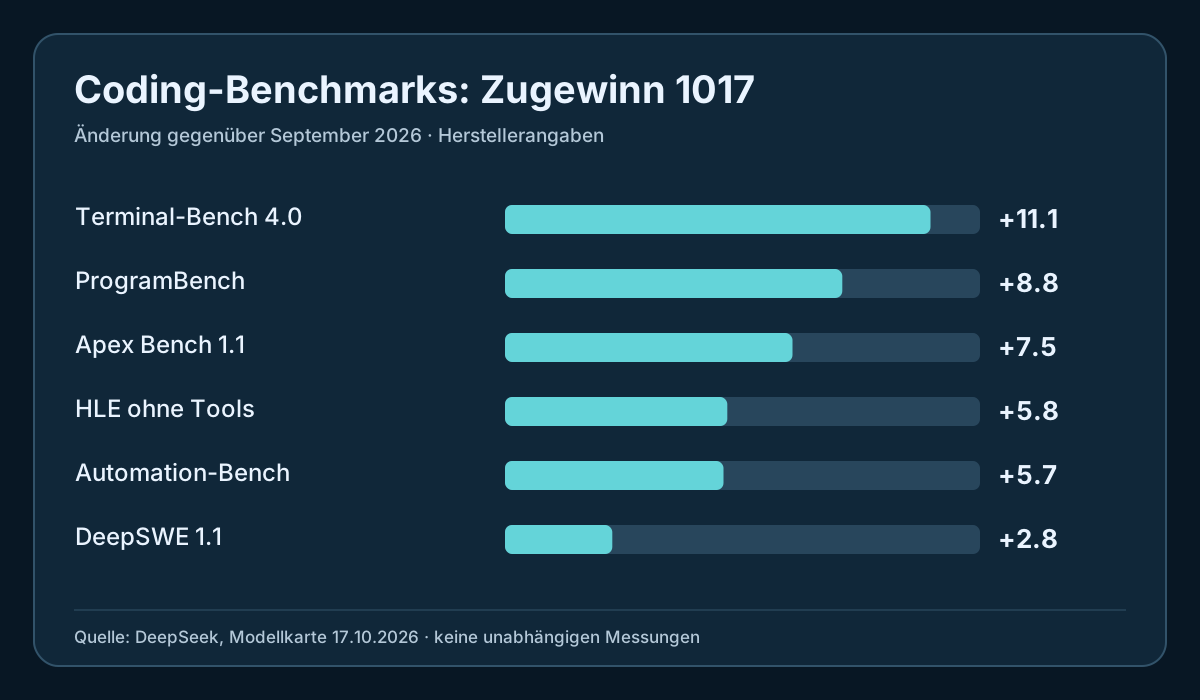
Die Hersteller-Benchmarks betonen Coding- und Agenten-Leistung. Für Terminal-Bench 4.0 nennt DeepSeek 42,3 statt 31,2 Punkte, für ProgramBench 29,1 statt 20,3 und für Automation-Bench 60,5 statt 54,8. Das sind Hersteller-Evaluationen ohne unabhängige Replikation durch AI on Mac. 4
Was sich daraus für die Praxis ergibt: Wer die offizielle DeepSeek-API bereits mit deepseek-flash nutzt, erhält das Update ohne API-ID-Wechsel. Wer reproduzierbare Tests über OpenRouter durchführen will, sollte den datierten Snapshot verwenden, da ein rollender Alias spätere Modell-Updates mitziehen kann. Für länger laufende Agenten zählt nicht nur die Erfolgsquote, sondern der reale Preis pro abgeschlossener Aufgabe – einschließlich Cache-Treffern, Output, Tool-Nutzung und Wiederholungen.
Was ist neu – und was bleibt gleich?
| Merkmal | DeepSeek V4.1 Flash 1017 | Einordnung |
|---|---|---|
| Veröffentlichung | 17. Oktober 2026 | Offizielles Checkpoint-Update 1 |
| DeepSeek-API-Modell | deepseek-flash | Alias zeigt auf den aktuellen Flash-Stand 2 |
| OpenRouter-Snapshot | deepseek/deepseek-v4.1-flash-1017 | Datierte Auswahl, providerabhängig 3 |
| Kontextfenster | 1.048.576 Token | Konfiguration, nicht Qualitätsgarantie 56 |
| Maximale Ausgabe | 384K Token (393.216) | Provider können enger begrenzen 27 |
| Modalitäten | Text und Bilder als Eingabe, Text als Ausgabe | Kein Bildgenerator 78 |
| Tool Calling | Unterstützt | Reasoning-Verlauf muss korrekt weitergereicht werden 910 |
| Gewichtslizenz | MIT | Vollständiger Checkpoint bleibt groß 411 |
| Tokenpreise | Unverändert | Peak-/Off-Peak getrennt betrachten 12 |
DeepSeek beschreibt eine Verstärkung durch Reinforcement Learning mit Selbstfeedback, vor allem für komplette Projekte von der Planung bis zur Umsetzung. Die Release-Seite illustriert dies mit Projekt- und 3D-Demos. Demos sind kein Ersatz für eine kontrollierte Evaluation. 1
Benchmarks: Wie groß sind die Fortschritte?
| Benchmark | September-V4.1 | 1017 | Änderung |
|---|---|---|---|
| Terminal-Bench 4.0 | 31,2 | 42,3 | +11,1 Punkte |
| ProgramBench | 20,3 | 29,1 | +8,8 |
| Apex Bench v1.1 | 64,6 | 72,1 | +7,5 |
| HLE ohne Tools, vollständiger Satz | 36,8 | 42,6 | +5,8 |
| Automation-Bench v1.0.6 | 54,8 | 60,5 | +5,7 |
| Chartography, mit Tools | 78,9 | 83,0 | +4,1 |
| Agents’ Last Exam | 31,8 | 35,4 | +3,6 |
| BabyVision, mit Tools | 89,6 | 92,5 | +2,9 |
| DeepSWE v1.1 | 74,2 | 77,0 | +2,8 |
| NL2Repo-Bench | 65,4 | 68,2 | +2,8 |
| ZeroBench-main, mit Tools | 49,0 | 51,0 | +2,0 |
Quelle: DeepSeek-Modellkarte vom 17. Oktober 2026. Eigene Subtraktion aus den beiden DeepSeek-Spalten; unterschiedliche Benchmarks, Testeinheiten und teilweise Tool-Setups. Die HLE-Text-only-Teilmenge (44,0 vs. 39,1) wird getrennt ausgewiesen. Terminal-Bench 4.0 wurde laut Karte mit dem Claude-Code-Harness getestet, DeepSWE v1.1 mit Mini-SWE-V2. 4121314
Das Plus von 11,1 Punkten bei Terminal-Bench ist die größte Einzelbewegung. Terminal-Bench untersucht jedoch terminalbasierte Aufgaben unter eigenen Ressourcen- und Bewertungsregeln. Ein Ergebnis daraus belegt weder automatisch bessere Webrecherche noch eine niedrigere Fehlerrate in einem konkreten Agent-Setup. Der Benchmark-Veranstalter betont ausdrücklich die Bedeutung einheitlicher Ressourcen und korrigierter Aufgaben. 12
Was am Veröffentlichungstag fehlt: Eine eigene Testserie mit fixiertem Harness, identischen Aufgaben, mehrfachen Läufen, Gesamt-Tokenkosten und Zeitmessung liegt nicht vor. Die Aussage „schneller und günstiger pro Task” bleibt damit eine Herstellerbehauptung, bis solche Messdaten verfügbar sind.
API-Preise: Cache, Tageszeit und Output getrennt betrachten
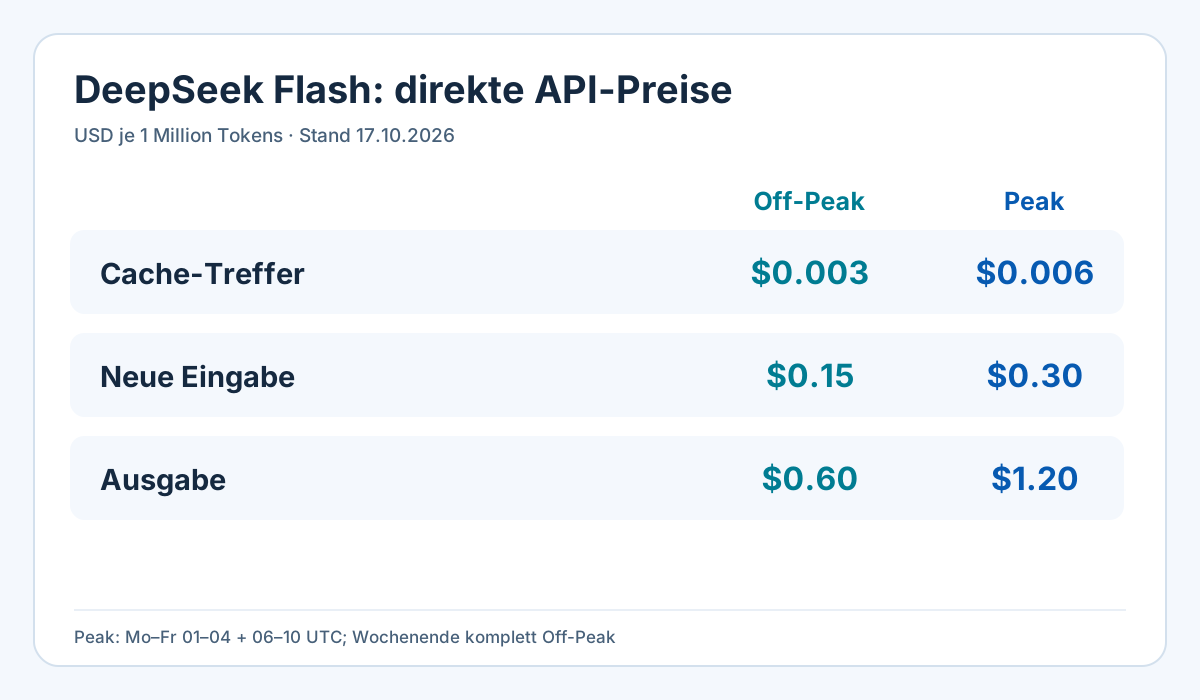
Für die direkte Abrechnung über die DeepSeek-API nennt das offizielle Preisblatt für deepseek-flash folgende US-Dollar-Tarife pro 1 Million Tokens: 2
| Tokenklasse | Off-Peak | Peak |
|---|---|---|
| Eingabe, Cache-Treffer | $0,003 | $0,006 |
| Eingabe, Cache-Fehlschlag | $0,15 | $0,30 |
| Ausgabe | $0,60 | $1,20 |
Peak-Zeiten gelten montags bis freitags 01:00–04:00 und 06:00–10:00 UTC, ausgenommen chinesische Feiertage. Wochenenden und chinesische Feiertage zählen vollständig als Off-Peak. Andere Provider – etwa über OpenRouter – haben eigene, dynamische Preise und Routing-Optionen; deren Listenpreise sind nicht identisch mit der DeepSeek-Direkt-API. Steuern, Wechselkurse und Zusatzdienste sind in den US-Dollar-Listenpreisen nicht enthalten. 23
Drei nachvollziehbare Kostenbeispiele
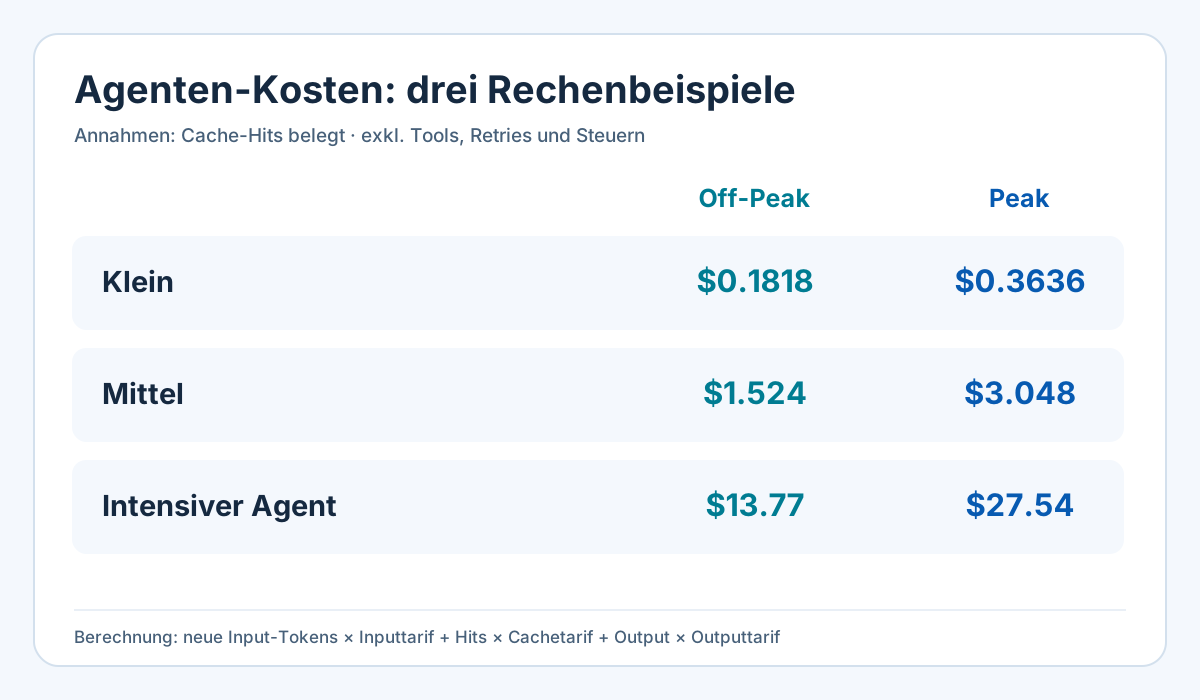
Die Beispiele sind eigene Rechnungen, keine gemessenen Rechnungsbeträge. Annahmen: Cache-Token sind Teil der Gesamteingabe, alle Tokens werden erfolgreich abgerechnet, keine Retries, keine externen Dienste, keine Steuern.
| Nutzungsprofil | Neue Eingabe | Gecachte Eingabe | Ausgabe | Off-Peak | Peak |
|---|---|---|---|---|---|
| Klein | 0,4 Mio. | 0,6 Mio. | 0,2 Mio. | $0,1818 | $0,3636 |
| Mittel | 2 Mio. | 8 Mio. | 2 Mio. | $1,524 | $3,048 |
| Intensiver Agent | 10 Mio. | 90 Mio. | 20 Mio. | $13,77 | $27,54 |
Formel: Kosten = Eingabe_miss_M × Preis_miss + Eingabe_hit_M × Preis_hit + Ausgabe_M × Preis_output. Für das mittlere Szenario Off-Peak: 2 × $0,15 + 8 × $0,003 + 2 × $0,60 = $1,524. Ohne Cache-Treffer wäre derselbe Tokenumfang 10 × $0,15 + 2 × $0,60 = $2,70. Ein identischer Prompt wird allerdings nicht automatisch vollständig als Cache-Treffer abgerechnet: DeepSeek beschreibt Prefix-Regeln, Best-Effort-Caching und begrenzte Cache-Lebensdauer. Tatsächliche Treffer stehen in den usage-Feldern prompt_cache_hit_tokens und prompt_cache_miss_tokens. 15
Zusätzlich hat DeepSeek am 17. Oktober Search- und Fetch-APIs gestartet. Beide kosten regulär $0,75 pro 1.000 erfolgreiche Aufrufe. Für die dokumentierten serverseitigen Tool-Aufrufe über DeepSeek Harness, Claude Code und Codex gilt eine vorübergehende Gebührenfreiheit bis zum angekündigten Abrechnungsbeginn 31. Oktober 2026, 16:00 UTC. Diese Gebühren sind keine Modell-Tokenpreise; andere Suchwerkzeuge können anders abgerechnet werden. 12
Welche Modell-ID ist die richtige?
Direkte DeepSeek-API: deepseek-flash, Basis-URL https://api.deepseek.com. Der Alias zeigt auf die jüngste Flash-Version; eine spätere Modellaktualisierung kann also Ergebnisse verändern. Anthropic-kompatible Endpunkte sind unter https://api.deepseek.com/anthropic verfügbar. 27
OpenRouter: deepseek/deepseek-v4.1-flash-1017 bezeichnet den datierten Checkpoint. Die konkrete Provider-Auswahl beeinflusst Preis, Latenz, Zuverlässigkeit und mögliche Funktionsgrenzen. Eine EU-In-Region-Verfügbarkeit wird auf der sichtbaren OpenRouter-Modellseite ausdrücklich nicht zugesichert. 3
Open Weights: deepseek-ai/DeepSeek-V4.1-Flash-1017 ist das Modell-Repository auf Hugging Face. Das ist kein DeepSeek-API-Name. Es enthält Modellgewichte, Konfiguration und ein separates Inference-README mit Beispielen für lokales Serving. 41617
Minimales Python-Beispiel für die offizielle API
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Prüfe diese Python-Funktion auf Randfälle."}],
    reasoning_effort="high",
    extra_body={"thinking": {"type": "enabled"}},
)
print(response.choices[0].message.content)
print(response.usage)
Dieses Beispiel nutzt die offiziell dokumentierte Chat-Completions-Schnittstelle; es wurde für diesen Artikel nicht live mit einem API-Schlüssel ausgeführt. Für längere Agenten-Schleifen ist die Weitergabe von reasoning_content im Tool-Calling-Modus relevant. Fehlende Reasoning-Nachrichten können Folgefehler verursachen. JSON-Objekt-Ausgabe und strikte Tool-Schema-Validierung sind unterschiedliche Funktionen: json_object gewährleistet gültiges JSON, während strict-Tool-Schemata als Beta-Funktion separat dokumentiert sind. 71018
DeepSeek Harness, Hermes und Codex: Was testen?
DeepSeek empfiehlt für das 1017-Modell DeepSeek Harness v0.2.1-rc.1 oder neuer. Das ist eine Angabe aus der Release-Mitteilung und keine Bestätigung, dass jede Installation, jeder Fork oder jedes Client-Plugin diese Version bereits anbietet. Dokumentiert sind außerdem Integrationen für Codex, Claude Code und weitere Agenten. 11920
Bei einem praktischen Vergleich sollten mindestens vier Dinge unverändert bleiben: Aufgabe, Agent-Version, Tool-Berechtigungen und Bewertung. Zu protokollieren sind zusätzlich Modell-/Provider-ID, Reasoning-Level, Cache-Treffer, Erfolgsquote, Laufzeit, Input-/Output-Tokens, abgebrochene Aufrufe, manuelle Eingriffe und externe Suchkosten. Gerade bei einem Wechsel darf ein neuer Checkpoint nicht mit einem gleichzeitigen Agent-Update verwechselt werden.
Empfohlener Mini-Test: Zehn echte Aufgaben aus demselben Repository (Bugfix mit Tests, kleine Feature-Erweiterung, Refactoring), für September-Version und 1017 jeweils drei unabhängige Durchläufe. Gemessen wird Gesamtkosten / erfolgreich abgeschlossene Aufgabe, zusätzlich der Median der Laufzeit. Veröffentlichung nur mit Logs und klar definiertem Erfolgskriterium. Dies ist ein Testvorschlag, kein bereits durchgeführtes Experiment.
Architektur und Mac-Tauglichkeit
Die zugrunde liegende V4.1-Flash-Familie verwendet einen asymmetrischen Causal-Encoder-Decoder mit Mixture-of-Experts. DeepSeek nennt für die September-Version 552 Milliarden Parameter im Backbone, aber nur etwa 8 Milliarden aktivierte Parameter bei der Eingabeverarbeitung und 16 Milliarden bei der Ausgabe. Das Hugging-Face-Modell-Listing für den Oktober-Checkpoint zeigt insgesamt etwa 763 Milliarden Parameter, weil es weitere Komponenten wie Engram-Speicher einbezieht. Die Werte beschreiben unterschiedliche Zählweisen und sind kein Beleg für ein „16B-Modell”. 2145
Das datierte Hugging-Face-Repository weist ungefähr 510 GB an veröffentlichten Dateien aus. Eine rein rechnerische Untergrenze für 763B Parameter mit idealisierten 4 Bit pro Parameter sind 381,5 GB, ohne Quantisierungs-Metadaten, Laufzeitspeicher, KV-Cache und sonstige Komponenten. Solche Überschlagszahlen sind keine bestätigten Lauffähigkeitsanforderungen. Für übliche Macs bleibt die Cloud-API die realistischere Option. 516
Urteil: Lohnt der Wechsel?
Für Nutzer der DeepSeek-Direkt-API findet der Wechsel faktisch bereits statt: deepseek-flash verweist auf den neuen Checkpoint. Die veröffentlichten Coding-Zuwächse rechtfertigen einen kontrollierten Praxistest, besonders bei längeren Terminal- und Repository-Aufgaben. Ein pauschales „besser als Claude, GPT oder andere Modelle” ist aus der vorliegenden Tabelle nicht ableitbar; die Herstellerwerte hängen von Benchmarks und Harnesses ab.
Der wichtigste nächste Schritt ist ein reproduzierbarer Agenten-Kostenvergleich, nicht noch ein allgemeiner Modellvergleich. Wer die Grundlagen zu Architektur, Cache und lokalem Betrieb sucht, findet sie im bestehenden DeepSeek-V4.1-Flash-Grundlagenartikel. Weitere Details zur alten Pro-Version stehen im V4-Pro-Artikel; dessen Sprache ist derzeit Englisch.
Transparenzhinweis: Recherche anhand verlinkter Herstellerdokumentation, Modellkarte, Benchmark-Projektdokumentationen und externer Einordnungen. Keine Sponsoring- oder Affiliate-Verbindung zu DeepSeek behauptet; etwaige tatsächlich bestehende Beziehungen wären vor Veröffentlichung gesondert offenzulegen. Korrekturen über die Kontaktseite von AI on Mac.
Quellen und Belege
Footnotes
Häufig gestellte Fragen
Wann ist DeepSeek V4.1 Flash 1017 erschienen?
Am 17. Oktober 2026. Der neue Checkpoint ersetzt die September-Version hinter dem API-Alias `deepseek-flash` und ist zusätzlich als datierter Snapshot `deepseek/deepseek-v4.1-flash-1017` auf OpenRouter gelistet.
Was kostet DeepSeek V4.1 Flash 1017 pro 1 Million Tokens?
Die DeepSeek-Direkt-API nimmt unverändert $0,003 (Cache-Hit, Off-Peak), $0,15 (Cache-Miss, Off-Peak) und $0,60 (Output, Off-Peak) pro 1 Million Tokens. Peak-Zeiten verdoppeln diese Werte; OpenRouter-Preise sind separat zu prüfen.
Sind die Benchmark-Zuwächse unabhängig bestätigt?
Nein. Die Tabelle stammt aus DeepSeeks eigener Modellkarte vom 17. Oktober 2026 und wurde von uns nicht unabhängig repliziert. Die Subtraktionen sind eigene Rechnungen, die Methodik-Einschränkungen dokumentiert.
Wie viel Kontext und Output unterstützt das Modell?
Die Konfiguration setzt `max_position_embeddings` auf 1.048.576 Token. Die offizielle Pricing-Seite nennt zusätzlich eine maximale Ausgabe von 384K Token (entspricht 393.216 Token).
Kann DeepSeek V4.1 Flash 1017 lokal auf einem normalen Mac laufen?
Die veröffentlichten Gewichte umfassen mehrere Hundert Gigabyte; bei idealisierten 4 Bit pro Parameter ergibt sich für den vollen 763B-Checkpoint rechnerisch etwa 381 GB. Für normale Macs bleibt die Cloud-API der realistische Weg.
Welche Agent-Version empfiehlt DeepSeek?
Laut Release-Mitteilung vom 17. Oktober 2026 wird DeepSeek Harness v0.2.1-rc.1 oder neuer empfohlen. Codex, Claude Code und weitere Integrationen sind dokumentiert, aber nicht von uns live getestet.